
推进数据中心可持续发展
高能效长期以来是 AMD 产品设计的核心原则,与 AMD 技术发展规划与产品战略深度契合。十余年来,我们坚持制定并公开具有时限性的能效目标,致力于大幅提升各种产品的能效表现,而且始终如期达到甚至超越所制定的目标。
随着 AI 部署规模持续扩展,我们加速设计打造覆盖全面的端到端 AI 系统,这使得对创新型能效解决方案的需求日益增长,而这一需求在数据中心领域或许更为迫切。
AMD AI 系统 20 倍机架级能效提升目标

*仅供参考之用。详情参见附注中的数据表。
AMD 设立了一个极具突破性的新目标:以 2024 年为基准年,到 2030 年,将 AI 训练与推理场景下的机架级能效提升 20 倍。1 据 AMD 估计,这一提升幅度是 2018 年至 2025 年行业平均能效提升水平的近 3 倍之多。这一目标基于我们的全新设计与发展规划而设定,体现了整个机架层面的性能功耗比优化,涵盖 CPU、GPU、内存、网络、存储以及软硬件协同设计。这种从节点级到机架级的能效优化跃迁,由我们快速演进的端到端 AI 战略所驱动,现已成为以更可持续的方式推进数据中心 AI 部署扩展的关键所在。
进展更新:据 AMD 估计,从 2024 年到 2026 年,AI 训练与推理场景下的机架级能效可提升 4 倍2。
效益
机架级能效实现 20 倍提升,达到此前行业平均能效提升水平的近 3 倍之多,具有重大意义。基于代表性的 AI 训练工作负载,AMD 预计到 2030 年,其机架级能效提升将带来以下两项相关收益3:
- 相同算力,更少资源消耗:2030 年,预计约两 (2) 个 AMD 机架即可提供与 2024 年 570 个机架相同的算力。这将使相关使用阶段的耗电量减少 20 倍,碳排放强度降低 28 倍。
- 更多算力,相同能耗:反之,能效提升后,预计可在消耗相同能源的情况下,实现 20 倍的算力增长(以单位功耗每秒浮点运算次数衡量)。
上述预测基于 AMD 芯片与系统设计规划,以及经过能效专家 Jonathan Koomey 博士验证的测量方法。
AMD 30x25 能效目标
*仅供参考之用。详情参见附注中的数据表。
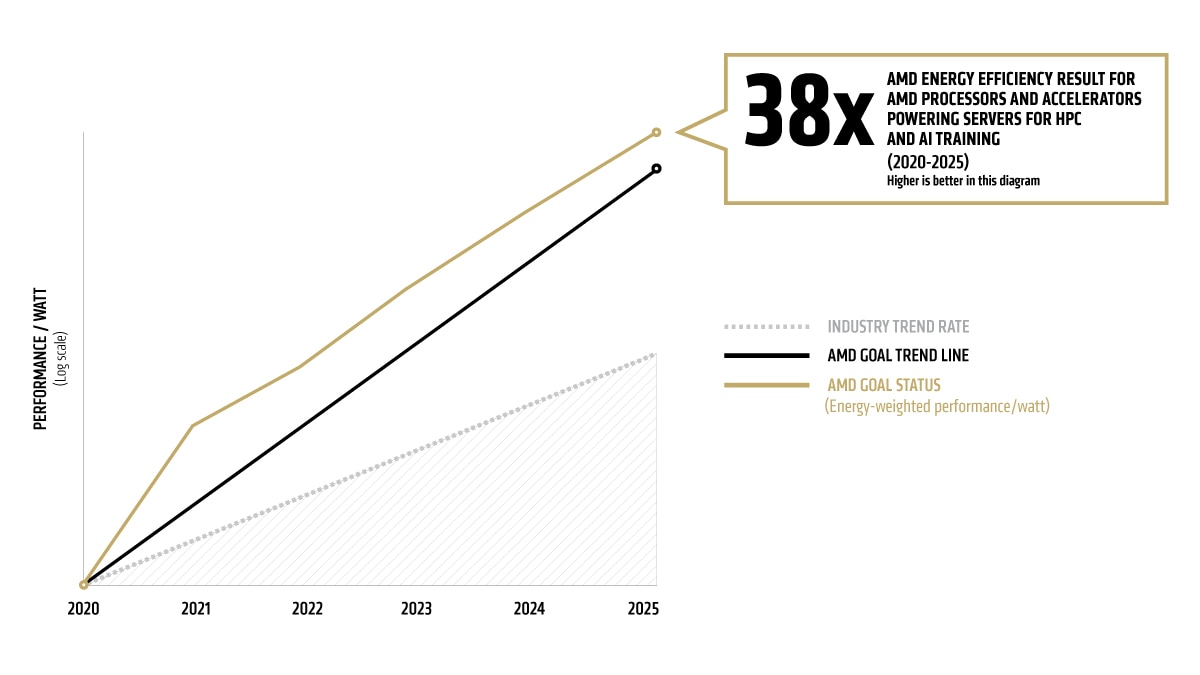
2025 年,AMD 已超额完成 30x25 目标,即在 2020 年至 2025 年间,将用于 AI 训练和高性能计算的节点能效提升 30 倍。4 这一目标的实现意味着,AMD 的能效提升速度比 2015 年至 2020 年间行业整体能效提升速度快了 2.5 倍以上。一个配置了四块 AMD Instinct GPU 和一颗第五代 AMD EPYC(霄龙)CPU 的系统,其能效比基准系统提升了 38 倍。5 这意味着在实现同等性能的前提下,目标周期内的能耗降低了 97%。架构创新与性能功耗比优化,推动了我们在 CPU 和 GPU 产品线中取得这些卓越成果。
成功案例
支持资源
- 详细了解 AMD Instinct 加速器
- 详细了解 AMD 企业责任
附注
AMD 基于发展路线图规划了 2024 至 2030 年间每年针对 AI 训练/推理的先进机架设计方案,同时通过深度剖析行业发展趋势,为机架设计方案与技术迭代优化提供支持,确保规划的目标与行业发展轨迹高度契合。2024 年的机架基于 MI300X 节点,反映了 2024/2025 年期间典型的 AI 部署情况。2030 年的机架将基于 AMD 2030 年的系统与芯片设计规划。AMD 指定了 GPU、CPU、DRAM、网络交换机、存储、散热和通信等组件,并基于自身经验及观察到的客户部署情况,结合 GPU、CPU、DRAM 和纵向扩展交换机的规格表内功耗值,对各项组件及整机架的功耗和性能特征进行追踪。能效计算不包括机架外部风冷/水冷系统的功耗,但包含机架内部风扇及泵的功耗。当无法通过规格表获取功耗值时,则由首席技术专家基于工程经验进行估算。年度性能提升幅度基于计算输出(实际交付的持续性能,而非峰值 FLOPS)、峰值内存 (HBM) 带宽以及网络(纵向扩展)带宽的变化情况进行估算,以指数形式呈现,并针对训练与推理场景采用表 1 中的权重因子进行加权计算;这些权重因子已于 2026 财年结合最新机架配置与模型运行表现完成更新。这些权重因子涵盖各项指标的交互影响,并反映了客户运行典型 AI 工作负载的实际部署情况。这些估算均基于 AMD 机架级性能建模。
表 1:GPU 性能驱动因素的权重因子
FLOPS
HBM 带宽
扩展带宽
训练
70%
10%
20%
推理
35%
50%
15%
对于每块 GPU 在不同精度级别下的实测每秒浮点运算次数 (FLOPs),AMD 采用公开发布的最高可实现 FLOPs (MAF)。这些性能指标值由 AMD 按照自有基准测试协议进行测量。对于每块 GPU 的 HBM 和扩展带宽,AMD 采用 AMD.com 上发布的器件产品数据手册中的峰值数据。实际输出数值通常偏差在 10% 以内,因此出于比较目的(代际提升),使用峰值数据预计能够保障合理的准确性。测得的每秒浮点运算次数 (FLOPs) 基于以下假设:AI 模型在训练和推理过程中持续通过采用更低精度的数学格式取得进展,这不仅能增加有效 FLOPs,还能降低每次浮点运算所需的能耗。训练场景下的精度演进趋势基于 Epoch.ai 数据 (https://epoch.ai/data-insights/training-precision) 进行推算。推理场景下的演进趋势由工程团队结合行业指导信息研判确定。
首先,每个机架的性能和功耗共同揭示了训练和推理任务中性能功耗比随时间变化的趋势。然后,将训练和推理的进展指数按 50:50 的权重进行加权,从而得出 AMD 到 2030 年预计进展(20 倍)的最终估算值。
我们委托 Koomey 博士负责分析计算性能和功耗方面的历史行业数据以及 AMD 的预测数据。随后,我们邀请了 Koomey 博士来完善目标评估方法,使其与业界公认的能效评估最佳实践保持一致。该方法论使我们能够将自身目标与行业的历史成果进行比较,持续追踪我们实现该目标的进展,并估算在实际 AI 部署中达成目标所带来的环境效益。
为了估算基于 AMD 器件的机架配置在性能功耗比方面的发展趋势,我们每年都会对客户配置的典型机架中各组件的功耗及加权后的性能进行估算。AMD 指定了 GPU、CPU、DRAM、网络交换机、存储、散热和通信等组件,并基于自身经验及观察到的客户部署情况,结合 GPU、CPU、DRAM 和纵向扩展交换机的规格表内功耗值,对各项组件及整机架的功耗和性能特征进行追踪。能效计算不包括机架外部风冷/水冷系统的功耗,但包含机架内部风扇及泵的功耗。当无法通过规格表获取功耗值时,则由首席技术专家基于工程经验进行估算。然后,我们将性能指数除以功耗(瓦特)指数(均以 2024 基准年机架为参照),从而得出性能功耗比提升指数。
表 1 展示了按精度划分的浮点运算次数随时间的变化趋势,参考了 Epoch.ai 的趋势数据。2024 年和 2025 年的数据来源于趋势表,2026 年的数值则根据趋势表推算得出。推理数值基于行业趋势和工程研判进行估算。
表 1:按精度划分的浮点运算占比(参考 Epoch.ai)
MI300X (2024)
MI355X (2025)
MI455X (2026)
训练
推理
训练
推理
训练
推理
BF16 浮点运算占比
93%
66%
84%
38%
65%
15%
FP8 浮点运算占比
7%
34%
16%
48%
32%
45%
FP4 浮点运算占比
0%
0%
0%
15%
3%
40%
新精度格式浮点运算占比
0%
0%
0%
0%
0%
0%
表 2 反映了目标达成进度,将我们的目标趋势线与每款 AI 加速器模型的现状进行了对比。基准(2024 年)机架采用 AMD MI300X AI 节点,2025 年机架基于 AMD MI355X,2026 年机架则基于 AMD MI455X。每一代机架均代表相应时间段内 AI 部署中常见的 GPU 产品。MI300X 和 MI355X 的目标达成情况,是基于各 GPU 在不同精度级别下公开发布的实测最大浮点运算性能进行计算。截至本报告发布时(2026 年 8 月中旬),MI455X 的全面性能数据尚不可用,因此在经首席技术专家批准的情况下采用了实测最大每秒浮点运算次数与建模数据相结合的方式进行估算。AMD 预计最终实测结果与建模估算值的偏差将在 5% 以内;在收到最终实测数据后,将会对 2026 年目标达成情况进行验证确认。
表 2:目标达成进度
2024
2025
2026
2027
2028
2029
2030
目标趋势线
1.0
1.9
3.2
5.2
8.4
12.3
20
AMD 目标状态
1.0
1.7
4.0
AMD Instinct GPU
MI300X
MI355X
MI455X
为了估算 2025 年训练一个典型 AI 模型所需的机架数量,我们基于 Epoch.ai 关于知名模型随时间累计算力需求的数据 (https://epoch.ai/) 做出如下假设:在 2025 年训练一个典型模型所需完成的运算量为 9.87x10^24 次(基于数据回归分析),且训练周期为两周。根据 AMD 路线图给出的计算性能估算结果表明,在上述假设下,使用 2024 年机架在两周内训练一个典型模型大约需要 570 个机架;而到 2030 年,训练同一模型仅需约 2 个机架。上述计算结果表明,在这六年期间,训练同一模型所需的机架数量减少了约 300 倍。
由于每个机架的功率密度随时间递增,产生固定算力所消耗的总功率预计将下降 20 倍。在 2024 年机架配置下,MI300X 系统训练指定的 2025 年 AI 模型所消耗的电量约为 9.0 吉瓦时 (GWh),而 2030 年的全新 AMD 系统训练同一模型所消耗的电量约为 450 兆瓦时 (MWh),降幅高达 95%。
除了完成代表性任务所用电量大幅减少外,还假设电力生产的碳排放强度将随时间推移逐步降低。综合考虑这两方面因素,该算力水平对应的碳排放量预计在 2024 年至 2030 年间将下降 28 倍。在此次计算中,AMD 采用国际能源署 (IEA) 在《2024 年世界能源展望》报告 [https://www.iea.org/reports/world-energy-outlook-2024] 中发布的每千瓦时碳排放强度值作为基准。IEA 在既定政策情景分析中给出了 2023 年和 2030 年的碳强度值。我们计算了 2023 年至 2030 年碳强度的年均变化量,并将其应用于 2023 年的碳强度值,据此得出 2024 年碳强度为 434 克二氧化碳/千瓦时 (CO₂ g/kWh),而 2030 年碳强度为 312 CO₂ g/kWh。2024 年基准场景下,排放量为 9 GWh x 434 CO2 g/kWh,约等于 3900 吨二氧化碳;而在 2030 年场景下,排放量为 450 MWh x 312 CO2 g/kWh,约等于 140 吨二氧化碳。
在四加速器 CPU 主机配置中采用适合 AI 训练和高性能计算的高性能 CPU 和 GPU 加速器。目标计算基于标准性能指标得出的性能分数(高性能计算:具有 4k 矩阵大小的 Linpack DGEMM kernel FLOPS;AI 训练:在 4k 矩阵上运行的专用低精度训练浮点数学运算 GEMM kernel),除以一个典型的加速计算节点(包括 CPU 主机 + 内存以及 4 个 GPU 加速器)的额定功耗。
EPYC-030B:AMD 在四加速器 CPU 主机配置中对适合 AI 训练和高性能计算的高性能 AMD CPU 和 GPU 加速器进行计算节点性能功耗比测量。
高性能计算工作负载的性能基于具有 4k 矩阵大小的 Linpack DGEMM kernel FLOPS。AI 训练的性能基于在 4k 矩阵上运行的低精度训练浮点数学 GEMM kernel,例如 FP16 或 BF16 FLOPS。
功耗基于一个典型的加速计算节点(包括 CPU 主机 + 内存以及 4 个 GPU 加速器)的热设计功耗 (TDP)。
为了使该目标与全球能源使用量密切相关,AMD 与 Koomey Analytics 合作评估可用的研究和数据,其中包括 GPU 高性能计算 (HPC) 和机器学习 (ML) 等特定领域数据中心能源使用效率 (PUE)。AMD CPU 和 GPU 节点功耗包含特定领域使用(活动与空闲)百分比,并乘以 PUE 来确定实际总能耗,从而能够计算出性能功耗比。
能耗基准采用 2015-2020 年数据中观察到的行业单位作业能耗提升率,并根据这一变化率推测至 2025 年。AMD 目标趋势线(表 1)显示到 2025 年实现能效提升 30 倍目标所需的指数级提升。AMD 实际发布产品(表 2)是表 1 AMD 目标能效提升的来源。
2020 年到 2025 年各领域单位作业能耗提升值是由全球预计销量加权得出(根据 IDC - Q1 2021 TrackerHyperion- Q4 2020 Tracker Hyperion 高性能计算市场分析,2021 年 4 月)。将这些销量换算到机器学习训练和高性能计算市场,会得出如下表 3 所示的节点量。然后将这些节点量乘以 2025 年各计算领域的典型能源消耗 (TEC)(表 4),得出一个有意义的全球实际能源使用提升的总体指标。
表 1:预计到 2025 年的能效数据汇总
2020
2021
2022
2023
2024
2025
目标趋势线
1.00
1.97
3.98
7.70
15.20
30.00
AMD 目标状态(能耗加权后的性能功耗比)
1.00
3.90
6.79
13.49
28.29
37.85
表 2:AMD 产品
2020
2021
2022
2023
2024
2025
EPYC(霄龙)第一代 CPU + M50 GPU
EPYC(霄龙)第二代 CPU + MI100 GPU
EPYC(霄龙)第三代 CPU + MI250 GPU
MI300A APU(搭载 AMD CDNA 3 计算单元的第四代 AMD EPYC(霄龙)CPU)
EPYC(霄龙)第五代 CPU + MI300X GPU
EPYC(霄龙)第五代 CPU + MI355X GPU
*AMD 产品受最新软件支持,包括 AMD ROCm。
表 3:预测销量(百万/年)
2020
2021
2022
2023
2024
2025
高性能计算 GPU 节点销量
0.05
0.06
0.07
0.09
0.10
0.12
机器学习 GPU 节点销量
0.09
0.10
0.12
0.14
0.17
0.20
表 4:2025 年基准情景所售产品用电量,用于加权能效指数(TWh/年)
2025
基准高性能计算
4.49
基准机器学习
29.79
总体基准
34.28
*随着高性能计算和机器学习计算节点的功能不断发展,我们将自 2025 年起,在原有预测的基础上每年更新全球能耗估算数据,同时将 AI 发展给机器学习性能指标带来的权重提升纳入其中。
附注
AMD 基于发展路线图规划了 2024 至 2030 年间每年针对 AI 训练/推理的先进机架设计方案,同时通过深度剖析行业发展趋势,为机架设计方案与技术迭代优化提供支持,确保规划的目标与行业发展轨迹高度契合。2024 年的机架基于 MI300X 节点,反映了 2024/2025 年期间典型的 AI 部署情况。2030 年的机架将基于 AMD 2030 年的系统与芯片设计规划。AMD 指定了 GPU、CPU、DRAM、网络交换机、存储、散热和通信等组件,并基于自身经验及观察到的客户部署情况,结合 GPU、CPU、DRAM 和纵向扩展交换机的规格表内功耗值,对各项组件及整机架的功耗和性能特征进行追踪。能效计算不包括机架外部风冷/水冷系统的功耗,但包含机架内部风扇及泵的功耗。当无法通过规格表获取功耗值时,则由首席技术专家基于工程经验进行估算。年度性能提升幅度基于计算输出(实际交付的持续性能,而非峰值 FLOPS)、峰值内存 (HBM) 带宽以及网络(纵向扩展)带宽的变化情况进行估算,以指数形式呈现,并针对训练与推理场景采用表 1 中的权重因子进行加权计算;这些权重因子已于 2026 财年结合最新机架配置与模型运行表现完成更新。这些权重因子涵盖各项指标的交互影响,并反映了客户运行典型 AI 工作负载的实际部署情况。这些估算均基于 AMD 机架级性能建模。
表 1:GPU 性能驱动因素的权重因子
FLOPS
HBM 带宽
扩展带宽
训练
70%
10%
20%
推理
35%
50%
15%
对于每块 GPU 在不同精度级别下的实测每秒浮点运算次数 (FLOPs),AMD 采用公开发布的最高可实现 FLOPs (MAF)。这些性能指标值由 AMD 按照自有基准测试协议进行测量。对于每块 GPU 的 HBM 和扩展带宽,AMD 采用 AMD.com 上发布的器件产品数据手册中的峰值数据。实际输出数值通常偏差在 10% 以内,因此出于比较目的(代际提升),使用峰值数据预计能够保障合理的准确性。测得的每秒浮点运算次数 (FLOPs) 基于以下假设:AI 模型在训练和推理过程中持续通过采用更低精度的数学格式取得进展,这不仅能增加有效 FLOPs,还能降低每次浮点运算所需的能耗。训练场景下的精度演进趋势基于 Epoch.ai 数据 (https://epoch.ai/data-insights/training-precision) 进行推算。推理场景下的演进趋势由工程团队结合行业指导信息研判确定。
首先,每个机架的性能和功耗共同揭示了训练和推理任务中性能功耗比随时间变化的趋势。然后,将训练和推理的进展指数按 50:50 的权重进行加权,从而得出 AMD 到 2030 年预计进展(20 倍)的最终估算值。
我们委托 Koomey 博士负责分析计算性能和功耗方面的历史行业数据以及 AMD 的预测数据。随后,我们邀请了 Koomey 博士来完善目标评估方法,使其与业界公认的能效评估最佳实践保持一致。该方法论使我们能够将自身目标与行业的历史成果进行比较,持续追踪我们实现该目标的进展,并估算在实际 AI 部署中达成目标所带来的环境效益。
为了估算基于 AMD 器件的机架配置在性能功耗比方面的发展趋势,我们每年都会对客户配置的典型机架中各组件的功耗及加权后的性能进行估算。AMD 指定了 GPU、CPU、DRAM、网络交换机、存储、散热和通信等组件,并基于自身经验及观察到的客户部署情况,结合 GPU、CPU、DRAM 和纵向扩展交换机的规格表内功耗值,对各项组件及整机架的功耗和性能特征进行追踪。能效计算不包括机架外部风冷/水冷系统的功耗,但包含机架内部风扇及泵的功耗。当无法通过规格表获取功耗值时,则由首席技术专家基于工程经验进行估算。然后,我们将性能指数除以功耗(瓦特)指数(均以 2024 基准年机架为参照),从而得出性能功耗比提升指数。
表 1 展示了按精度划分的浮点运算次数随时间的变化趋势,参考了 Epoch.ai 的趋势数据。2024 年和 2025 年的数据来源于趋势表,2026 年的数值则根据趋势表推算得出。推理数值基于行业趋势和工程研判进行估算。
表 1:按精度划分的浮点运算占比(参考 Epoch.ai)
MI300X (2024)
MI355X (2025)
MI455X (2026)
训练
推理
训练
推理
训练
推理
BF16 浮点运算占比
93%
66%
84%
38%
65%
15%
FP8 浮点运算占比
7%
34%
16%
48%
32%
45%
FP4 浮点运算占比
0%
0%
0%
15%
3%
40%
新精度格式浮点运算占比
0%
0%
0%
0%
0%
0%
表 2 反映了目标达成进度,将我们的目标趋势线与每款 AI 加速器模型的现状进行了对比。基准(2024 年)机架采用 AMD MI300X AI 节点,2025 年机架基于 AMD MI355X,2026 年机架则基于 AMD MI455X。每一代机架均代表相应时间段内 AI 部署中常见的 GPU 产品。MI300X 和 MI355X 的目标达成情况,是基于各 GPU 在不同精度级别下公开发布的实测最大浮点运算性能进行计算。截至本报告发布时(2026 年 8 月中旬),MI455X 的全面性能数据尚不可用,因此在经首席技术专家批准的情况下采用了实测最大每秒浮点运算次数与建模数据相结合的方式进行估算。AMD 预计最终实测结果与建模估算值的偏差将在 5% 以内;在收到最终实测数据后,将会对 2026 年目标达成情况进行验证确认。
表 2:目标达成进度
2024
2025
2026
2027
2028
2029
2030
目标趋势线
1.0
1.9
3.2
5.2
8.4
12.3
20
AMD 目标状态
1.0
1.7
4.0
AMD Instinct GPU
MI300X
MI355X
MI455X
为了估算 2025 年训练一个典型 AI 模型所需的机架数量,我们基于 Epoch.ai 关于知名模型随时间累计算力需求的数据 (https://epoch.ai/) 做出如下假设:在 2025 年训练一个典型模型所需完成的运算量为 9.87x10^24 次(基于数据回归分析),且训练周期为两周。根据 AMD 路线图给出的计算性能估算结果表明,在上述假设下,使用 2024 年机架在两周内训练一个典型模型大约需要 570 个机架;而到 2030 年,训练同一模型仅需约 2 个机架。上述计算结果表明,在这六年期间,训练同一模型所需的机架数量减少了约 300 倍。
由于每个机架的功率密度随时间递增,产生固定算力所消耗的总功率预计将下降 20 倍。在 2024 年机架配置下,MI300X 系统训练指定的 2025 年 AI 模型所消耗的电量约为 9.0 吉瓦时 (GWh),而 2030 年的全新 AMD 系统训练同一模型所消耗的电量约为 450 兆瓦时 (MWh),降幅高达 95%。
除了完成代表性任务所用电量大幅减少外,还假设电力生产的碳排放强度将随时间推移逐步降低。综合考虑这两方面因素,该算力水平对应的碳排放量预计在 2024 年至 2030 年间将下降 28 倍。在此次计算中,AMD 采用国际能源署 (IEA) 在《2024 年世界能源展望》报告 [https://www.iea.org/reports/world-energy-outlook-2024] 中发布的每千瓦时碳排放强度值作为基准。IEA 在既定政策情景分析中给出了 2023 年和 2030 年的碳强度值。我们计算了 2023 年至 2030 年碳强度的年均变化量,并将其应用于 2023 年的碳强度值,据此得出 2024 年碳强度为 434 克二氧化碳/千瓦时 (CO₂ g/kWh),而 2030 年碳强度为 312 CO₂ g/kWh。2024 年基准场景下,排放量为 9 GWh x 434 CO2 g/kWh,约等于 3900 吨二氧化碳;而在 2030 年场景下,排放量为 450 MWh x 312 CO2 g/kWh,约等于 140 吨二氧化碳。
在四加速器 CPU 主机配置中采用适合 AI 训练和高性能计算的高性能 CPU 和 GPU 加速器。目标计算基于标准性能指标得出的性能分数(高性能计算:具有 4k 矩阵大小的 Linpack DGEMM kernel FLOPS;AI 训练:在 4k 矩阵上运行的专用低精度训练浮点数学运算 GEMM kernel),除以一个典型的加速计算节点(包括 CPU 主机 + 内存以及 4 个 GPU 加速器)的额定功耗。
EPYC-030B:AMD 在四加速器 CPU 主机配置中对适合 AI 训练和高性能计算的高性能 AMD CPU 和 GPU 加速器进行计算节点性能功耗比测量。
高性能计算工作负载的性能基于具有 4k 矩阵大小的 Linpack DGEMM kernel FLOPS。AI 训练的性能基于在 4k 矩阵上运行的低精度训练浮点数学 GEMM kernel,例如 FP16 或 BF16 FLOPS。
功耗基于一个典型的加速计算节点(包括 CPU 主机 + 内存以及 4 个 GPU 加速器)的热设计功耗 (TDP)。
为了使该目标与全球能源使用量密切相关,AMD 与 Koomey Analytics 合作评估可用的研究和数据,其中包括 GPU 高性能计算 (HPC) 和机器学习 (ML) 等特定领域数据中心能源使用效率 (PUE)。AMD CPU 和 GPU 节点功耗包含特定领域使用(活动与空闲)百分比,并乘以 PUE 来确定实际总能耗,从而能够计算出性能功耗比。
能耗基准采用 2015-2020 年数据中观察到的行业单位作业能耗提升率,并根据这一变化率推测至 2025 年。AMD 目标趋势线(表 1)显示到 2025 年实现能效提升 30 倍目标所需的指数级提升。AMD 实际发布产品(表 2)是表 1 AMD 目标能效提升的来源。
2020 年到 2025 年各领域单位作业能耗提升值是由全球预计销量加权得出(根据 IDC - Q1 2021 TrackerHyperion- Q4 2020 Tracker Hyperion 高性能计算市场分析,2021 年 4 月)。将这些销量换算到机器学习训练和高性能计算市场,会得出如下表 3 所示的节点量。然后将这些节点量乘以 2025 年各计算领域的典型能源消耗 (TEC)(表 4),得出一个有意义的全球实际能源使用提升的总体指标。
表 1:预计到 2025 年的能效数据汇总
2020
2021
2022
2023
2024
2025
目标趋势线
1.00
1.97
3.98
7.70
15.20
30.00
AMD 目标状态(能耗加权后的性能功耗比)
1.00
3.90
6.79
13.49
28.29
37.85
表 2:AMD 产品
2020
2021
2022
2023
2024
2025
EPYC(霄龙)第一代 CPU + M50 GPU EPYC(霄龙)第二代 CPU + MI100 GPU
EPYC(霄龙)第三代 CPU + MI250 GPU MI300A APU(搭载 AMD CDNA 3 计算单元的第四代 AMD EPYC(霄龙)CPU)
EPYC(霄龙)第五代 CPU + MI300X GPU
EPYC(霄龙)第五代 CPU + MI355X GPU
*AMD 产品受最新软件支持,包括 AMD ROCm。
表 3:预测销量(百万/年)
2020
2021
2022
2023
2024
2025
高性能计算 GPU 节点销量
0.05
0.06
0.07
0.09
0.10
0.12
机器学习 GPU 节点销量
0.09
0.10
0.12
0.14
0.17
0.20
表 4:2025 年基准情景所售产品用电量,用于加权能效指数(TWh/年)
2025
基准高性能计算
4.49
基准机器学习
29.79
总体基准
34.28
*随着高性能计算和机器学习计算节点的功能不断发展,我们将自 2025 年起,在原有预测的基础上每年更新全球能耗估算数据,同时将 AI 发展给机器学习性能指标带来的权重提升纳入其中。