

Reinventar las redes para cargas de trabajo de IA
Adéntrate en el futuro de los centros de datos diseñados específicamente para cargas de trabajo de IA con las soluciones de red abiertas AMD Pensando™, un conjunto innovador de productos de alto rendimiento, programables y abiertos que mejoran y optimizan la red de extremo a extremo.



Las DPU AMD Pensando™ impulsan la red de front-end
Acelera el movimiento de datos y los servicios de infraestructura a velocidad de cable, lo que libera recursos de la CPU para las cargas de trabajo de IA.
Redes de escalabilidad vertical para cargas de trabajo de IA en evolución
Los modelos de IA modernos han superado la capacidad de una sola GPU. Las redes de escalabilidad vertical conectan varias GPU dentro de un sistema o rack para formar un único dominio de procesamiento, lo que proporciona el ancho de banda ultraalto y la baja latencia que exigen las cargas de trabajo a gran escala, como la IA agéntica.


Escalabilidad horizontal con AI NIC
Cuando las cargas de trabajo de IA se extienden a través de servidores, racks y centros de datos, la conectividad fluida de GPU a GPU se vuelve fundamental. La tecnología AMD AI NIC™ impulsa la sincronización de alta velocidad que requiere la IA a gran escala.
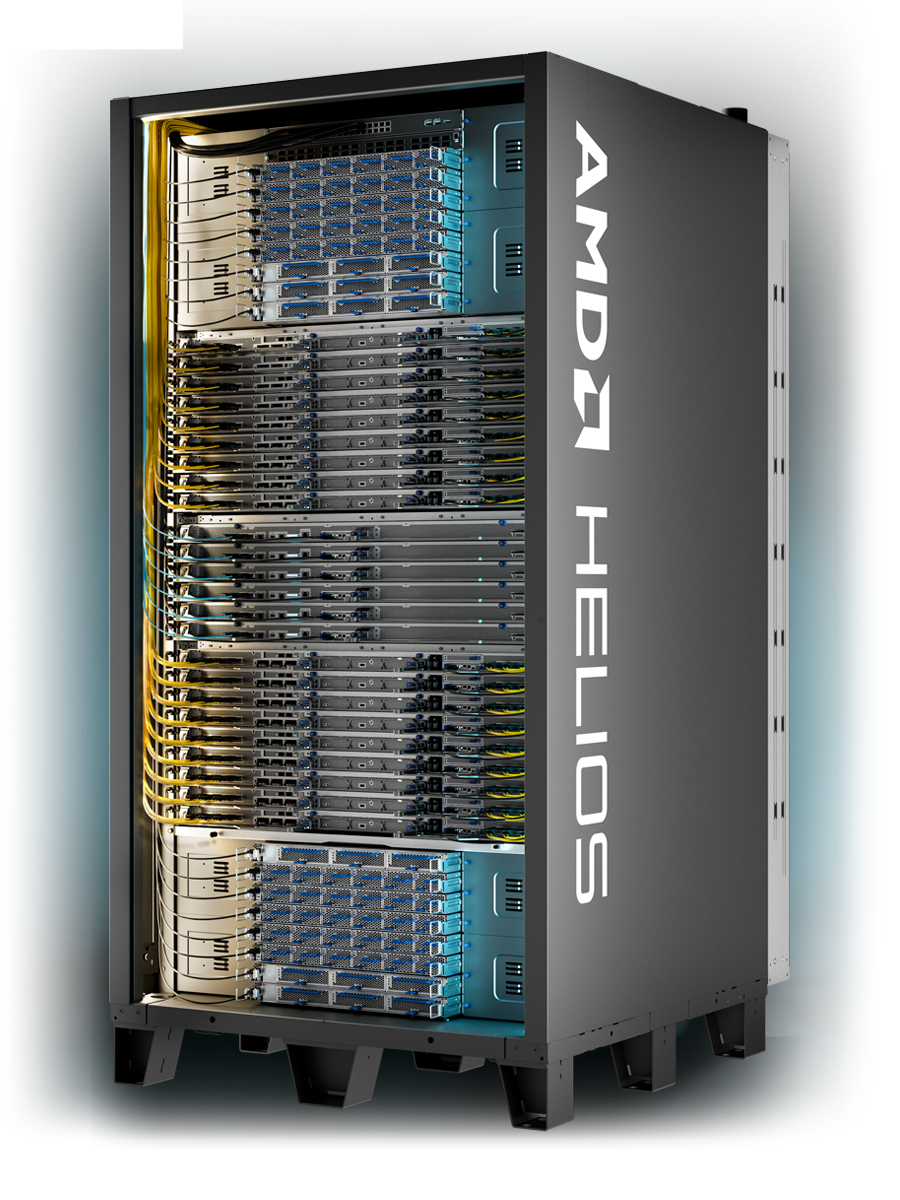
AMD Helios: Rendimiento del rack líder en la industria para IA a hiperescala1
El diseño de la solución de escala de rack AMD Helios es una infraestructura de IA totalmente integrada que combina las últimas GPU AMD Instinct™, CPU para servidores AMD EPYC™ y redes AMD Pensando™, desarrollada a partir de estándares abiertos de la industria para permitir la inferencia a gran escala, el entrenamiento de modelos de vanguardia y el ajuste fino.
AI NIC AMD Pensando™ Vulcano 800
Realice tareas de IA hasta un 13 % más rápido2 con la única tarjeta de red para IA del mercado que admite hasta 2,4 Tbps de ancho de banda de escalabilidad horizontal por GPU.


Habilitación de redes de escalabilidad horizontal listas para IA para cargas de trabajo de IA
Descubre cómo las redes de escalabilidad horizontal mejoran la utilización de las GPU, aceleran las tareas de IA y reducen el costo de escalar la infraestructura de IA.
Adaptadores y CPU
El mundo opera con los adaptadores de red de baja latencia AMD Solarflare™
Chip, software y adaptadores diseñados específicamente para los mercados de capitales
9 de cada 10 bolsas de valores globales utilizan soluciones Solarflare para el comercio3


Procesadores AMD x86 Embedded
Los procesadores AMD x86 Embedded ofrecen procesamiento de alto rendimiento, E/S sólida y escalabilidad para aplicaciones como firewalls, enrutadores y dispositivos de red, lo que brinda rendimiento, eficiencia y confiabilidad a largo plazo en el perímetro o el centro de datos.

Recursos
Diseñamos la red con estándares abiertos para lograr un alto rendimiento a cualquier escala
Notas al pie
- Cálculos realizados por los laboratorios de rendimiento de AMD en junio del 2025, basados en la capacidad de memoria/ancho de banda proyectado y las especificaciones de ancho de banda de escalabilidad horizontal/vertical del AMD Instinct™ MI455X 72xGPU “Helios” AI Rack frente al NVIDIA “Vera Rubin” 72xGPU “Oberon” Rack anunciado públicamente. Los fabricantes de servidores pueden variar las configuraciones, lo que arroja resultados diferentes. MI350-045A
Cálculos realizados por los laboratorios de rendimiento de AMD en septiembre del 2025, basados en los tipos de datos FP8/FP4 y las especificaciones proyectadas para el rack de IA “Helios” de 72 GPU AMD Instinct™ MI455X frente a las especificaciones anunciadas públicamente para el rack de IA “Oberon” de 72 GPU NVIDIA “Vera Rubin”. Los resultados reales basados en silicio para producción pueden variar. Los fabricantes de servidores pueden variar las configuraciones, lo que arroja resultados diferentes. MI350-046B
- Con base en el modelado de silicio de AMD Engineering y la simulación de la evaluación comparativa sintética de AMD, utilizando la evaluación comparativa MOE_4p5T hi_sparsity_ea9 para proyectar la aceleración del tiempo de solución en días utilizando el tipo de datos de entrenamiento FP8 en un sistema LLM simulado modelado con 8000 GPU AMD Instinct MI455X y (3) versus (2) NIC AMD Pensando Vulcano.
Los resultados reflejan el análisis del procesamiento puro de entrenamiento (solo capas de decodificación). Configuración evaluada con un tamaño de lote global de 4096 y una longitud de secuencia de 4K, utilizando la activación SwiGLU. Los resultados excluyen los costos adicionales de evaluación y creación de puntos de control. Se supone FlashAttention v3 con superposición matmul–softmax. Los costos de comunicación de AllReduce y All2All se contabilizan íntegramente y no se ocultan mediante la superposición de procesamiento y comunicación en mosaico. La sincronización de gradientes y la precaptura de pesos de FSDP se evalúan en diferentes niveles de superposición para analizar la sensibilidad a la escalabilidad horizontal. Los resultados suponen un comportamiento ideal y no totalmente optimizado en el mundo real, y pueden variar cuando el producto o los productos reales salgan al mercado. MI400-018
- https://focus.world-exchanges.org/issue/june-2025/market-statistics, datos de ventas internas de AMD
Notas al pie
- Cálculos realizados por los laboratorios de rendimiento de AMD en junio del 2025, basados en la capacidad de memoria/ancho de banda proyectado y las especificaciones de ancho de banda de escalabilidad horizontal/vertical del AMD Instinct™ MI455X 72xGPU “Helios” AI Rack frente al NVIDIA “Vera Rubin” 72xGPU “Oberon” Rack anunciado públicamente. Los fabricantes de servidores pueden variar las configuraciones, lo que arroja resultados diferentes. MI350-045A
Cálculos realizados por los laboratorios de rendimiento de AMD en septiembre del 2025, basados en los tipos de datos FP8/FP4 y las especificaciones proyectadas para el rack de IA “Helios” de 72 GPU AMD Instinct™ MI455X frente a las especificaciones anunciadas públicamente para el rack de IA “Oberon” de 72 GPU NVIDIA “Vera Rubin”. Los resultados reales basados en silicio para producción pueden variar. Los fabricantes de servidores pueden variar las configuraciones, lo que arroja resultados diferentes. MI350-046B - Con base en el modelado de silicio de AMD Engineering y la simulación de la evaluación comparativa sintética de AMD, utilizando la evaluación comparativa MOE_4p5T hi_sparsity_ea9 para proyectar la aceleración del tiempo de solución en días utilizando el tipo de datos de entrenamiento FP8 en un sistema LLM simulado modelado con 8000 GPU AMD Instinct MI455X y (3) versus (2) NIC AMD Pensando Vulcano.
Los resultados reflejan el análisis del procesamiento puro de entrenamiento (solo capas de decodificación). Configuración evaluada con un tamaño de lote global de 4096 y una longitud de secuencia de 4K, utilizando la activación SwiGLU. Los resultados excluyen los costos adicionales de evaluación y creación de puntos de control. Se supone FlashAttention v3 con superposición matmul–softmax. Los costos de comunicación de AllReduce y All2All se contabilizan íntegramente y no se ocultan mediante la superposición de procesamiento y comunicación en mosaico. La sincronización de gradientes y la precaptura de pesos de FSDP se evalúan en diferentes niveles de superposición para analizar la sensibilidad a la escalabilidad horizontal. Los resultados suponen un comportamiento ideal y no totalmente optimizado en el mundo real, y pueden variar cuando el producto o los productos reales salgan al mercado. MI400-018 - https://focus.world-exchanges.org/issue/june-2025/market-statistics, datos de ventas internas de AMD