
Redes de escalabilidad horizontal para la era de la IA
La tecnología AMD AI NIC™ se basa en generaciones de innovación para ofrecer redes de alto rendimiento, programables y abiertas que permiten a los proveedores de servicios en la nube y a hiperescala escalar la infraestructura de IA con confianza.
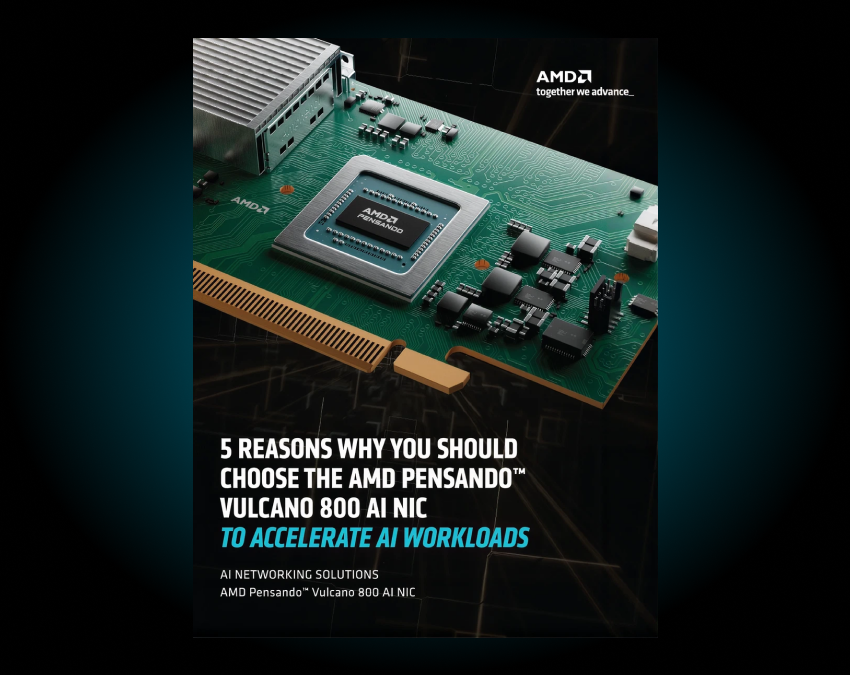
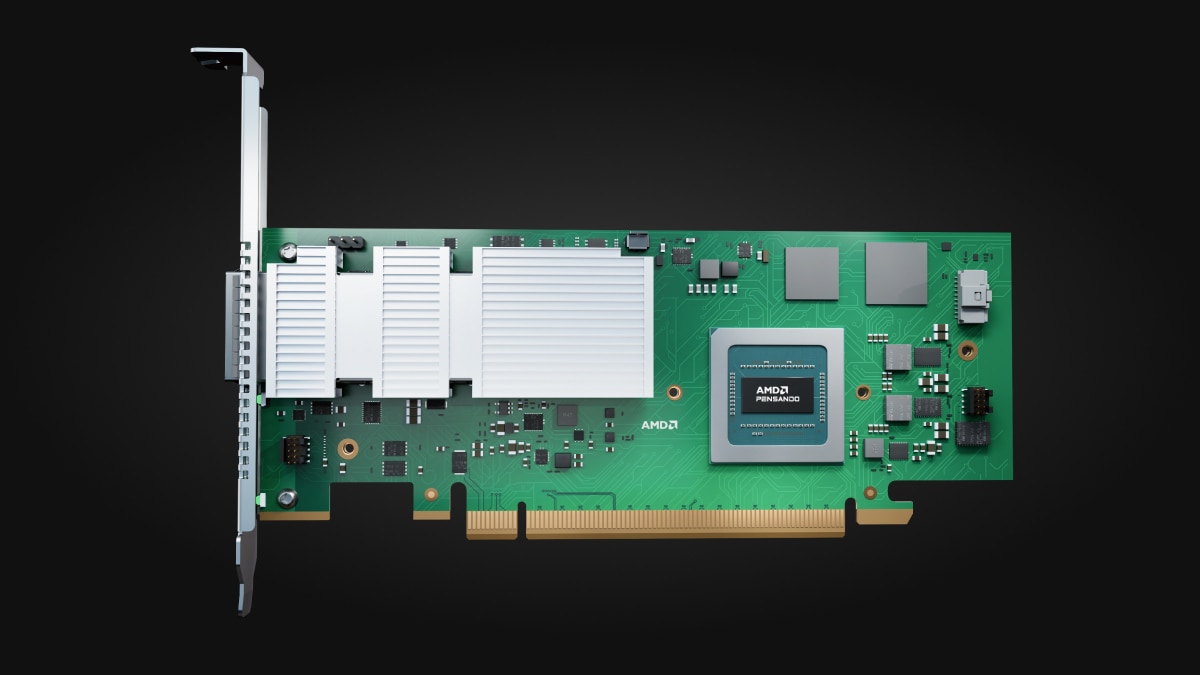
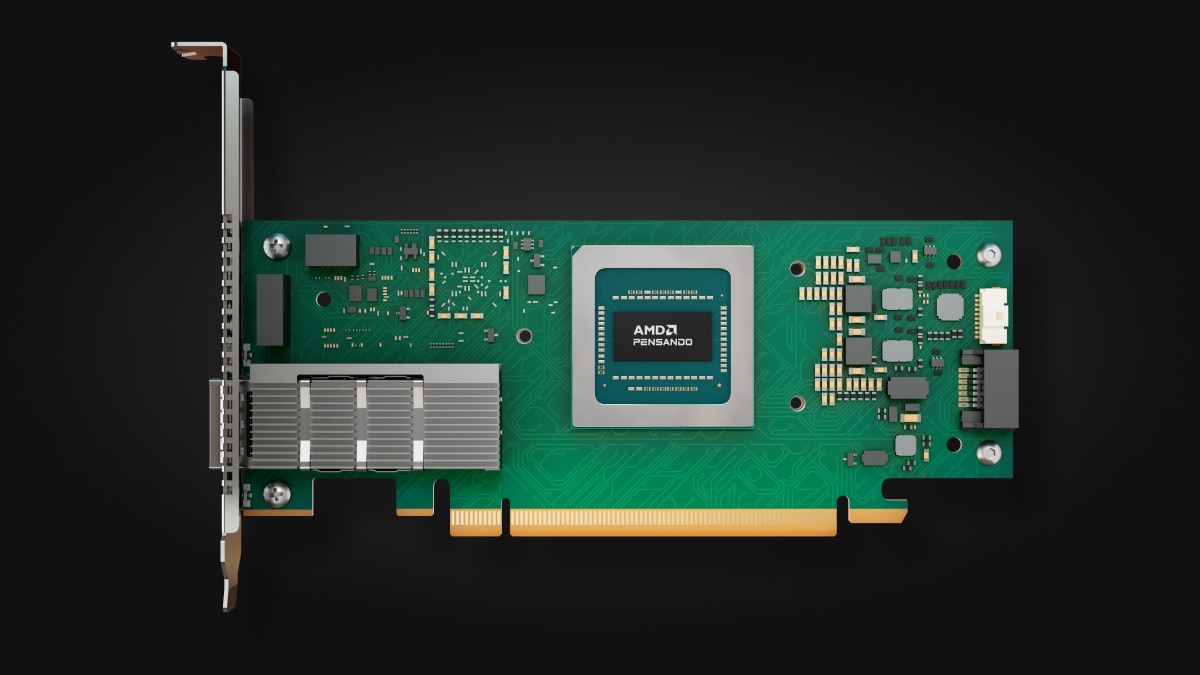
AI NIC AMD Pensando™ Vulcano 800
La AI NIC AMD Pensando™ Vulcano 800 es la única AI NIC del mercado que admite hasta 2,4 Tb/s de ancho de banda de escalabilidad horizontal por GPU, lo que proporciona la conectividad de alta velocidad necesaria para las cargas de trabajo de IA más exigentes.
Rendimiento de IA más rápido
Mayor tiempo de actividad del clúster
Reducción del gasto de inversión de capital
Mayor excelencia operativa

AI NIC AMD Pensando™ Vulcano 800 según las cifras
Aceleración del tiempo para obtener resultados, desde el entrenamiento de modelos grandes hasta su implementación.
Los sistemas abiertos impulsan una infraestructura de IA más eficiente en costos y escalable.
Obtén más información sobre la AI NIC AMD Pensando™ Vulcano 800
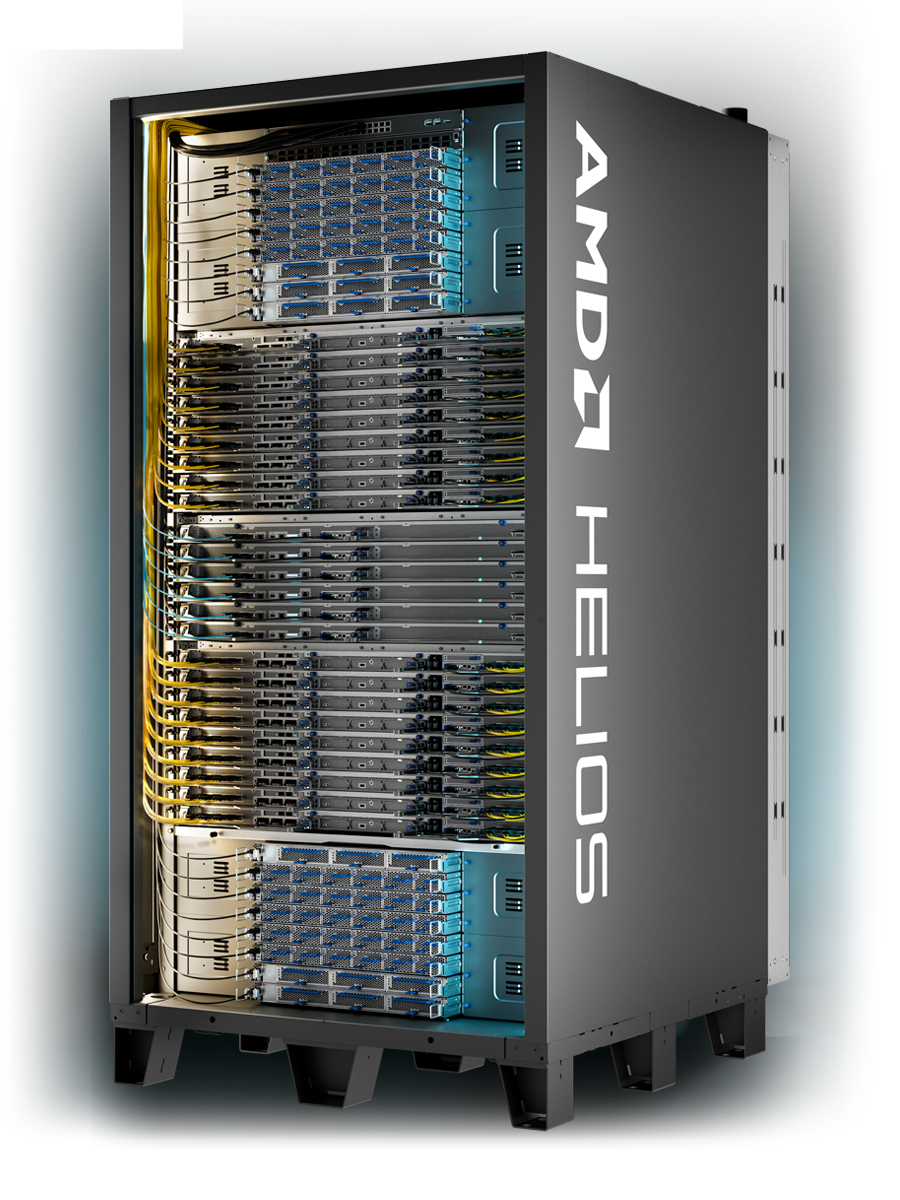
Solución a escala de rack AMD Helios para la IA de vanguardia3
El diseño de la solución de escala de rack AMD Helios es una infraestructura de IA totalmente integrada, que combina las últimas GPU AMD Instinct™, CPU para servidores AMD EPYC™ y redes AMD Pensando™, desarrollada a partir de estándares abiertos de la industria para permitir la inferencia a gran escala, el entrenamiento de modelos de vanguardia y el perfeccionamiento.
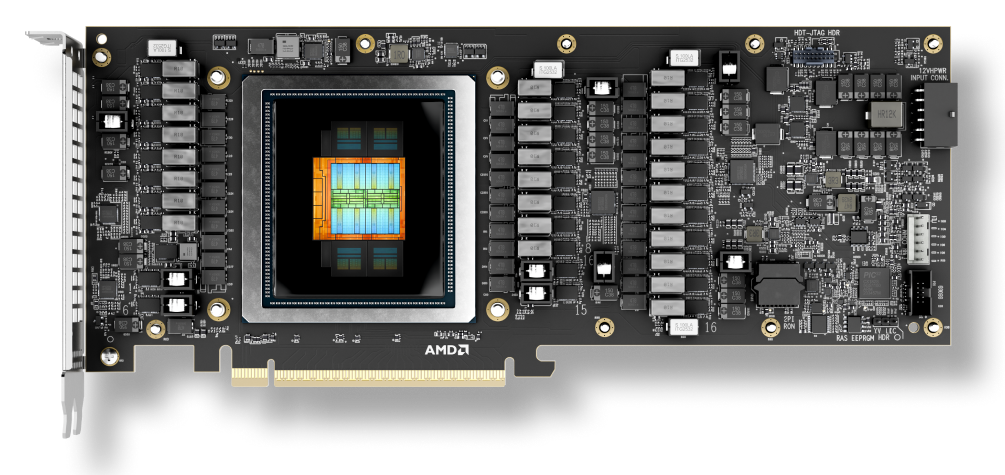
Tarjeta PCIe® AMD Instinct™ MI350P
La tarjeta PCIe AMD Instinct MI350P ofrece una vía práctica para escalar las cargas de trabajo de IA generativa en diferentes sectores con pocos o ningún cambio en la infraestructura. Fabricadas con la arquitectura AMD CDNA™ de 4.ª generación, estas tarjetas basadas en PCIe ofrecen una eficiencia y un rendimiento excepcionales para las cargas de trabajo empresariales convencionales con una robusta pila de software enfocada en la empresa para simplificar la implementación.
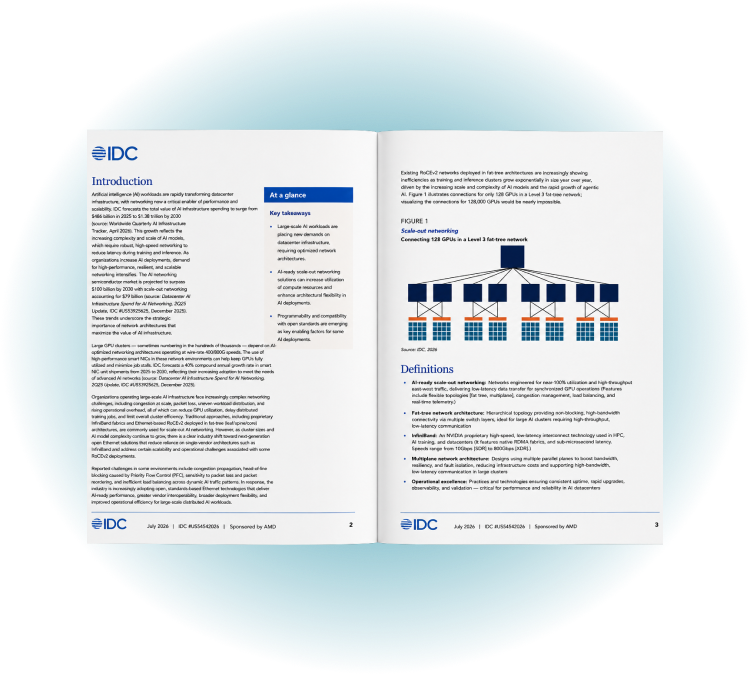
Habilitación de redes de escalabilidad horizontal listas para IA para cargas de trabajo de IA
Descubre cómo las redes de escalabilidad horizontal mejoran la utilización de las GPU, aceleran las tareas de IA y reducen el costo de escalar la infraestructura de IA.
La programabilidad permite la elección de protocolos
La tecnología AMD AI NIC™ se basa en un motor P4 totalmente programable, lo que permite utilizar protocolos como RDMA compatible con UEC, MetaRoCE y conexión confiable de rutas múltiples (MRC), así como otros transportes abiertos y personalizados, con funciones que se pueden ajustar y actualizar a medida que evolucionan las normas.
- Distribución de paquetes inteligente
- Manejo de paquetes fuera de orden y entrega de mensajes en orden
- Retransmisión selectiva
- Control de congestión con reconocimiento de rutas
- Detección rápida de fallos
Distribución de paquetes inteligente
La distribución de paquetes inteligente permite a los equipos optimizar de manera fluida el rendimiento de la red mejorando el equilibrio de carga y aumentando la eficiencia general y la escalabilidad. El rendimiento mejorado de la red puede reducir significativamente los tiempos de comunicación de GPU a GPU, lo que lleva a una finalización de los trabajos más rápida y una mayor eficiencia operativa.
Manejo de paquetes fuera de orden y entrega de mensajes en orden
Garantiza que los mensajes se entreguen en el orden correcto, incluso cuando se emplean técnicas de creación de varias rutas y de distribución de paquetes. La función avanzada de entrega de mensajes fuera de orden procesa de manera eficiente los paquetes de datos que pueden llegar fuera de secuencia al colocarlos directamente en la memoria de la GPU de manera fluida y sin necesidad de almacenamiento en búfer.
Retransmisión selectiva
Aumenta el rendimiento de la red con la retransmisión de reconocimiento selectivo (SACK), que garantiza que solo se retransmitan los paquetes perdidos o dañados. SACK detecta y reenvía de manera eficiente los paquetes perdidos o dañados, lo que optimiza la utilización del ancho de banda y ayuda a reducir la latencia durante la recuperación de pérdidas de paquetes y a minimizar la transmisión de datos redundante para lograr una eficiencia excepcional.

Control de congestión con reconocimiento de rutas
Concéntrate en las cargas de trabajo, no en el monitoreo de red, con telemetría en tiempo real y algoritmos con reconocimiento de red. La función de control de congestión con reconocimiento de rutas simplifica la gestión del rendimiento de la red, lo que les permite a los equipos detectar y abordar rápidamente los problemas críticos al tiempo que mitigan el impacto de los casos de incast.
Detección rápida de fallos
Con la detección rápida de fallas, los equipos pueden identificar los problemas en milisegundos, lo que permite que la recuperación de las conmutaciones por errores sea casi instantánea y reduce significativamente el tiempo de inactividad de la GPU. Aprovecha la observabilidad de red elevada con las métricas de latencia casi en tiempo real y las estadísticas de congestión y caída.
Cartera de productos
La tecnología de redes de IA de AMD en primer plano
Socios
- OEM y ODM
- Soluciones de infraestructura
- Almacenamiento
- Conmutación
- Ecosistema


Recursos
Comunícate con nosotros
Desbloquea el futuro de las redes de IA
Descubre cómo la AI NIC AMD Pensando Pollara 400 puede transformar tu infraestructura de IA de escalabilidad horizontal.
Explorar las redes de centro de datos
Explora el conjunto completo de soluciones de redes de AMD diseñadas para centros de datos modernos de alto rendimiento.
Notas al pie
- Con base en el modelado de silicio de AMD Engineering y la simulación de la evaluación comparativa sintética de AMD, utilizando la evaluación comparativa MOE_4p5T hi_sparsity_ea9 para proyectar la aceleración del tiempo hasta obtener resultados, expresada en días, con el tipo de datos de entrenamiento FP8, en un sistema LLM simulado modelado con 8000 GPU AMD Instinct MI455X y (3) frente a (2) NIC AMD Pensando Vulcano.
Los resultados reflejan el análisis del procesamiento puro de entrenamiento (solo capas de decodificación). Configuración evaluada con un tamaño de lote global de 4096 y una longitud de secuencia de 4K, mediante la activación SwiGLU. Los resultados excluyen los costos adicionales de evaluación y creación de puntos de control. Se supone FlashAttention v3 con superposición matmul–softmax. Los costos de comunicación de AllReduce y All2All se contabilizan íntegramente y no se ocultan mediante la superposición de procesamiento y comunicación en mosaico. La sincronización de gradientes y la precaptura de pesos de FSDP se evalúan en diferentes niveles de superposición para analizar la sensibilidad a la escalabilidad horizontal. Los resultados suponen un comportamiento ideal y no totalmente optimizado en condiciones reales, y pueden variar cuando el producto o los productos reales salgan al mercado MI400-018
- PEN-022: comparación y precios de AMD al 18 de mayo del 2026, para costos de estructuras de red que admitan 32 000 GPU. Comparación de una NIC basada en Vulcano (VULCANO-CUSTOM-2.4T) implementada como parte de un sistema Helios a escala de rack con una red basada en conmutación Tomahawk 6 de 1,6T con SerDes de 200G frente al uso de NIC de 800G de la competencia con conmutación Tomahawk 6 de 800G con SerDes de 100G. Ambas estructuras eran topologías fat-tree construidas sobre plataformas de conmutación Tomahawk 5 de 800G, con costos de NIC considerados comparables. Se estima que el diseño basado en Vulcano ofrece un ahorro de hasta un 33 % en los costos de conmutación de red permitiendo una arquitectura más rentable con menos plataformas de conmutación, mayor ancho de banda por puerto en la red y una reducción en los cables y transceptores ópticos.
TH6-100G Serdes Fat-Tree (competencia):
Conmutación (TH6C BCM78914: 128 de 800G):
• Unidades leaf 1000
• Unidades spine 500
• Total de conmutadores 1500
• Precio unitario de TH6 de 100G: USD 79 587
• Costo total de conmutación: USD 60 millones
Cables y transceptores ópticos:
• Transceptores NIC (800G-DR8) 64 000 a USD 500
• Transceptores Leaf/Spine (800G-DR8) 192 000 a USD 500
• Cables MPO 256 000 a USD 89
• Costo total de transceptores ópticos y cables: USD 64 millones
Costo total de la estructura TH6 de 100G (conmutadores + cables y transceptores ópticos): USD 124 millones
TH6-200G SERDES Fat-Tree (solución Vulcano-Custom2.4T/AMD):
Conmutación (TH6P BCM78910: 64 de 1,6T):
• Unidades leaf 1000
• Unidades spine 500
• Total de conmutadores 1500
• Precio unitario de TH6 de 200G: USD 66 336
• Costo total de conmutación: USD 50 millones
Cables y transceptores ópticos:
Transceptores NIC (1,6T-DR8) 32 000 a USD 900 (50 % menos que la competencia)
Transceptores Leaf/Spine (1,6T-DR8) 64 000 a USD 900
Cables MPO 128 000 a USD 89 (50 % menos que la competencia)
Costo total de transceptores ópticos y cables: USD 43 millones
Costo total de la estructura TH6 de 200G (conmutadores + cables y transceptores ópticos): USD $93 millones
Ahorros de gastos de capital (solo estructura):
Ahorros en USD: USD 30,7 millones
Porcentaje de ahorro: 33,1 %
Fuentes de precios: se utilizaron datos del modelo de redes para hiperescala de SemiAnalysis con autorización; el análisis completo está disponible a través de una suscripción a SemiAnalysis. Precios de los conmutadores de Edgecore al 17 de mayo del 2026. Los resultados pueden variar según la configuración del sistema
- Cálculos realizados por los laboratorios de rendimiento de AMD al mes de junio del 2025, basados en la capacidad de memoria/ancho de banda proyectado y las especificaciones de ancho de banda de escalabilidad horizontal/vertical de 72 GPU AMD Instinct™ MI455X del rack de IA “Helios” frente a las especificaciones anunciadas públicamente para 72 GPU NVIDIA “Vera Rubin” del rack “Oberon”. Los fabricantes de servidores pueden variar las configuraciones, lo que arroja resultados diferentes. MI350-045A
Cálculos realizados por los laboratorios de rendimiento de AMD al mes de septiembre del 2025, basados en los tipos de datos FP8/FP4 y las especificaciones proyectadas para 72 GPU AMD Instinct™ MI455X del rack de IA “Helios” frente a las especificaciones anunciadas públicamente para 72 GPU NVIDIA “Vera Rubin” del rack de IA “Oberon”. Los resultados reales basados en silicio para producción pueden variar. Los fabricantes de servidores pueden variar las configuraciones, lo que arroja resultados diferentes. MI350-046B
- Con base en el modelado de silicio de AMD Engineering y la simulación de la evaluación comparativa sintética de AMD, utilizando la evaluación comparativa MOE_4p5T hi_sparsity_ea9 para proyectar la aceleración del tiempo hasta obtener resultados, expresada en días, con el tipo de datos de entrenamiento FP8, en un sistema LLM simulado modelado con 8000 GPU AMD Instinct MI455X y (3) frente a (2) NIC AMD Pensando Vulcano.
Los resultados reflejan el análisis del procesamiento puro de entrenamiento (solo capas de decodificación). Configuración evaluada con un tamaño de lote global de 4096 y una longitud de secuencia de 4K, mediante la activación SwiGLU. Los resultados excluyen los costos adicionales de evaluación y creación de puntos de control. Se supone FlashAttention v3 con superposición matmul–softmax. Los costos de comunicación de AllReduce y All2All se contabilizan íntegramente y no se ocultan mediante la superposición de procesamiento y comunicación en mosaico. La sincronización de gradientes y la precaptura de pesos de FSDP se evalúan en diferentes niveles de superposición para analizar la sensibilidad a la escalabilidad horizontal. Los resultados suponen un comportamiento ideal y no totalmente optimizado en condiciones reales, y pueden variar cuando el producto o los productos reales salgan al mercado MI400-018 - PEN-022: comparación y precios de AMD al 18 de mayo del 2026, para costos de estructuras de red que admitan 32 000 GPU. Comparación de una NIC basada en Vulcano (VULCANO-CUSTOM-2.4T) implementada como parte de un sistema Helios a escala de rack con una red basada en conmutación Tomahawk 6 de 1,6T con SerDes de 200G frente al uso de NIC de 800G de la competencia con conmutación Tomahawk 6 de 800G con SerDes de 100G. Ambas estructuras eran topologías fat-tree construidas sobre plataformas de conmutación Tomahawk 5 de 800G, con costos de NIC considerados comparables. Se estima que el diseño basado en Vulcano ofrece un ahorro de hasta un 33 % en los costos de conmutación de red permitiendo una arquitectura más rentable con menos plataformas de conmutación, mayor ancho de banda por puerto en la red y una reducción en los cables y transceptores ópticos.
TH6-100G Serdes Fat-Tree (competencia):
Conmutación (TH6C BCM78914: 128 de 800G):
• Unidades leaf 1000
• Unidades spine 500
• Total de conmutadores 1500
• Precio unitario de TH6 de 100G: USD 79 587
• Costo total de conmutación: USD 60 millones
Cables y transceptores ópticos:
• Transceptores NIC (800G-DR8) 64 000 a USD 500
• Transceptores Leaf/Spine (800G-DR8) 192 000 a USD 500
• Cables MPO 256 000 a USD 89
• Costo total de transceptores ópticos y cables: USD 64 millones
Costo total de la estructura TH6 de 100G (conmutadores + cables y transceptores ópticos): USD 124 millones
TH6-200G SERDES Fat-Tree (solución Vulcano-Custom2.4T/AMD):
Conmutación (TH6P BCM78910: 64 de 1,6T):
• Unidades leaf 1000
• Unidades spine 500
• Total de conmutadores 1500
• Precio unitario de TH6 de 200G: USD 66 336
• Costo total de conmutación: USD 50 millones
Cables y transceptores ópticos:
Transceptores NIC (1,6T-DR8) 32 000 a USD 900 (50 % menos que la competencia)
Transceptores Leaf/Spine (1,6T-DR8) 64 000 a USD 900
Cables MPO 128 000 a USD 89 (50 % menos que la competencia)
Costo total de transceptores ópticos y cables: USD 43 millones
Costo total de la estructura TH6 de 200G (conmutadores + cables y transceptores ópticos): USD $93 millones
Ahorros de gastos de capital (solo estructura):
Ahorros en USD: USD 30,7 millones
Porcentaje de ahorro: 33,1 %
Fuentes de precios: se utilizaron datos del modelo de redes para hiperescala de SemiAnalysis con autorización; el análisis completo está disponible a través de una suscripción a SemiAnalysis. Precios de los conmutadores de Edgecore al 17 de mayo del 2026. Los resultados pueden variar según la configuración del sistema - Cálculos realizados por los laboratorios de rendimiento de AMD al mes de junio del 2025, basados en la capacidad de memoria/ancho de banda proyectado y las especificaciones de ancho de banda de escalabilidad horizontal/vertical de 72 GPU AMD Instinct™ MI455X del rack de IA “Helios” frente a las especificaciones anunciadas públicamente para 72 GPU NVIDIA “Vera Rubin” del rack “Oberon”. Los fabricantes de servidores pueden variar las configuraciones, lo que arroja resultados diferentes. MI350-045A
Cálculos realizados por los laboratorios de rendimiento de AMD al mes de septiembre del 2025, basados en los tipos de datos FP8/FP4 y las especificaciones proyectadas para 72 GPU AMD Instinct™ MI455X del rack de IA “Helios” frente a las especificaciones anunciadas públicamente para 72 GPU NVIDIA “Vera Rubin” del rack de IA “Oberon”. Los resultados reales basados en silicio para producción pueden variar. Los fabricantes de servidores pueden variar las configuraciones, lo que arroja resultados diferentes. MI350-046B