
Mise en réseau scale-out pour l'ère de l’IA
La technologie AMD AI NIC™ s'appuie sur des générations d'innovation pour offrir des réseaux ouverts, programmables et hautes performances qui permettent aux hyperscalers et aux fournisseurs de services cloud de faire évoluer l'infrastructure d'IA en toute confiance.
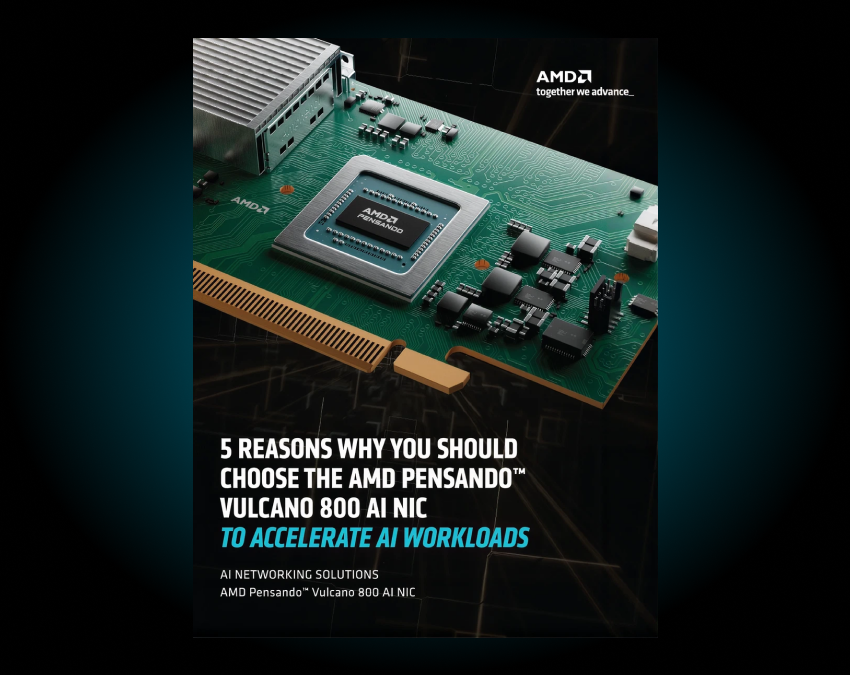
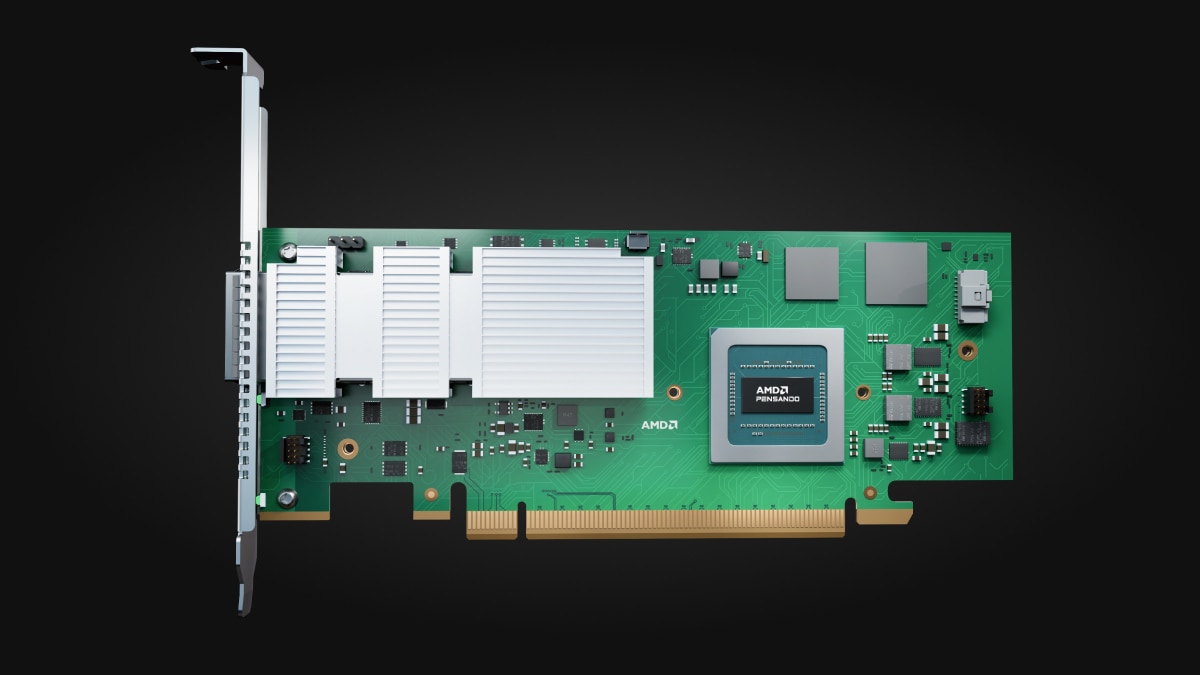
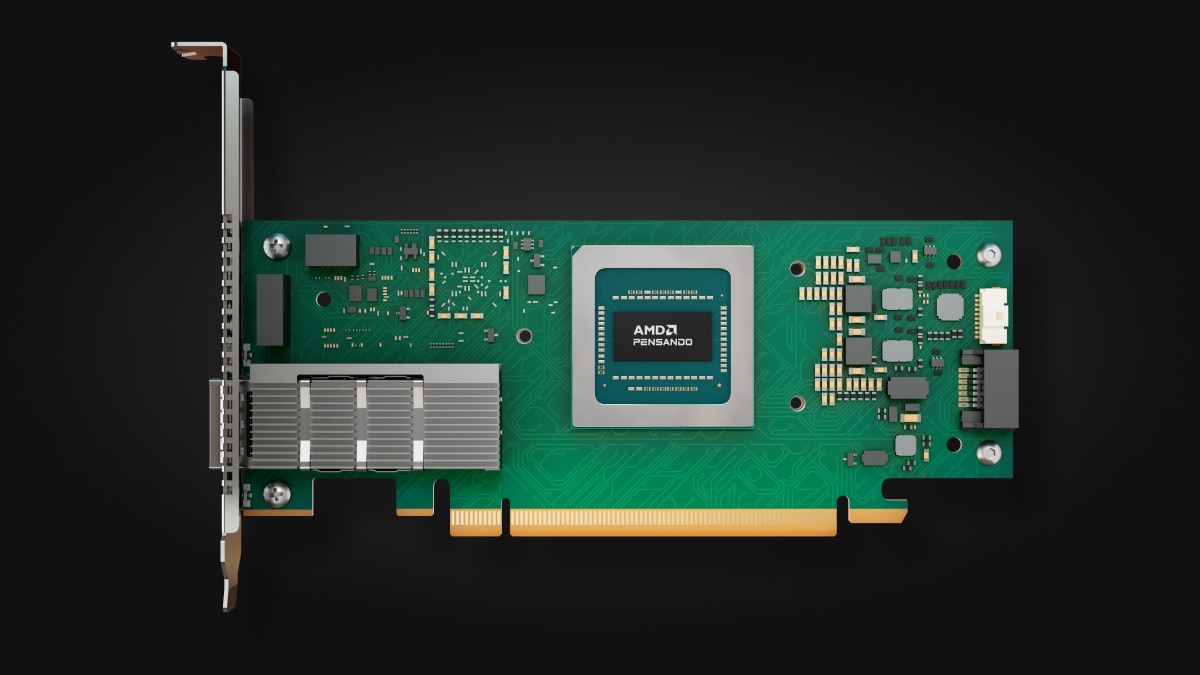
Carte réseau AMD Pensando™ Vulcano 800 AI NIC
La carte réseau AMD Pensando™ Vulcano 800 AI NIC est la seule carte réseau IA du marché à prendre en charge jusqu'à 2,4 Tbit/s de bande passante scale-out par GPU, fournissant la connectivité haut débit nécessaire pour les charges de travail d'IA les plus exigeantes.
Accélération des performances d'IA
Amélioration de la disponibilité du cluster
Réduction des dépenses d'investissement
Amélioration de l'excellence opérationnelle

La carte réseau AMD Pensando™ Vulcano 800 AI NIC en chiffres
Accélération du délai d'obtention des résultats, de l'entraînement de grands modèles à la préparation du déploiement.
Les systèmes ouverts favorisent une infrastructure d'IA plus économique et plus évolutive.
En savoir plus sur la carte réseau AMD Pensando™ Vulcano 800 AI NIC
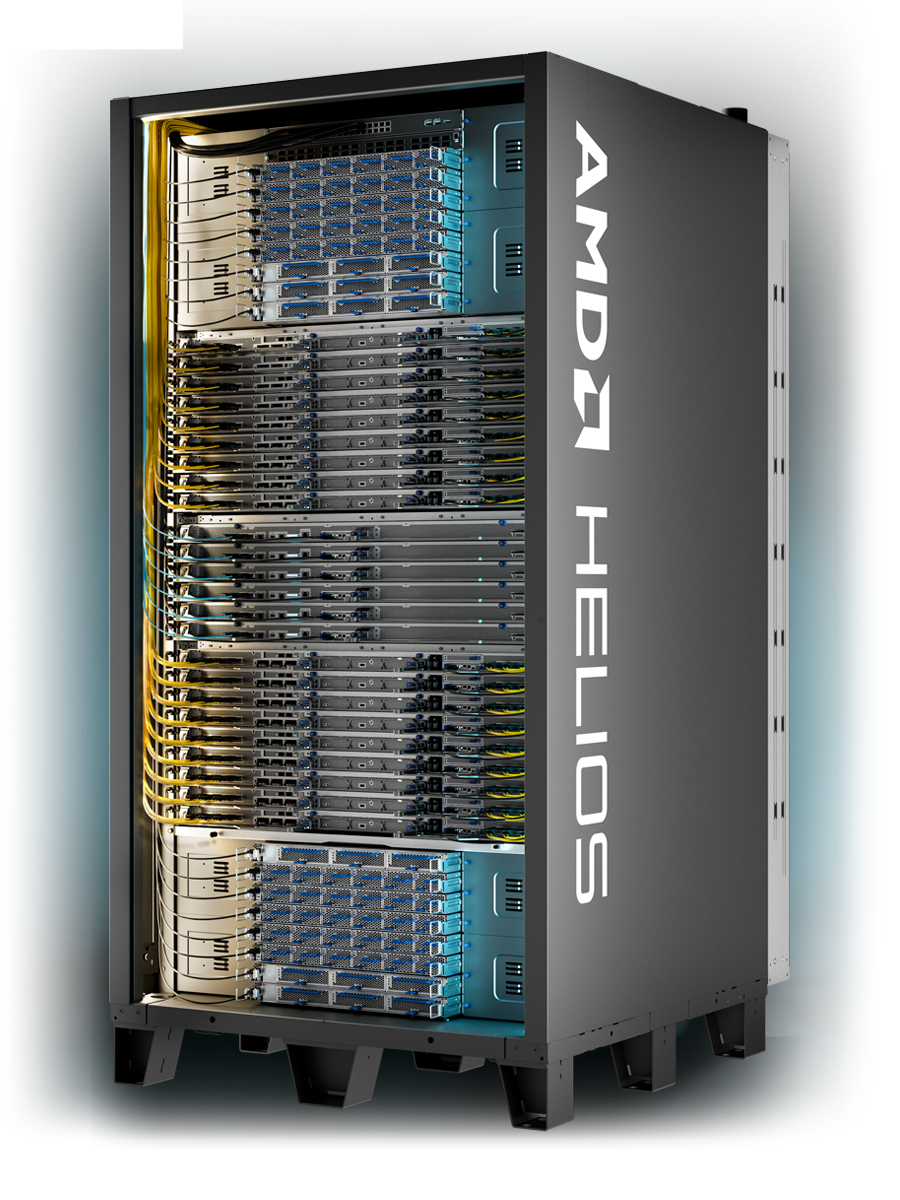
Solution AMD Helios Rackscale pour une infrastructure d’IA de pointe3
La conception de la solution AMD Helios Rackscale est une infrastructure d'IA entièrement intégrée, combinant les derniers GPU AMD Instinct™, les CPU pour serveur AMD EPYC™ et la mise en réseau AMD Pensando™, élaborée à l'aide de normes industrielles ouvertes permettant une inférence à grande échelle, un entraînement de modèles de pointe et un réglage précis.
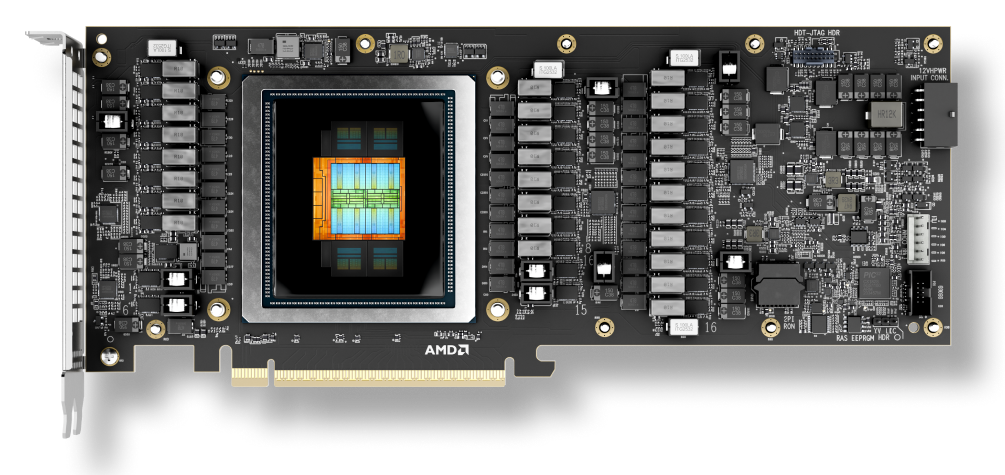
Carte PCIe® AMD Instinct™ MI350P
La carte PCIe AMD Instinct MI350P constitue une solution pratique pour faire évoluer les charges de travail d'IA générative dans tous les secteurs d'activité, sans ou avec très peu de modifications de l'infrastructure. Reposant sur l'architecture AMD CDNA™ de 4e génération, ces cartes PCIe offrent une efficacité et des performances exceptionnelles pour les charges de travail d'entreprise courantes. Elles s'accompagnent d'une pile software complète et robuste, spécialement conçue pour les entreprises, afin de simplifier le déploiement.
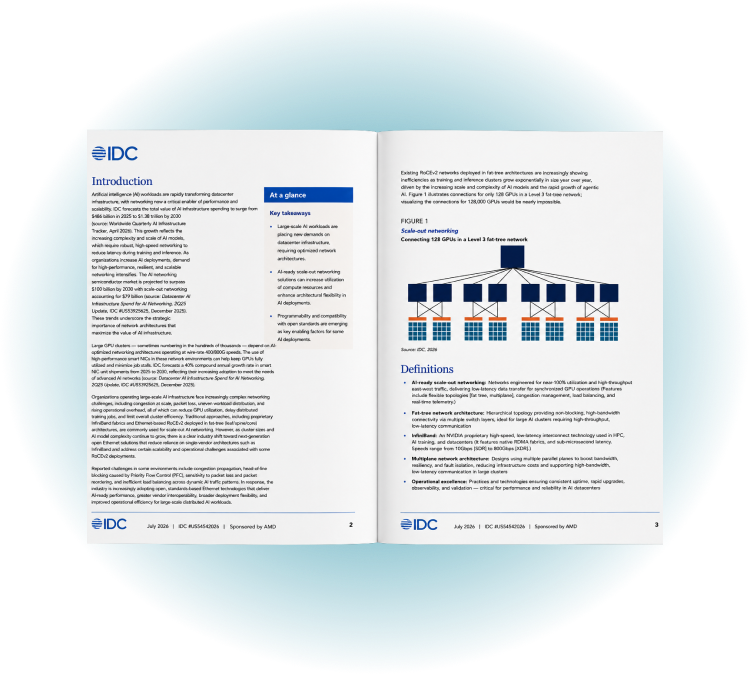
Mise en place d'une mise en réseau scale-out compatible IA pour les charges de travail d’IA
Découvrez comment la mise en réseau scale-out améliore l'utilisation des GPU, accélère les tâches d'IA et réduit le coût de l'évolutivité de l'infrastructure d'IA.
La programmabilité permet le choix du protocole
La technologie AMD AI NIC™ est basée sur un moteur entièrement programmable en langage P4, permettant des protocoles tels que RDMA compatible UEC et MRC (Multipath Reliable Connection), ainsi que des transports personnalisés, avec des fonctionnalités qui peuvent être réglées et mises à niveau à mesure que les normes évoluent.
- Pulvérisation de paquets intelligente
- Traitement des paquets dans le désordre et livraison des messages dans l'ordre
- Retransmission sélective
- Contrôle de la congestion en fonction du chemin
- Détection rapide des pannes
Pulvérisation de paquets intelligente
La pulvérisation de paquets intelligente permet aux équipes d'optimiser de manière fluide les performances du réseau en améliorant l'équilibrage de la charge, pour un gain global d'efficacité et d'évolutivité. L'amélioration des performances du réseau permet de réduire considérablement les temps de communication entre les GPU, ce qui accélère l'exécution des tâches et augmente l'efficacité opérationnelle.
Traitement des paquets dans le désordre et livraison des messages dans l'ordre
Aidez à garantir que les messages sont livrés dans le bon ordre, même lorsque vous utilisez des techniques de multipathing et de pulvérisation de paquets. La fonctionnalité avancée d'acheminement des messages dans le désordre traite efficacement les paquets de données qui peuvent arriver dans le désordre, en les plaçant directement dans la mémoire du GPU sans avoir besoin de les mettre en mémoire tampon.
Retransmission sélective
Améliorez les performances du réseau grâce à la retransmission avec accusé de réception sélectif (SACK), qui garantit que seuls les paquets perdus ou corrompus sont retransmis. Le SACK détecte et renvoie efficacement les paquets perdus ou endommagés, optimisant ainsi l'utilisation de la bande passante, contribuant à réduire le temps de latence pendant la récupération des paquets perdus et minimisant les transmissions de données redondantes pour une efficacité exceptionnelle.

Contrôle de la congestion en fonction du chemin
Concentrez-vous sur les charges de travail, et non sur la surveillance du réseau, grâce à la télémétrie en temps réel et aux algorithmes orientés réseau. La fonction de contrôle de la congestion en fonction du chemin simplifie la gestion des performances réseau, permettant aux équipes de détecter et de résoudre rapidement les problèmes critiques tout en contribuant à atténuer l'impact des scénarios incast.
Détection rapide des pannes
Grâce à la détection rapide des pannes, les équipes peuvent identifier les problèmes en quelques millisecondes, ce qui permet une reprise quasi instantanée et contribue à réduire considérablement les temps d'arrêt des GPU. Bénéficiez d'une observabilité réseau améliorée grâce à des mesures de temps de latence en temps quasi réel et à des statistiques sur la congestion et les pertes.
Portefeuille de produits
La technologie de mise en réseau IA d'AMD sous le feu des projecteurs
Partenaires
- OEM et ODM
- Solutions d'infrastructure
- Stockage
- Commutation
- Écosystème







Ressources

Nous contacter
Débridez l'avenir de la mise en réseau pour l'IA
Découvrez comment la carte réseau AMD Pensando Pollara 400 AI NIC peut transformer votre infrastructure d'IA scale-out.
Découvrir la mise en réseau pour centres de données
Découvrez la gamme complète de solutions réseau AMD conçues pour les centres de données modernes hautes performances.
Notes de bas de page
- Basé sur la modélisation des puces réalisées par l’ingénierie AMD et sur la simulation de benchmark synthétique AMD, utilisant le test de benchmark MOE_4p5T hi_sparsity_ea9 pour estimer le gain de temps nécessaire à la résolution, en nombre de jours, à l'aide du type de données d’entraînement FP8 sur un système LLM simulé, modélisé avec 8 000 GPU AMD Instinct MI455X et (3) contre (2) cartes réseau AMD Pensando Vulcano.
Les résultats reflètent une analyse de calcul dédiée exclusivement à l’entraînement (couches de décodage uniquement). Configuration évaluée avec une taille de lot globale de 4096 et une longueur de séquence de 4K, à l'aide de l'activation SwiGLU. Les résultats excluent les surcoûts liés à l'évaluation et aux points de contrôle. FlashAttention v3 avec chevauchement des opérations matmul et softmax supposé. Les coûts de communication des opérations AllReduce et All2All sont entièrement pris en compte et ne sont pas masqués par un chevauchement en tuile entre les calculs et la communication. La synchronisation de gradient et le préchargement de poids FSDP sont évalués selon différents niveaux de chevauchement afin d'analyser la sensibilité de scale-out. Les résultats reposent sur l’hypothèse d’un comportement idéal, non entièrement optimisé en conditions réelles, et peuvent varier lorsque les produits concernés seront commercialisés. MI400-018
- PEN-022 : Comparaison et tarifs AMD au 18 mai 2026 pour les coûts de structure réseau prenant en charge 32 000 GPU. Comparaison d'une carte réseau basée sur Vulcano (VULCANO-CUSTOM-2.4T) déployée dans le cadre d'un système à l'échelle du rack Helios avec un réseau basé sur la commutation 1.6T Tomahawk 6 avec SerDes de 200G par rapport à l'utilisation d'une carte réseau 800G concurrente avec une commutation 800G Tomahawk 6 avec SerDes de 100G. Les deux réseaux reposaient sur des topologies fat-tree basées sur des plateformes de commutation Tomahawk 5 800G, avec des coûts de cartes réseau considérés comme équivalents. La conception basée sur Vulcano devrait permettre de réaliser jusqu'à 33 % d'économies sur les coûts de commutation réseau grâce à une architecture plus économique avec moins de plateformes de commutation, plus de bande passante par port sur le réseau et moins de câbles/optiques de transceiver.
SerDes TH6-100G Fat-Tree (concurrence) :
Commutation (TH6C BCM78914 - 128x800G) :
• Unités Leaf 1 000
• Unités Spine 500
• Total de commutateurs 1 500
• Prix d'une unité TH6 100G 79 587 $
• Coût total de la commutation 60 millions de dollars
Câbles/optiques :
• Transceivers de cartes réseau (800G-DR8) 64 000 à 500 $ l'unité
• Transceivers Leaf/Spine (800G-DR8) 192 000 à 500 $ l'unité
• Câbles MPO 256 000 à 89 $ l'unité
• Coût total optiques/câbles 64 millions de dollars
Coût total de la structure TH6-100G (commutateurs + câbles/optiques) : 124 millions de dollars
SerDes TH6-200G Fat-Tree (Vulcano-Custom 2.4T/Solution AMD) :
Commutation (TH6P BCM78910 - 64x1.6T) :
• Unités Leaf 1 000
• Unités Spine 500
• Total de commutateurs 1 500
• Prix d'une unité TH6 200G 66 336 $
• Coût total de la commutation 50 millions de dollars
Câbles/optiques :
Transceivers de cartes réseau (1.6T-DR8) 32 000 à 900 $ l’unité (50 % de moins que la concurrence)
Transceivers Leaf/Spine (1.6T-DR8) 64 000 à 900 $ l’unité
Câbles MPO 128 000 à 89 $ l’unité (50 % de moins que la concurrence)
Total Optiques/Câbles 43 millions de dollars
Coût total de la structure TH6-200G (commutateurs + câbles/optiques) : 93 millions de dollars
Réduction des dépenses d’investissement (structure uniquement) :
Économies en dollars : 30,7 millions de dollars
Économies en pourcentage : 33,1 %
Sources des tarifs : Données de modèle de mise en réseau SemiAnalysis Hyperscaler utilisées avec autorisation ; analyse complète disponible via un abonnement SemiAnalysis. Prix du commutateur Edgecore au 17 mai 2026. Les résultats peuvent varier en fonction de la configuration du système
- Calculs effectués par AMD Performance Labs en juin 2025, sur la base de la capacité mémoire/bande passante prévue et des spécifications de bande passante scale-up/out du rack IA AMD Instinct™ MI455X 72xGPU « Helios » par rapport au rack « Oberon » NVIDIA « Vera Rubin » 72xGPU annoncé publiquement. Les résultats peuvent varier en fonction des configurations créées par les fabricants de serveurs. MI350-045A
Calculs réalisés par AMD Performance Labs en septembre 2025, sur la base des types de données FP8/FP4 et des spécifications prévues pour le rack IA AMD Instinct™ MI455X 72xGPU « Helios » par rapport aux spécifications annoncées publiquement pour le rack IA « Oberon » NVIDIA « Vera Rubin » 72xGPU. Les résultats réels peuvent varier selon la production de silicium. Les résultats peuvent varier en fonction des configurations créées par les fabricants de serveurs. MI350-046B
- Basé sur la modélisation des puces réalisées par l’ingénierie AMD et sur la simulation de benchmark synthétique AMD, utilisant le test de benchmark MOE_4p5T hi_sparsity_ea9 pour estimer le gain de temps nécessaire à la résolution, en nombre de jours, à l'aide du type de données d’entraînement FP8 sur un système LLM simulé, modélisé avec 8 000 GPU AMD Instinct MI455X et (3) contre (2) cartes réseau AMD Pensando Vulcano.
Les résultats reflètent une analyse de calcul dédiée exclusivement à l’entraînement (couches de décodage uniquement). Configuration évaluée avec une taille de lot globale de 4096 et une longueur de séquence de 4K, à l'aide de l'activation SwiGLU. Les résultats excluent les surcoûts liés à l'évaluation et aux points de contrôle. FlashAttention v3 avec chevauchement des opérations matmul et softmax supposé. Les coûts de communication des opérations AllReduce et All2All sont entièrement pris en compte et ne sont pas masqués par un chevauchement en tuile entre les calculs et la communication. La synchronisation de gradient et le préchargement de poids FSDP sont évalués selon différents niveaux de chevauchement afin d'analyser la sensibilité de scale-out. Les résultats reposent sur l’hypothèse d’un comportement idéal, non entièrement optimisé en conditions réelles, et peuvent varier lorsque les produits concernés seront commercialisés. MI400-018 - PEN-022 : Comparaison et tarifs AMD au 18 mai 2026 pour les coûts de structure réseau prenant en charge 32 000 GPU. Comparaison d'une carte réseau basée sur Vulcano (VULCANO-CUSTOM-2.4T) déployée dans le cadre d'un système à l'échelle du rack Helios avec un réseau basé sur la commutation 1.6T Tomahawk 6 avec SerDes de 200G par rapport à l'utilisation d'une carte réseau 800G concurrente avec une commutation 800G Tomahawk 6 avec SerDes de 100G. Les deux réseaux reposaient sur des topologies fat-tree basées sur des plateformes de commutation Tomahawk 5 800G, avec des coûts de cartes réseau considérés comme équivalents. La conception basée sur Vulcano devrait permettre de réaliser jusqu'à 33 % d'économies sur les coûts de commutation réseau grâce à une architecture plus économique avec moins de plateformes de commutation, plus de bande passante par port sur le réseau et moins de câbles/optiques de transceiver.
SerDes TH6-100G Fat-Tree (concurrence) :
Commutation (TH6C BCM78914 - 128x800G) :
• Unités Leaf 1 000
• Unités Spine 500
• Total de commutateurs 1 500
• Prix d'une unité TH6 100G 79 587 $
• Coût total de la commutation 60 millions de dollars
Câbles/optiques :
• Transceivers de cartes réseau (800G-DR8) 64 000 à 500 $ l'unité
• Transceivers Leaf/Spine (800G-DR8) 192 000 à 500 $ l'unité
• Câbles MPO 256 000 à 89 $ l'unité
• Coût total optiques/câbles 64 millions de dollars
Coût total de la structure TH6-100G (commutateurs + câbles/optiques) : 124 millions de dollars
SerDes TH6-200G Fat-Tree (Vulcano-Custom 2.4T/Solution AMD) :
Commutation (TH6P BCM78910 - 64x1.6T) :
• Unités Leaf 1 000
• Unités Spine 500
• Total de commutateurs 1 500
• Prix d'une unité TH6 200G 66 336 $
• Coût total de la commutation 50 millions de dollars
Câbles/optiques :
Transceivers de cartes réseau (1.6T-DR8) 32 000 à 900 $ l’unité (50 % de moins que la concurrence)
Transceivers Leaf/Spine (1.6T-DR8) 64 000 à 900 $ l’unité
Câbles MPO 128 000 à 89 $ l’unité (50 % de moins que la concurrence)
Total Optiques/Câbles 43 millions de dollars
Coût total de la structure TH6-200G (commutateurs + câbles/optiques) : 93 millions de dollars
Réduction des dépenses d’investissement (structure uniquement) :
Économies en dollars : 30,7 millions de dollars
Économies en pourcentage : 33,1 %
Sources des tarifs : Données de modèle de mise en réseau SemiAnalysis Hyperscaler utilisées avec autorisation ; analyse complète disponible via un abonnement SemiAnalysis. Prix du commutateur Edgecore au 17 mai 2026. Les résultats peuvent varier en fonction de la configuration du système - Calculs effectués par AMD Performance Labs en juin 2025, sur la base de la capacité mémoire/bande passante prévue et des spécifications de bande passante scale-up/out du rack IA AMD Instinct™ MI455X 72xGPU « Helios » par rapport au rack « Oberon » NVIDIA « Vera Rubin » 72xGPU annoncé publiquement. Les résultats peuvent varier en fonction des configurations créées par les fabricants de serveurs. MI350-045A
Calculs réalisés par AMD Performance Labs en septembre 2025, sur la base des types de données FP8/FP4 et des spécifications prévues pour le rack IA AMD Instinct™ MI455X 72xGPU « Helios » par rapport aux spécifications annoncées publiquement pour le rack IA « Oberon » NVIDIA « Vera Rubin » 72xGPU. Les résultats réels peuvent varier selon la production de silicium. Les résultats peuvent varier en fonction des configurations créées par les fabricants de serveurs. MI350-046B