
Redes expandidas para a era da IA
A tecnologia AMD AI NIC™ baseia-se em várias gerações de inovação para oferecer rede aberta, programável e de alto desempenho, permitindo que hiperescaladores e provedores de serviços de nuvem dimensionem sua infraestrutura de IA com confiança.
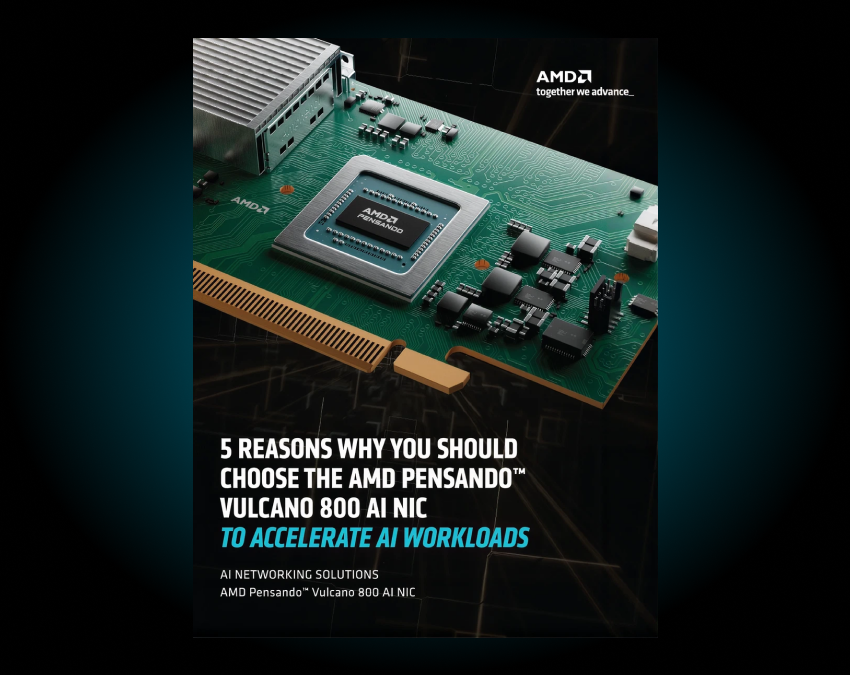
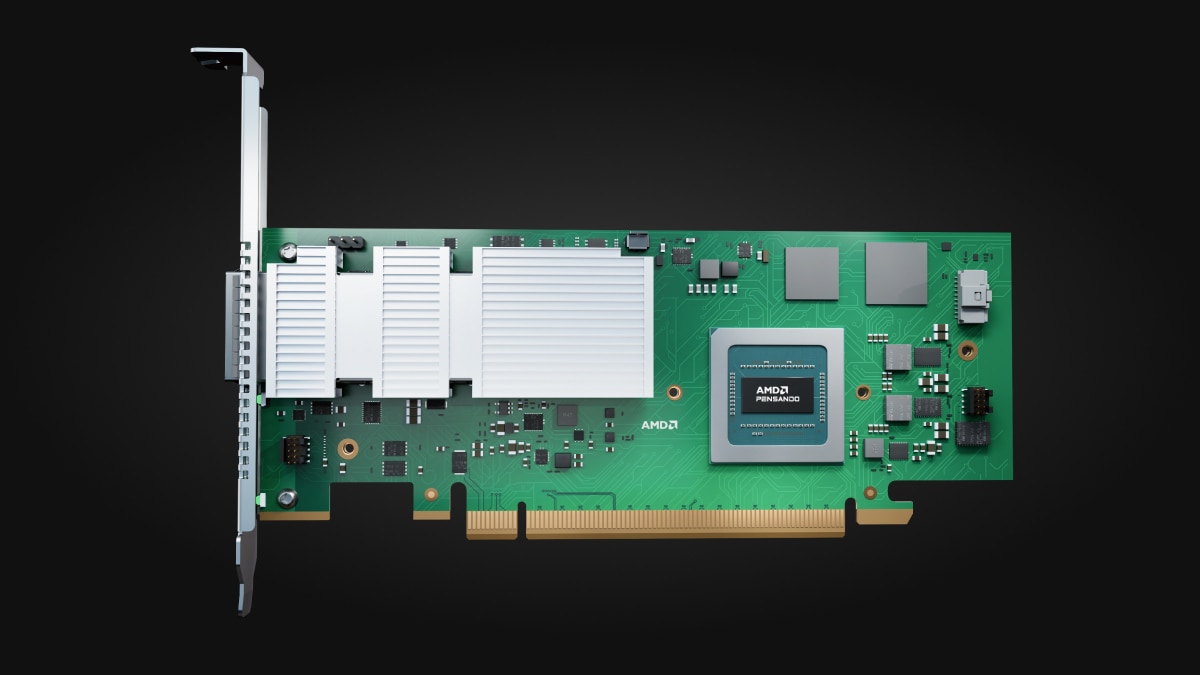
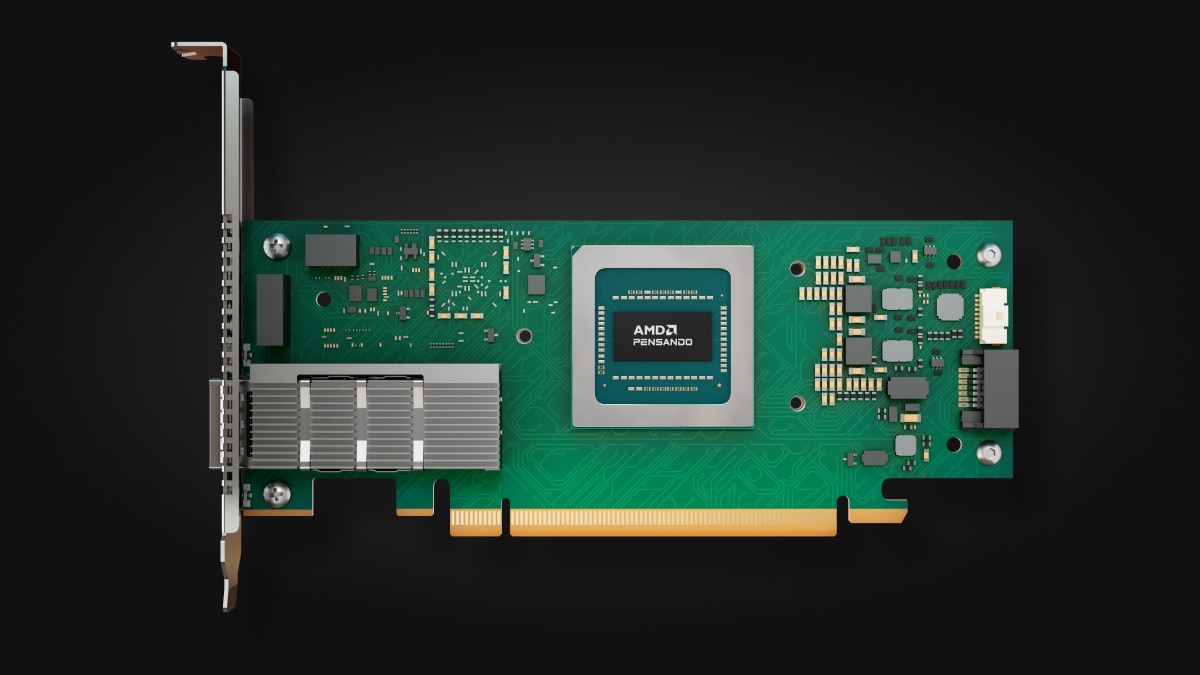
NIC para IA AMD Pensando™ Vulcano 800
A NIC para IA AMD Pensando™ Vulcano 800 é a única NIC de IA do mercado compatível com até 2,4 Tbps de largura de banda de expansão por GPU, proporcionando a conectividade de alta velocidade necessária para as cargas de trabalho de IA mais exigentes.
Desempenho de IA mais rápido
Aumento do tempo de atividade do cluster
Redução nos gastos com CAPEX
Excelência operacional aprimorada

NIC para IA AMD Pensando™ Vulcano 800 em números
Acelerando o tempo até os resultados, desde o treinamento de modelos de grande porte até a prontidão para implantação.
Sistemas abertos impulsionam uma infraestrutura de IA mais escalável e econômica.
Saiba mais sobre a NIC para IA AMD Pensando™ Vulcano 800
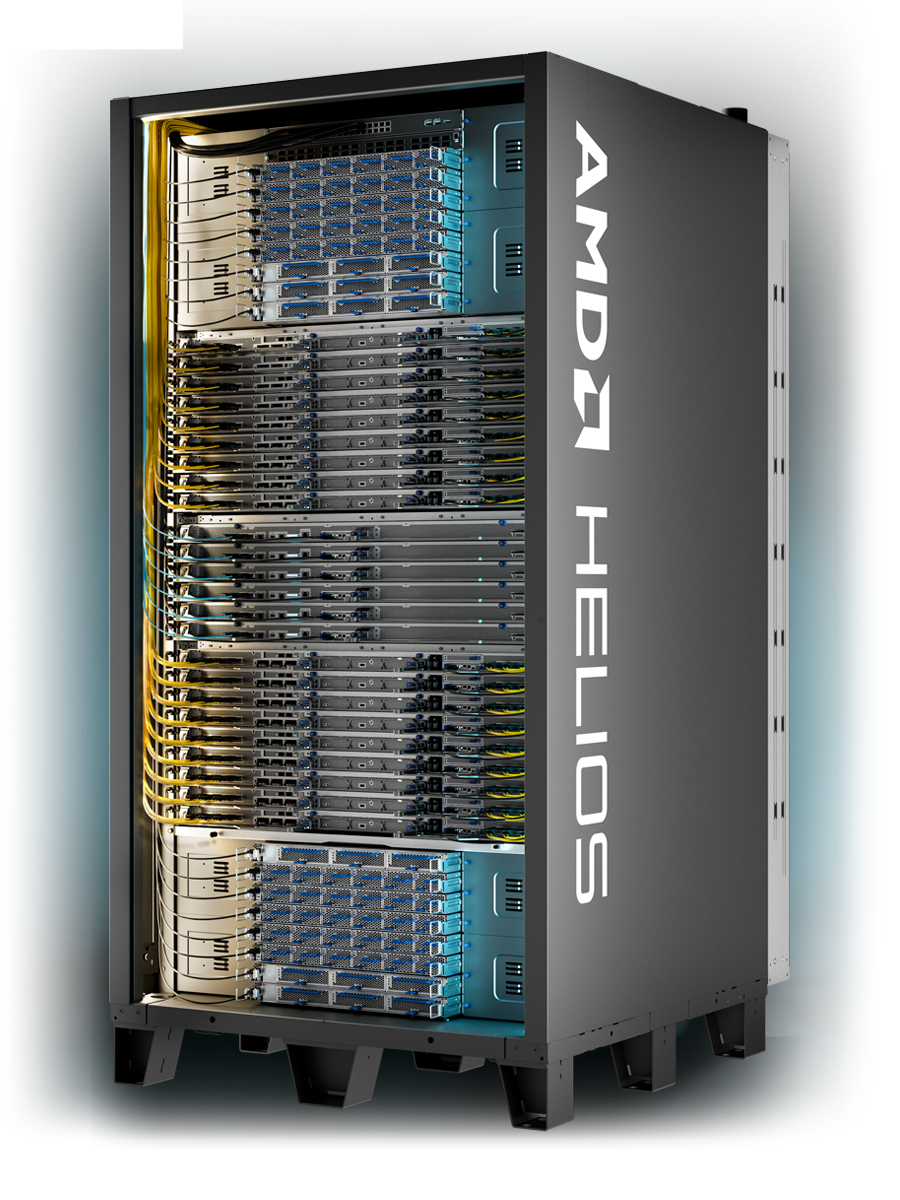
Solução em escala de rack AMD Helios para IA de ponta3
O design da solução em escala de rack AMD Helios é uma infraestrutura de IA totalmente integrada, que combina as mais recentes GPUs AMD Instinct™, CPUs de servidor AMD EPYC™ e a rede AMD Pensando™, e é projetada com base em padrões abertos do setor, para viabilizar inferência em larga escala, treinamento de modelos de ponta e ajuste fino.
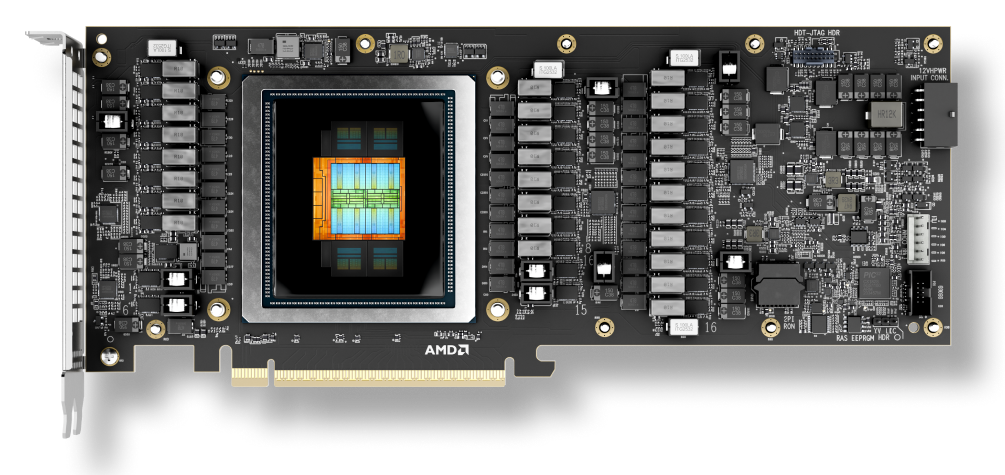
Placa PCIe® AMD Instinct™ MI350P
A placa PCIe AMD Instinct MI350P oferece uma solução prática para escalar cargas de trabalho de IA generativa em diversos setores, com pouca ou nenhuma alteração na infraestrutura. Construídas usando a arquitetura AMD CDNA™ de 4ª geração, essas placas baseadas em PCIe oferecem eficiência e desempenho excepcionais para cargas de trabalho empresariais convencionais, com uma pilha completa e robusta de software empresarial para simplificar a implantação.
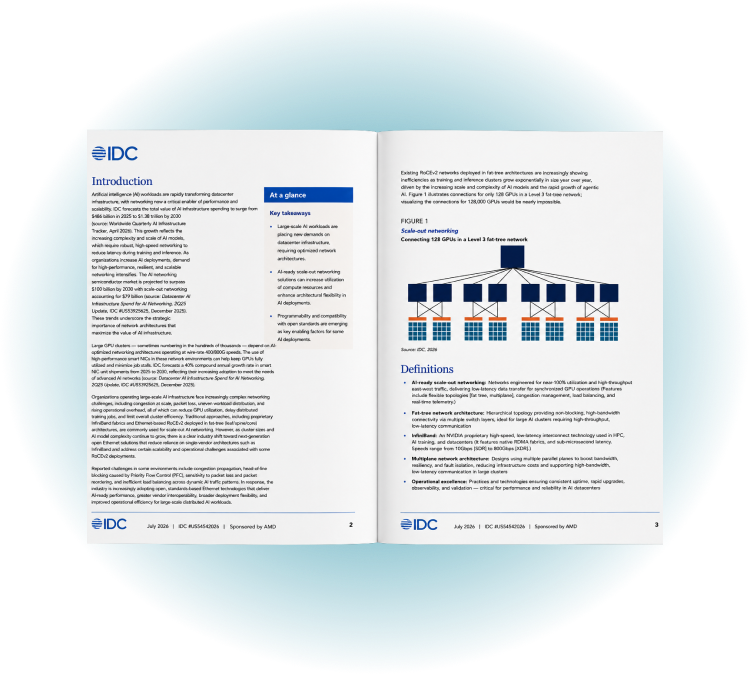
Desenvolvendo redes escaláveis para cargas de trabalho de IA
Saiba como a rede de expansão melhora a utilização de GPUs, acelera os trabalhos de IA e reduz o custo de dimensionar a infraestrutura de IA.
A programabilidade permite a escolha do protocolo
A tecnologia AMD AI NIC™ é baseada em um mecanismo P4 totalmente programável, permitindo o uso de protocolos como RDMA pronto para UEC e Multipath Reliable Connection (MRC), além de transportes personalizados, com recursos que podem ser ajustados e atualizados à medida que os padrões evoluem.
- Pulverização inteligente de pacotes
- Manuseio de pacotes fora de ordem e entrega de mensagens em ordem
- Retransmissão seletiva
- Controle de congestionamento baseado no caminho
- Detecção rápida de falhas
Pulverização inteligente de pacotes
A pulverização inteligente de pacotes permite que as equipes otimizem o desempenho da rede de forma contínua, melhorando o balanceamento de carga e aumentando a eficiência geral e a escalabilidade. O desempenho aprimorado da rede pode reduzir significativamente os tempos de comunicação entre GPUs, agilizando a conclusão dos trabalhos e tornando as operações mais eficientes.
Manuseio de pacotes fora de ordem e entrega de mensagens em ordem
Ajude a garantir que as mensagens sejam entregues na ordem correta, mesmo ao empregar técnicas de múltiplos caminhos e de pulverização de pacotes. O avançado recurso de entrega de mensagens fora de ordem processa com eficiência pacotes de dados que podem chegar fora de sequência, colocando-os diretamente na memória da GPU sem a necessidade de armazenamento em buffer.
Retransmissão seletiva
Aumente o desempenho da rede com retransmissão de SACK (Selective ACKnowledgment, Reconhecimento seletivo), que ajuda a garantir que apenas pacotes perdidos ou corrompidos sejam retransmitidos. O SACK detecta e reenvia pacotes perdidos ou danificados de forma eficiente, otimizando a utilização da largura de banda, ajudando a reduzir a latência durante a recuperação de perda de pacotes e minimizando a transmissão de dados redundantes para uma eficiência excepcional.

Controle de congestionamento baseado no caminho
Concentre-se nas cargas de trabalho, não no monitoramento de rede, com algoritmos de telemetria e de reconhecimento de rede em tempo real. O recurso de controle de congestionamento com reconhecimento de caminhos simplifica o gerenciamento de desempenho da rede, permitindo que as equipes detectem e solucionem rapidamente problemas críticos e, ao mesmo tempo, ajudem a atenuar o impacto de cenários de incast.
Detecção rápida de falhas
Com a detecção rápida de falhas, as equipes podem identificar problemas em milissegundos, permitindo a recuperação quase instantânea de failover e ajudando a reduzir significativamente o tempo de inatividade da GPU. Aproveite a observabilidade de rede elevada com métricas de latência quase em tempo real e estatísticas de congestionamento e queda.
Portfólio de produtos
Tecnologia de redes para IA da AMD em destaque
Parceiros
- OEM e ODM
- Soluções de infraestrutura
- Armazenamento
- Comutação
- Ecossistema







Recursos

Fale conosco
Abra as portas do futuro das redes com IA
Saiba como a NIC para IA AMD Pensando Pollara 400 pode transformar sua infraestrutura de IA expandida.
Conheça a rede de data center
Explore o conjunto completo de soluções de rede AMD projetadas para data centers modernos de alto desempenho.
Notas de rodapé
- Com base na modelagem de chip da engenharia da AMD e em uma simulação de avaliação de desempenho sintética da AMD, utilizando a avaliação de desempenho MOE_4p5T hi_sparsity_ea9 para projetar a aceleração do tempo até a solução em dias, utilizando o tipo de dados de treinamento FP8 em um sistema LLM simulado, modelado com 8000 GPUs AMD Instinct MI455X e (3) NICs AMD Pensando Vulcano em comparação com (2).
Os resultados refletem a análise de computação pura de treinamento (apenas camadas de decodificação). Configuração avaliada com um tamanho de lote global de 4096 e comprimento de sequência de 4K, utilizando ativação SwiGLU. Os resultados excluem a avaliação e a sobrecarga de ponto de verificação. Assume-se FlashAttention v3 com sobreposição matmul–softmax. Os custos de comunicação AllReduce e All2All são totalmente contabilizados e não ocultados por sobreposição de computação–comunicação em blocos. A sincronização de gradientes e a pré-busca de pesos FSDP são avaliadas sob diferentes níveis de sobreposição para avaliar a sensibilidade de expansão. Os resultados pressupõem comportamento ideal e não totalmente otimizado no mundo real, e podem variar quando os produtos reais forem lançados no mercado MI400-018
- PEN-022: Comparação e preços da AMD em 18 de maio de 2026 referentes aos custos de malha de rede para atender a 32.000 GPUs. Comparação entre uma NIC baseada em Vulcano (VULCANO-CUSTOM-2.4T) implantada como parte de um sistema em escala de rack Helios com uma rede baseada em comutação Tomahawk 6 de 1,6T com SerDes de 200G, em comparação com o uso de uma NIC concorrente de 800G com comutação Tomahawk 6 de 800G com SerDes de 100G. Ambas as malhas utilizavam topologias fat-tree construídas sobre plataformas de comutação Tomahawk 5 de 800G, com custos de NIC considerados comparáveis. Estima-se que o design baseado em Vulcano ofereça até 33% de economia em custos de comutação de rede ao permitir uma arquitetura mais econômica, com menos plataformas de comutação, mais largura de banda por porta na rede e menos cabos/transceptores ópticos.
TH6-100G SerDes Fat-Tree (concorrência):
Comutação (TH6C BCM78914 - 128x800G):
• Unidades Leaf 1.000
• Unidades Spine 500
• Total de switches 1.500
• Preço unitário TH6 100G US$ 79.587
• Custo total de comutação US$ 60M
Cabos/ópticos:
• Transceptores de NIC (800G-DR8) 64.000 a US$ 500
• Transceptores Leaf/Spine (800G-DR8) 192.000 a US$ 500
• Cabos MPO 256.000 a US$ 89
• Total de ópticos/cabos US$ 64M
Custo total da malha TH6-100G (switches + cabos/ópticos): US$ 124M
Fat-Tree com SerDes de 200G e TH6 (Vulcano-Custom2.4T/solução AMD):
Comutação (TH6P BCM78910 - 64x1.6T):
• Unidades Leaf 1.000
• Unidades Spine 500
• Total de switches 1.500
• Preço unitário TH6 200G US$ 66.336
• Custo total de comutação US$ 50M
Cabos/ópticos:
Transceptores de NIC (1,6T-DR8) 32,000 a US$ 900 (50% menos vs. concorrência)
Transceptores Leaf/Spine (1,6T-DR8) 64.000 a US$ 900
Cabos MPO 128.000 a US$ 89 (50% menos vs. concorrência)
Total de ópticos/cabos US$ 43M
Custo total da malha TH6-200G (switches + cabos/ópticos): US$ 93M
Economia de Capex (somente malha):
Economia US$: US$ 30,7M
Economia %: 33,1%
Fontes de preços: Dados do SemiAnalysis Hyperscaler Networking Model usados com permissão; análise completa disponível por assinatura da SemiAnalysis. Preços de switches Edgecore em 17 de maio de 2026. Os resultados podem variar de acordo com a configuração do sistema
- Cálculos realizados pelos laboratórios de desempenho AMD em junho de 2025, com base nas especificações projetadas de capacidade/largura de banda de memória e de largura de banda de expansão vertical/expansão do rack de IA "Helios" com AMD Instinct™ MI455X com 72 GPUs em comparação com o rack "Oberon" com NVIDIA "Vera Rubin" com 72 GPUs anunciado publicamente. Os fabricantes de servidores podem variar as configurações, gerando resultados diferentes. MI350-045A
Cálculos dos laboratórios de desempenho AMD em setembro de 2025, com base nos tipos de dados FP8/FP4 e nas especificações projetadas do rack de IA AMD Instinct™ MI455X com 72 GPUs "Helios" versus especificações anunciadas publicamente do rack de IA NVIDIA "Vera Rubin" com 72 GPUs "Oberon". Os resultados reais baseados na produção de silício podem variar. Os fabricantes de servidores podem variar as configurações, gerando resultados diferentes. MI350-046B
- Com base na modelagem de chip da engenharia da AMD e em uma simulação de avaliação de desempenho sintética da AMD, utilizando a avaliação de desempenho MOE_4p5T hi_sparsity_ea9 para projetar a aceleração do tempo até a solução em dias, utilizando o tipo de dados de treinamento FP8 em um sistema LLM simulado, modelado com 8000 GPUs AMD Instinct MI455X e (3) NICs AMD Pensando Vulcano em comparação com (2).
Os resultados refletem a análise de computação pura de treinamento (apenas camadas de decodificação). Configuração avaliada com um tamanho de lote global de 4096 e comprimento de sequência de 4K, utilizando ativação SwiGLU. Os resultados excluem a avaliação e a sobrecarga de ponto de verificação. Assume-se FlashAttention v3 com sobreposição matmul–softmax. Os custos de comunicação AllReduce e All2All são totalmente contabilizados e não ocultados por sobreposição de computação–comunicação em blocos. A sincronização de gradientes e a pré-busca de pesos FSDP são avaliadas sob diferentes níveis de sobreposição para avaliar a sensibilidade de expansão. Os resultados pressupõem comportamento ideal e não totalmente otimizado no mundo real, e podem variar quando os produtos reais forem lançados no mercado MI400-018 - PEN-022: Comparação e preços da AMD em 18 de maio de 2026 referentes aos custos de malha de rede para atender a 32.000 GPUs. Comparação entre uma NIC baseada em Vulcano (VULCANO-CUSTOM-2.4T) implantada como parte de um sistema em escala de rack Helios com uma rede baseada em comutação Tomahawk 6 de 1,6T com SerDes de 200G, em comparação com o uso de uma NIC concorrente de 800G com comutação Tomahawk 6 de 800G com SerDes de 100G. Ambas as malhas utilizavam topologias fat-tree construídas sobre plataformas de comutação Tomahawk 5 de 800G, com custos de NIC considerados comparáveis. Estima-se que o design baseado em Vulcano ofereça até 33% de economia em custos de comutação de rede ao permitir uma arquitetura mais econômica, com menos plataformas de comutação, mais largura de banda por porta na rede e menos cabos/transceptores ópticos.
TH6-100G SerDes Fat-Tree (concorrência):
Comutação (TH6C BCM78914 - 128x800G):
• Unidades Leaf 1.000
• Unidades Spine 500
• Total de switches 1.500
• Preço unitário TH6 100G US$ 79.587
• Custo total de comutação US$ 60M
Cabos/ópticos:
• Transceptores de NIC (800G-DR8) 64.000 a US$ 500
• Transceptores Leaf/Spine (800G-DR8) 192.000 a US$ 500
• Cabos MPO 256.000 a US$ 89
• Total de ópticos/cabos US$ 64M
Custo total da malha TH6-100G (switches + cabos/ópticos): US$ 124M
Fat-Tree com SerDes de 200G e TH6 (Vulcano-Custom2.4T/solução AMD):
Comutação (TH6P BCM78910 - 64x1.6T):
• Unidades Leaf 1.000
• Unidades Spine 500
• Total de switches 1.500
• Preço unitário TH6 200G US$ 66.336
• Custo total de comutação US$ 50M
Cabos/ópticos:
Transceptores de NIC (1,6T-DR8) 32,000 a US$ 900 (50% menos vs. concorrência)
Transceptores Leaf/Spine (1,6T-DR8) 64.000 a US$ 900
Cabos MPO 128.000 a US$ 89 (50% menos vs. concorrência)
Total de ópticos/cabos US$ 43M
Custo total da malha TH6-200G (switches + cabos/ópticos): US$ 93M
Economia de Capex (somente malha):
Economia US$: US$ 30,7M
Economia %: 33,1%
Fontes de preços: Dados do SemiAnalysis Hyperscaler Networking Model usados com permissão; análise completa disponível por assinatura da SemiAnalysis. Preços de switches Edgecore em 17 de maio de 2026. Os resultados podem variar de acordo com a configuração do sistema - Cálculos realizados pelos laboratórios de desempenho AMD em junho de 2025, com base nas especificações projetadas de capacidade/largura de banda de memória e de largura de banda de expansão vertical/expansão do rack de IA "Helios" com AMD Instinct™ MI455X com 72 GPUs em comparação com o rack "Oberon" com NVIDIA "Vera Rubin" com 72 GPUs anunciado publicamente. Os fabricantes de servidores podem variar as configurações, gerando resultados diferentes. MI350-045A
Cálculos dos laboratórios de desempenho AMD em setembro de 2025, com base nos tipos de dados FP8/FP4 e nas especificações projetadas do rack de IA AMD Instinct™ MI455X com 72 GPUs "Helios" versus especificações anunciadas publicamente do rack de IA NVIDIA "Vera Rubin" com 72 GPUs "Oberon". Os resultados reais baseados na produção de silício podem variar. Os fabricantes de servidores podem variar as configurações, gerando resultados diferentes. MI350-046B