
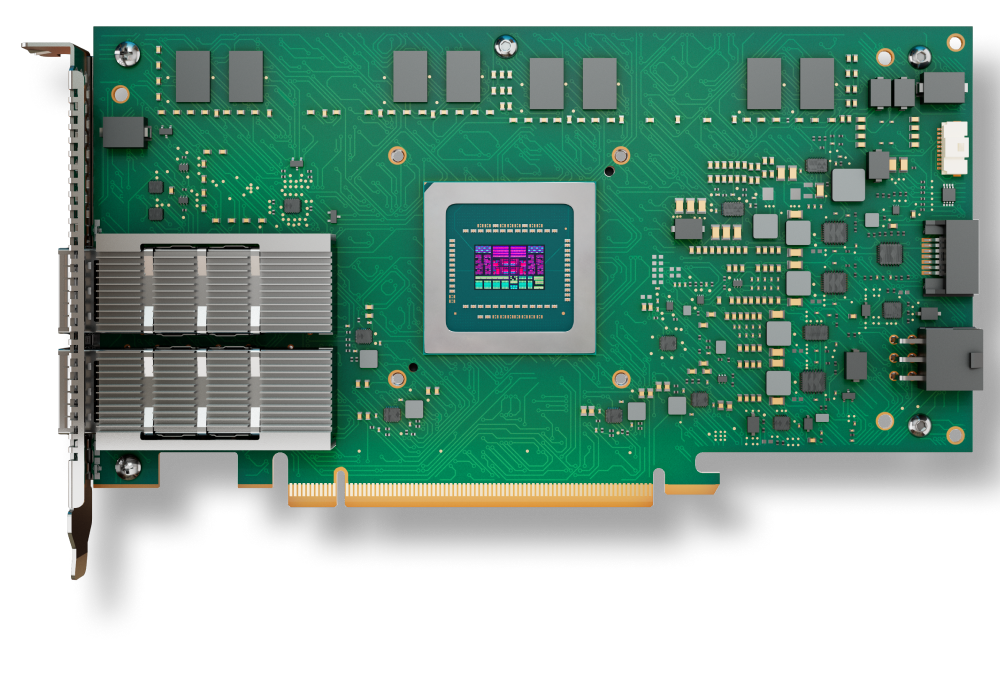
Rede front-end de alto desempenho

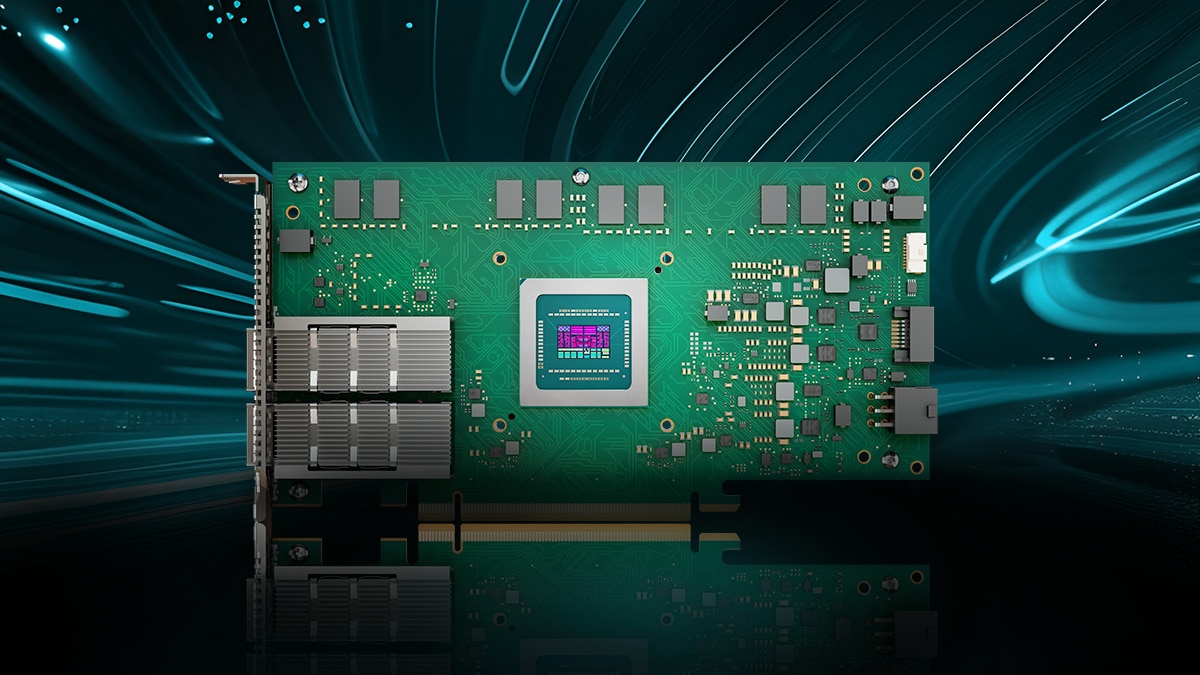
Projetada especificamente para a movimentação de grandes volumes de dados exigida pelas cargas de trabalho de treinamento, inferência e IA agêntica, a DPU AMD Pensando™ totalmente programável foi amplamente adotada e validada por alguns dos maiores data centers de hiperescala.

Casos de uso

Abstract illustration with glowing blue lines

SDN para múltiplos locatários e rede virtual

Promova um desempenho aprimorado para aplicações de IA exigentes, fornecendo os recursos essenciais de rede definida por software (SDN).

Abstract glowing 3D computer chip lines

Aceleração do serviço de segurança e observabilidade abrangente

Aproveite a visibilidade granular das operações de rede, armazenamento e segurança para rápida solução de problemas, conformidade e otimização de desempenho.

Server room center exchanging cyber datas 3D rendering

Aceleração de armazenamento e otimização de KV-Cache

Acelere o armazenamento de IA e o acesso ao cache KV para oferecer suporte a janelas de contexto maiores, maior densidade de agentes e inferência contínua para cargas de trabalho de IA agêntica de última geração.

Abstract glowing 3D computer chip lines

Rede de front-end para clusters de IA

Aproveite a rede de front-end para acelerar e gerenciar a movimentação de dados entre computação, armazenamento e redes externas, permitindo alta produtividade e baixa latência para cargas de trabalho de IA exigentes.

Performance da avaliação de desempenho

Cerca de 1,45x
Desempenho em relação ao NVIDIA BlueField-3¹

A DPU AMD Pensando™ Salina pode ajudar a proporcionar um gerenciamento mais eficiente do tráfego de rede.

Cerca de 2x
Desempenho geração após geração²

As DPUs AMD Pensando™ estão definindo um novo padrão para produtividade e escalabilidade de data centers.

Portfólio

AMD Pensando DPU

DPU AMD Pensando™ Salina

A DPU AMD Pensando™ Salina é totalmente programável em P4 e otimizada para requisitos mínimos de latência, jitter e energia. A pilha de hardware e software de várias gerações é implantada em hiperescala para desempenho front-end ideal.

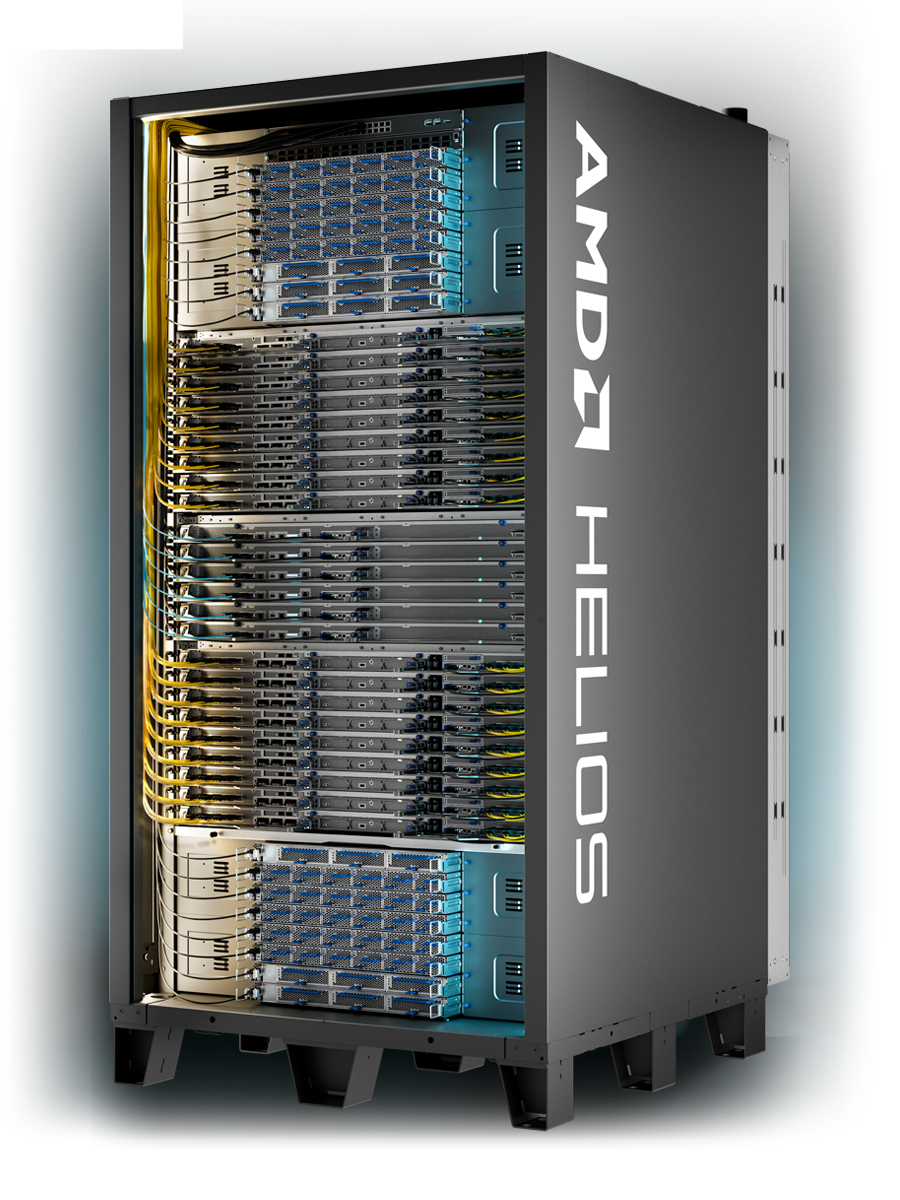
Solução em escala de rack AMD Helios

Desempenho de rack líder para IA em hiperescala3

O design da solução em escala de rack AMD Helios é uma infraestrutura de IA totalmente integrada, que combina as mais recentes GPUs AMD Instinct™, CPUs de servidor AMD EPYC™ e a rede AMD Pensando™, projetadas com base em padrões abertos do setor, para viabilizar inferência em larga escala, treinamento de modelos de fronteira e ajuste fino.

AMD Helios Rackscale

Experiências de clientes com DPUs AMD Pensando™

Ecossistema de parceiros

DXC Technology
IBM Cloud white logo
Microsoft Azure logo
Oracle Cloud logo
Zyphra logo
Dell Technologies logo
ddn logo
Vast logo
Weka logo
Cisco white logo
HPE aruba networking logo

Recursos

Fale conosco

Abra as portas do futuro das redes com IA

Saiba como a tecnologia de DPUs AMD Pensando ™ pode transformar a rede de front-end do data center moderno.

Conheça a rede de data center

Conheça em detalhes o conjunto completo de soluções de rede projetadas para data centers modernos de alto desempenho.

Notas de rodapé
  1. PEN-017: Testes realizados pelos laboratórios de desempenho AMD em 15 de abril de 2025 na DPU AMD Pensando Salina, em um sistema de teste composto por 2 Dell PowerEdge XE9680 de dois soquetes com Xeon; Switch Cisco 64x400G; testador IXIA 2x400G da Keysight como gerador de tráfego; 2 DPUs AMD Pensando™ Salina; CPU Xeon 8568 de 5ª geração, com 48 núcleos e PCIe Gen-5; versão do sistema operacional: Ubuntu® 22.04.5 LTS; Versão do kernel: 5.15.0-139-generic; versão do BIOS: 1.3.6 [Mitigação: Desativado (padrão), configuração do perfil do sistema: Desempenho (padrão), SMT: habilitado (padrão)] A AMD Pensando apresenta desempenho médio de 117 MPPS (milhões de pacotes por segundo) nos testes da AMD, enquanto o desempenho publicado da NVIDIA BlueField-3 é de 80 MPPS. https://hc33.hotchips.org/assets/program/conference/day1/HC2021.NVIDIA.IdanBurstein.v08.norecording.pdf Consulte Slide 6 para ver um desempenho de cerca de 1,45x superior com a DPU AMD Pensando Salina.
    Os resultados podem variar de acordo com fatores que incluem, entre outros, configurações do sistema e do software.
  2. PEN-012A: Medições realizadas pelos laboratórios de desempenho AMD em 15 de abril de 2025, com base na especificação atual do acelerador DPU AMD Pensando™ Salina, projetado com a tecnologia de processo de 5 nm da AMD Pensando™. Os números de desempenho são baseados no pipeline do SDN Cloud Gateway no BITW (bump-in-the-wire):
    Salina (DPU de 3ª geração)
    SDN PPS - 117MPPS
    SDN BW - 782G
    PPS de criptografia SDN - 100MPPS
    BW de criptografia SDN - 767G
    Elba (DPU de 2ª geração)
    SDN PPS - 52 MPPS
    SDN BW - 344G
    PPS de criptografia SDN - 42M
    BW de criptografia SDN - 288G
    Configuração do sistema de teste Salina:
    Servidor de produção com Intel Xeon 8568 2P, Ubuntu 22.04.5 LTS, switch Cisco Série N96K de 64x400G, versão do kernel: 5.15.0-139-generic; versão do BIOS 1.3.6; Mitigação — Desl. (padrão); Configuração de perfil do sistema — Desempenho (padrão);
    SMT - ativado (padrão)
    Configuração do sistema de teste Elba:
    Servidor de produção com 2P EPYC 7302, Oracle Linux 9.7, versão do kernel: 6.12.0-201.74.2.1 el9uek_x86_64, versão do BIOS 2.25, Mitigação - desativada (padrão), configuração do perfil do sistema - desempenho (padrão), SMT - ativado (padrão).
    Os resultados podem variar de acordo com a configuração do sistema e outros fatores.
  3. Cálculos realizados pelos laboratórios de desempenho AMD em junho de 2025, com base nas especificações projetadas de capacidade/largura de banda de memória e de largura de banda de expansão vertical/expansão do rack de IA "Helios" com AMD Instinct™ MI455X com 72 GPUsem comparação com o rack "Oberon" com NVIDIA "Vera Rubin" com 72 GPUs anunciado publicamente. Os fabricantes de servidores podem variar as configurações, gerando resultados diferentes. MI350-045A
    Cálculos dos laboratórios de desempenho AMD em setembro de 2025, com base nos tipos de dados FP8/FP4 e nas especificações projetadas do rack de IA AMD Instinct™ MI455X com 72 GPUs "Helios" versus especificações anunciadas publicamente do rack de IA NVIDIA "Vera Rubin" com 72 GPUs "Oberon". Os resultados reais baseados na produção de silício podem variar. Os fabricantes de servidores podem variar as configurações, gerando resultados diferentes. MI350-046B
  4. Jayant Tulsiani, Vice-presidente da DXC, Serviços de nuvem e infraestrutura: "Anteriormente, o que exigia centenas de firewalls físicos e virtuais para atender aos nossos requisitos de segmentação e conformidade agora está sendo fornecido nativamente em linha na plataforma, que tem sido a transformação para o modelo de custo total de propriedade dos nossos negócios, resultando em uma economia projetada de custo total de propriedade de aproximadamente 65 milhões de dólares." – Publicado em amd.com: https://www.amd.com/pt/solutions/data-center/data-center-ai-premiere/industry-support.html
  5. Satinder Sethi, Gerente geral da IBM Cloud Infrastructure Services: "Ao colaborar com a AMD e utilizar sua DPU programável e software de serviços de segurança e SDN pronto para uso, a IBM Cloud conseguiu acelerar o lançamento no mercado da nossa premiada oferta de "servidores bare-metal de alto desempenho para VPC" para cargas de trabalho VMware, Red Hat e SAP, impulsionando melhorias significativas na produtividade da rede para os clientes, e obter uma economia de 30% no custo total de propriedade com a maior densidade da carga de trabalho e núcleos de CPU preservados." – Publicado em amd.com: https://www.amd.com/pt/solutions/data-center/data-center-ai-premiere/industry-support.html
  6. Gerald de Grace, Líder na Microsoft Azure Accelerated Connections: "Nossa colaboração com a AMD usando o dispositivo inteligente baseado na DPU AMD Pensando e o software AMD completo em produção para conexões aceleradas resultou em uma melhoria de 100 vezes no desempenho de CPS em relação à nossa solução existente e se estenderá a níveis mais amplos dentro da rede Azure no futuro."