
AI 시대를 위한 스케일 아웃 네트워킹
AMD AI NIC™ 기술은 여러 세대의 혁신에 기반하여 구축되었으며, 하이퍼스케일러 및 클라우드 서비스 공급업체가 안심하고 AI 인프라를 확장할 수 있도록 프로그래밍 가능한 고성능 개방형 네트워킹을 제공합니다.
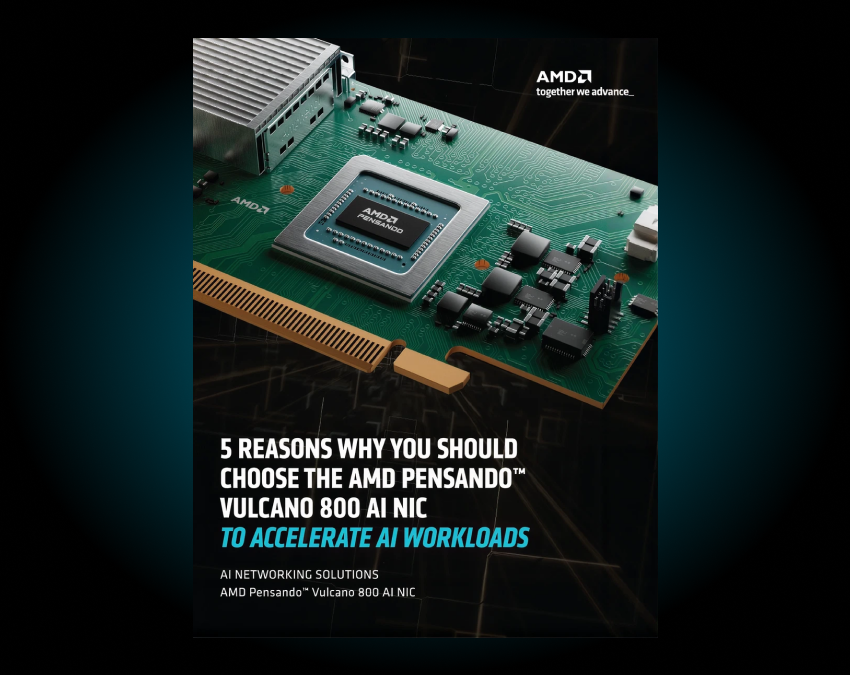
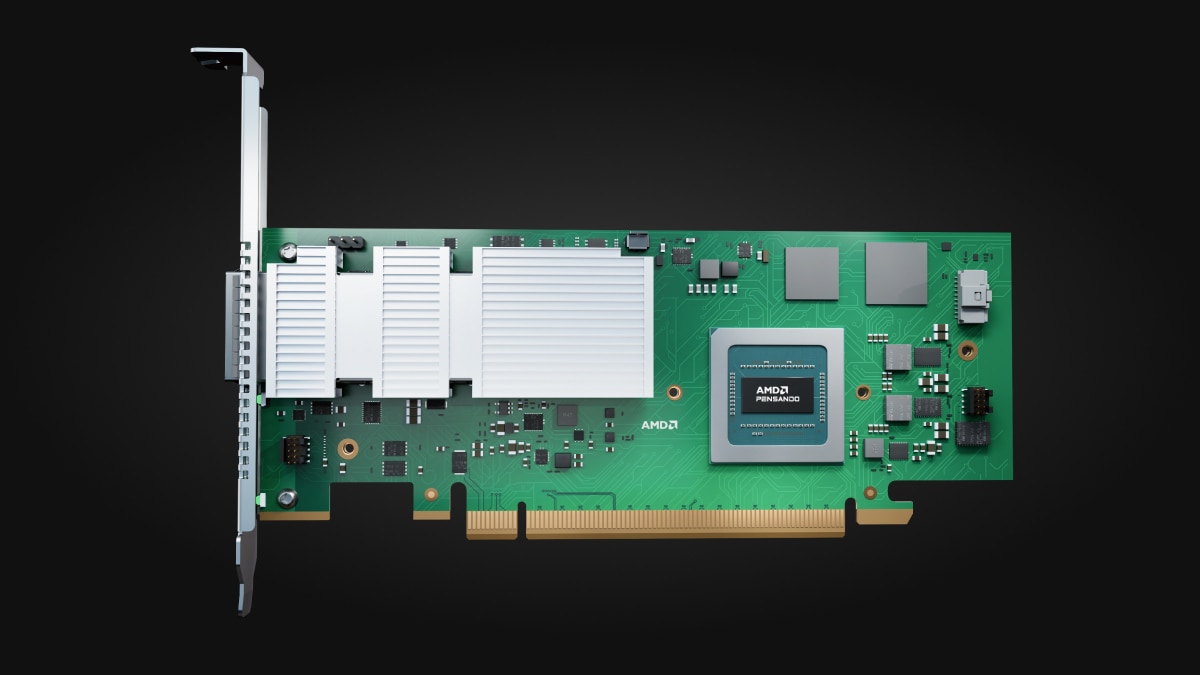
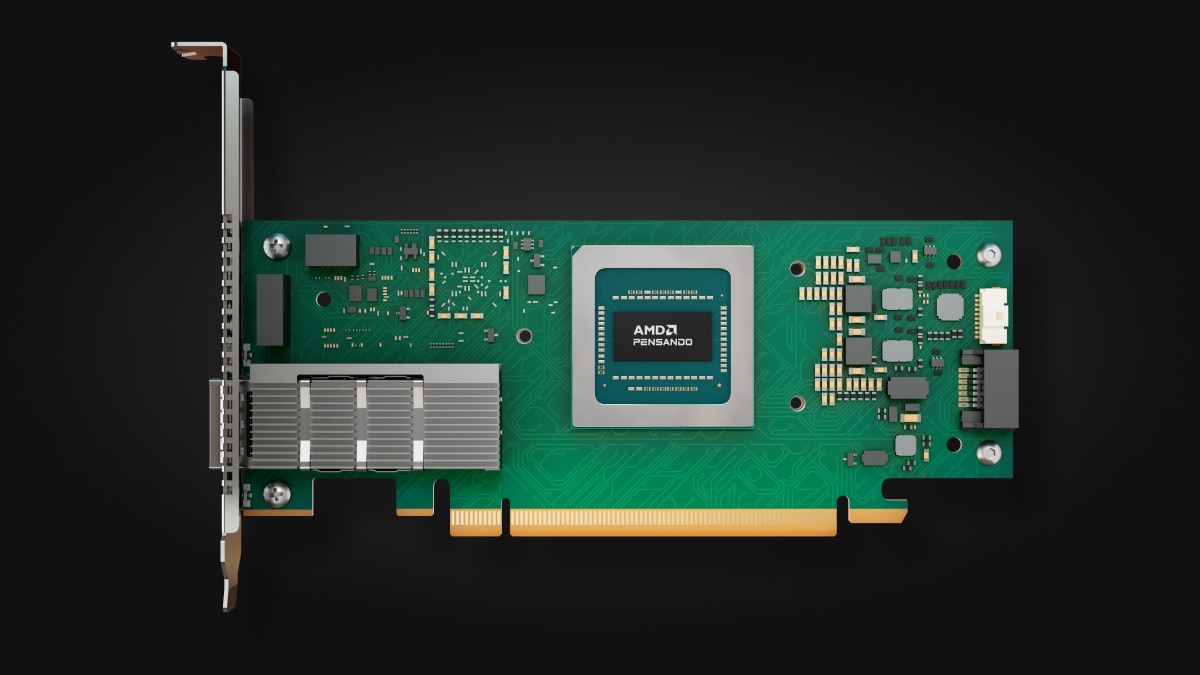
AMD Pensando™ Vulcano 800 AI NIC
AMD Pensando™ Vulcano 800 AI NIC는 GPU당 최대 2.4Tbps의 스케일 아웃 대역폭을 지원하는 업계 유일의 AI NIC로, 가장 까다로운 AI 워크로드에 필요한 고속 연결성을 제공합니다.
더 빠른 AI 성능
클러스터 가동 시간 향상
CAPEX 지출 절감
운영 우수성 개선

숫자로 보는 AMD Pensando™ Vulcano 800 AI NIC
대규모 모델 학습부터 배포 준비까지 걸리는 시간을 단축합니다.
개방형 시스템은 더욱 비용 효율적이고 확장성이 높은 AI 인프라를 지원합니다.
AMD Pensando™ Vulcano 800 AI NIC에 대해 자세히 알아보세요
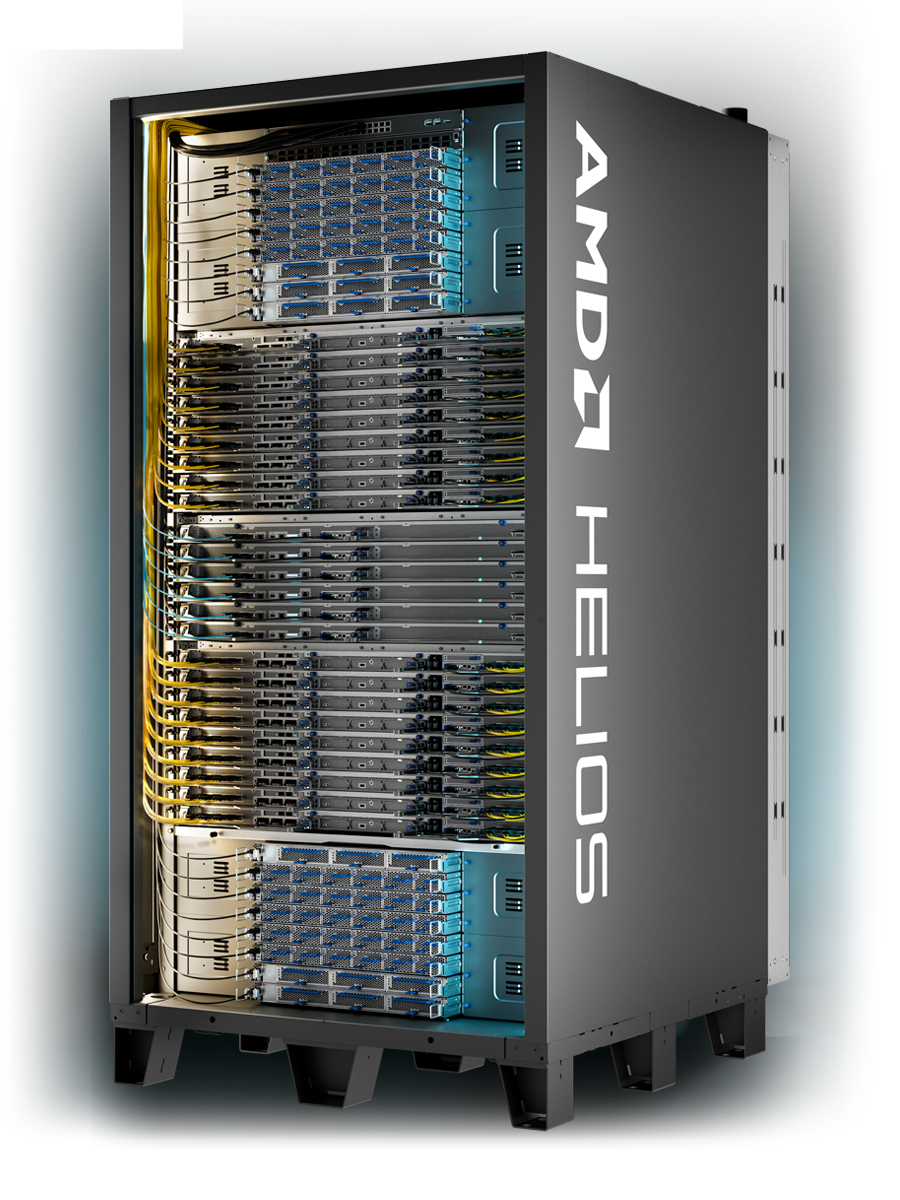
프런티어 AI를 위한 AMD Helios 랙스케일 솔루션3
AMD Helios 랙스케일 솔루션 디자인은 최신 AMD Instinct™ GPU, AMD EPYC™ 서버 CPU, AMD Pensando™ 네트워킹을 결합한 완전 통합 AI 인프라이며 대규모 추론, 프런티어 모델 학습 및 미세 조정을 지원하는 개방형 산업 표준을 사용하여 설계되었습니다.
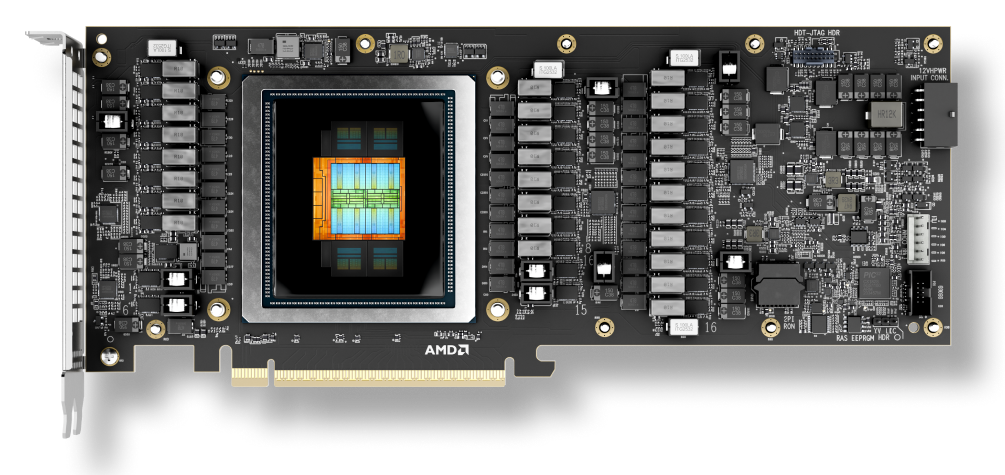
AMD Instinct™ MI350P PCIe® 카드
AMD의 Instinct MI350P PCIe 카드는 인프라 변경이 거의 또는 전혀 없어도 산업 전반에 걸쳐 생성 AI 워크로드의 확장성을 높일 수 있는 실용적인 경로를 제공합니다. 4세대 AMD cDNA™ 아키텍처로 제작된 이 PCIe 기반 카드는 강력한 풀 스택 엔터프라이즈 중심 소프트웨어 스택과 함께 메인스트림 엔터프라이즈 워크로드에 탁월한 효율성과 성능을 제공하여 배포를 단순화합니다.
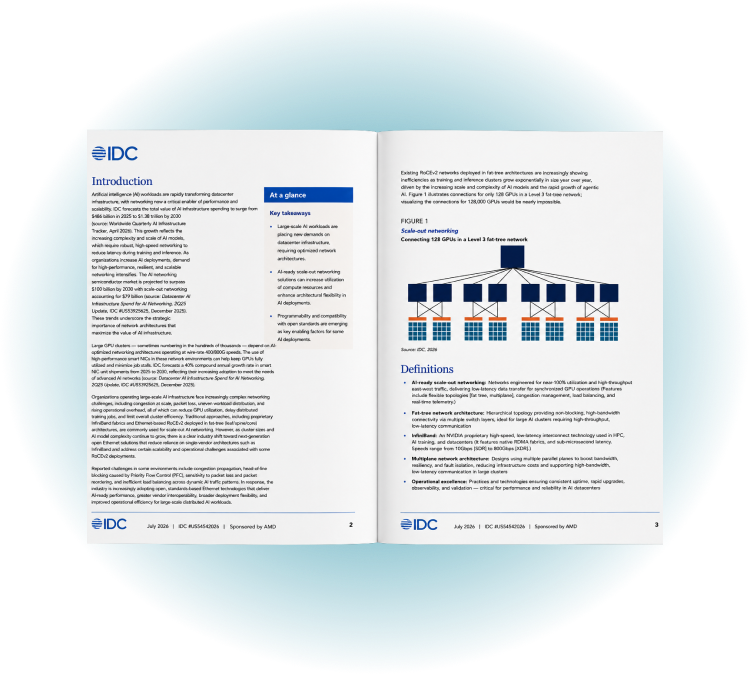
AI 워크로드를 위한 AI 기반 스케일 아웃 네트워킹 지원
스케일 아웃 네트워킹으로 GPU 활용성을 높이고 AI 작업을 가속화하고 AI 인프라 확장 비용을 절감하는 방법에 대해 알아보세요.
프로토콜 선택을 지원하는 프로그램 가능성
AMD AI NIC™ 기술은 완전히 프로그래밍 가능한 P4 엔진을 기반으로 구축되어 UEC 지원 RDMA 및 MRC(Multipath Reliable Connection)와 같은 프로토콜은 물론 맞춤형 전송까지 지원하며, 표준이 발전함에 따라 기능을 조정하고 업그레이드할 수 있습니다.
- 지능형 패킷 스프레이
- 비순차적 패킷 처리 및 순차적 메시지 전달
- 선택적 재전송
- 경로 인식 혼잡 제어
- 신속한 오류 탐지
지능형 패킷 스프레이
지능형 패킷 스프레이를 통해 팀은 로드 밸런싱을 강화하고 전반적인 효율성 및 확장성을 높임으로써 네트워크 성능을 원활하게 최적화할 수 있습니다. 네트워크 성능이 향상되면 GPU 간 통신 시간이 크게 단축되어 작업 완료 속도가 빨라지고 운영 효율성이 더욱 향상됩니다.
비순차적 패킷 처리 및 순차적 메시지 전달
다중 경로 및 패킷 스프레이 기술을 사용하는 경우에도 메시지가 올바른 순서로 전달되도록 보장합니다. 고급 비순차적 메시지 전달 기능은 순서를 벗어나 도착할 수 있는 데이터 패킷을 효율적으로 처리하여 버퍼링 없이 GPU 메모리에 직접 원활하게 배치합니다.
선택적 재전송
제외되거나 손상된 패킷만 다시 전송되도록 하는 SACK(Selective Acknowledgment) 재전송으로 네트워크 성능을 향상합니다. SACK은 손실되거나 손상된 패킷을 효율적으로 탐지하고 재전송하여 대역폭 사용률을 최적화하고, 패킷 손실 복구 시 지연율을 줄이며, 중복 데이터 전송을 최소화하여 탁월한 효율성을 달성합니다.

경로 인식 혼잡 제어
실시간 원격 측정 및 네트워크 인식 알고리즘을 통해 네트워크 모니터링이 아닌 워크로드에 집중할 수 있습니다. 경로 인식 혼잡 제어 기능은 네트워크 성능 관리를 간소화하므로 팀은 심각한 문제를 신속하게 탐지하고 해결하면서 인캐스트 시나리오의 영향을 완화하도록 지원할 수 있습니다.
신속한 오류 탐지
신속한 오류 탐지를 통해 팀은 몇 밀리초 이내에 문제를 정확히 찾아낼 수 있으므로 거의 즉각적인 페일오버 복구를 지원하고 GPU 다운타임을 크게 줄일 수 있습니다. 실시간에 가까운 지연율 지표, 혼잡 및 제외 통계를 통해 향상된 네트워크 관측성을 활용할 수 있습니다.
제품 포트폴리오
주목받는 AMD AI 네트워킹 기술
파트너
- OEM 및 ODM
- 인프라 솔루션
- 스토리지
- 스위칭
- 생태계







리소스

문의하기
AI 네트워킹의 미래를 열다
AMD Pensando Pollara 400 AI NIC가 스케일 아웃 AI 인프라를 어떻게 혁신할 수 있는지 알아보세요.
데이터 센터 네트워킹 살펴보기
고성능 첨단 데이터 센터를 위해 설계된 AMD 네트워킹 솔루션의 전체 제품군을 살펴보세요.
각주
- AMD 엔지니어링 실리콘 모델링 및 AMD 합성 벤치마크 시뮬레이션을 기반으로, MOE_4p5T hi_sparsity_ea9 벤치마크 테스트를 사용하여 8000개의 AMD Instinct MI455X GPU 및 (3) vs (2) AMD Pensando Vulcano NIC로 모델링된 시뮬레이션된 LLM 시스템에서 FP8 학습 데이터 유형으로 해결 시간 향상(일)을 예상합니다.
결과는 순수 학습 컴퓨팅(디코딩 레이어만 해당)의 분석을 반영합니다. 구성은 SwiGLU 활성화를 사용하여 4096의 전역 배치 크기, 4K의 시퀀스 길이로 평가되었습니다. 평가 및 체크포인팅 오버헤드는 결과에서 제외됩니다. matmul–softmax 오버랩 포함 FlashAttention v3를 가정합니다. AllReduce 및 All2All 통신 비용이 완벽하게 반영되며, 타일형 연산-통신 오버랩을 통해 은닉되지 않습니다. 그레이디언트 동기화 및 FSDP 중량 프리페치는 스케일 아웃 감도를 평가하기 위해 다양한 오버랩 수준에서 평가됩니다. 결과는 이상적이고 완전히 최적화되지 않은 실제 동작을 가정하며, 실제 제품이 출시되면 달라질 수 있습니다. MI400-018
- PEN-022: 2026년 5월 18일 기준, GPU 32,000대를 지원할 수 있는 네트워크 패브릭 비용을 비교 및 분석했습니다. 1.6T Tomahawk 6 스위칭 및 200G SerDes 기반 네트워크에서 Helios 랙스케일 시스템의 일부로 배포된 Vulcano 기반 NIC(VULCANO-CUSTOM-2.4T)와 800G Tomahawk 6 스위칭 및 100G SerDes 기반 800G NIC을 사용하여 비교했습니다. 두 패브릭 모두 Tomahawk 5 800G 스위칭 플랫폼을 기반으로 구축된 팻트리 토폴로지이며, NIC 비용이 유사한 것으로 간주되었습니다. Vulcano 기반 설계는 더 적은 수의 전환 플랫폼, 네트워크 포트당 더 큰 대역폭, 트랜시버 케이블/옵틱 감소를 통해 더욱 비용 효율적인 아키텍처를 구현함으로써 네트워크 전환 비용을 최대 33% 절감할 수 있을 것으로 예상됩니다.
TH6-100G Serdes 팻트리(경쟁):
스위칭(TH6C BCM78914 - 128x800G):
• Leaf 유닛 1,000
• Spine 유닛 500
•총 스위치 1,500
• TH6 100G 유닛 가격 $79,587
• 총 스위칭 비용 $60M
케이블/옵틱:
• NIC 트랜시버(800G-DR8) 64,000 @ $500
• Leaf/Spine 트랜시버(800G-DR8) 192,000 @ $500
• MPO 케이블 256,000 @ $89
• 총 옵틱/케이블 $64M
총 패브릭 비용 TH6-100G(스위치 + 케이블/옵틱): $124M
TH6-200G Serdes 팻트리(Vulcano-Custom2.4T / AMD 솔루션):
스위칭(TH6P BCM78910 - 64x1.6T):
• Leaf 유닛 1,000
• Spine 유닛 500
•총 스위치 1,500
• TH6 200G 유닛 가격 $66,336
• 총 스위칭 비용 $50M
케이블/옵틱:
NIC 트랜시버(1.6T-DR8) 32,000 @ $900(경쟁 제품 대비 50% 감소)
Leaf/Spine 트랜시버(1.6T-DR8) 64,000 @ $900
MPO 케이블 128,000 @ $89(경쟁 제품 대비 50% 감소)
총 옵틱/케이블 $43M
총 패브릭 비용 TH6-200G(스위치 + 케이블/옵틱): $93M
CAPEX 절감(패브릭 전용):
절감액: $30.7M
절감률: 33.1%
가격 출처: SemiAnalysis Hyperscaler Networking Model 데이터는 허가를 받아 사용되었습니다. 전체 분석 내용은 SemiAnalysis 구독을 통해 확인할 수 있습니다. Edgecore 스위치 가격은 2026년 5월 17일 기준입니다. 결과는 시스템 구성에 따라 달라질 수 있습니다.
- 계산은 2025년 6월, AMD 퍼포먼스 랩에서 AMD Instinct™ MI455X 72xGPU “Helios” AI 랙의 예상 메모리 용량/대역폭, 스케일 업/아웃 대역폭 사양을 바탕으로 NVIDIA “Vera Rubin” 72xGPU “Oberon” 랙의 공개적으로 발표된 사양을 비교하여 수행했습니다. 서버 제조업체별 구성에 따라 다른 결과가 나올 수 있습니다. MI350-045A
계산은 2025년 9월, AMD 퍼포먼스 랩에서 AMD Instinct™ MI455X 72xGPU “Helios” AI 랙의 FP8/FP4 데이터 유형 및 예상 사양을 바탕으로 NVIDIA “Vera Rubin” 72xGPU “Oberon” AI 랙의 공개적으로 발표된 사양을 비교하여 수행했습니다. 프로덕션 실리콘에 따라 실제 결과는 다를 수 있습니다. 서버 제조업체별 구성에 따라 다른 결과가 나올 수 있습니다. MI350-046B
- AMD 엔지니어링 실리콘 모델링 및 AMD 합성 벤치마크 시뮬레이션을 기반으로, MOE_4p5T hi_sparsity_ea9 벤치마크 테스트를 사용하여 8000개의 AMD Instinct MI455X GPU 및 (3) vs (2) AMD Pensando Vulcano NIC로 모델링된 시뮬레이션된 LLM 시스템에서 FP8 학습 데이터 유형으로 해결 시간 향상(일)을 예상합니다.
결과는 순수 학습 컴퓨팅(디코딩 레이어만 해당)의 분석을 반영합니다. 구성은 SwiGLU 활성화를 사용하여 4096의 전역 배치 크기, 4K의 시퀀스 길이로 평가되었습니다. 평가 및 체크포인팅 오버헤드는 결과에서 제외됩니다. matmul–softmax 오버랩 포함 FlashAttention v3를 가정합니다. AllReduce 및 All2All 통신 비용이 완벽하게 반영되며, 타일형 연산-통신 오버랩을 통해 은닉되지 않습니다. 그레이디언트 동기화 및 FSDP 중량 프리페치는 스케일 아웃 감도를 평가하기 위해 다양한 오버랩 수준에서 평가됩니다. 결과는 이상적이고 완전히 최적화되지 않은 실제 동작을 가정하며, 실제 제품이 출시되면 달라질 수 있습니다. MI400-018 - PEN-022: 2026년 5월 18일 기준, GPU 32,000대를 지원할 수 있는 네트워크 패브릭 비용을 비교 및 분석했습니다. 1.6T Tomahawk 6 스위칭 및 200G SerDes 기반 네트워크에서 Helios 랙스케일 시스템의 일부로 배포된 Vulcano 기반 NIC(VULCANO-CUSTOM-2.4T)와 800G Tomahawk 6 스위칭 및 100G SerDes 기반 800G NIC을 사용하여 비교했습니다. 두 패브릭 모두 Tomahawk 5 800G 스위칭 플랫폼을 기반으로 구축된 팻트리 토폴로지이며, NIC 비용이 유사한 것으로 간주되었습니다. Vulcano 기반 설계는 더 적은 수의 전환 플랫폼, 네트워크 포트당 더 큰 대역폭, 트랜시버 케이블/옵틱 감소를 통해 더욱 비용 효율적인 아키텍처를 구현함으로써 네트워크 전환 비용을 최대 33% 절감할 수 있을 것으로 예상됩니다.
TH6-100G Serdes 팻트리(경쟁):
스위칭(TH6C BCM78914 - 128x800G):
• Leaf 유닛 1,000
• Spine 유닛 500
•총 스위치 1,500
• TH6 100G 유닛 가격 $79,587
• 총 스위칭 비용 $60M
케이블/옵틱:
• NIC 트랜시버(800G-DR8) 64,000 @ $500
• Leaf/Spine 트랜시버(800G-DR8) 192,000 @ $500
• MPO 케이블 256,000 @ $89
• 총 옵틱/케이블 $64M
총 패브릭 비용 TH6-100G(스위치 + 케이블/옵틱): $124M
TH6-200G Serdes 팻트리(Vulcano-Custom2.4T / AMD 솔루션):
스위칭(TH6P BCM78910 - 64x1.6T):
• Leaf 유닛 1,000
• Spine 유닛 500
•총 스위치 1,500
• TH6 200G 유닛 가격 $66,336
• 총 스위칭 비용 $50M
케이블/옵틱:
NIC 트랜시버(1.6T-DR8) 32,000 @ $900(경쟁 제품 대비 50% 감소)
Leaf/Spine 트랜시버(1.6T-DR8) 64,000 @ $900
MPO 케이블 128,000 @ $89(경쟁 제품 대비 50% 감소)
총 옵틱/케이블 $43M
총 패브릭 비용 TH6-200G(스위치 + 케이블/옵틱): $93M
CAPEX 절감(패브릭 전용):
절감액: $30.7M
절감률: 33.1%
가격 출처: SemiAnalysis Hyperscaler Networking Model 데이터는 허가를 받아 사용되었습니다. 전체 분석 내용은 SemiAnalysis 구독을 통해 확인할 수 있습니다. Edgecore 스위치 가격은 2026년 5월 17일 기준입니다. 결과는 시스템 구성에 따라 달라질 수 있습니다. - 계산은 2025년 6월, AMD 퍼포먼스 랩에서 AMD Instinct™ MI455X 72xGPU “Helios” AI 랙의 예상 메모리 용량/대역폭, 스케일 업/아웃 대역폭 사양을 바탕으로 NVIDIA “Vera Rubin” 72xGPU “Oberon” 랙의 공개적으로 발표된 사양을 비교하여 수행했습니다. 서버 제조업체별 구성에 따라 다른 결과가 나올 수 있습니다. MI350-045A
계산은 2025년 9월, AMD 퍼포먼스 랩에서 AMD Instinct™ MI455X 72xGPU “Helios” AI 랙의 FP8/FP4 데이터 유형 및 예상 사양을 바탕으로 NVIDIA “Vera Rubin” 72xGPU “Oberon” AI 랙의 공개적으로 발표된 사양을 비교하여 수행했습니다. 프로덕션 실리콘에 따라 실제 결과는 다를 수 있습니다. 서버 제조업체별 구성에 따라 다른 결과가 나올 수 있습니다. MI350-046B