

Das Netzwerk für KI-Workloads neu erfinden
Tauchen Sie ein in die Zukunft der speziell für KI-Workloads entwickelten Rechenzentren – mit den offenen Netzwerklösungen von AMD Pensando™. Diese wegweisende Suite leistungsstarker, programmierbarer und offener Produkte verbessert das Netzwerk ganzheitlich und hebt es auf ein neues Niveau.



Antrieb für das Frontend-Netzwerk: AMD Pensando™ DPUs
Für KI-Workloads freigewordene CPU-Ressourcen durch die Beschleunigung der Datenübertragungs- und Infrastrukturdienste auf Wirespeed.
Erweiterbare Netzwerke für sich weiterentwickelnde KI-Workloads
Moderne KI-Modelle sind für eine einzelne GPU mittlerweile zu groß geworden. Erweiterbare Netzwerke verbinden mehrere GPUs innerhalb eines Systems oder Racks zu einer einzigen Rechendomäne und bieten so die ultrahohe Bandbreite und geringe Latenz, die flächendeckende Workloads wie agentische KI erfordern.


Erweiterung und horizontale Skalierung mit AI NICs
Wenn sich KI-Workloads über Server, Racks und Rechenzentren erstrecken, ist eine nahtlose GPU-zu-GPU-Konnektivität von entscheidender Bedeutung. Die AMD AI NIC™ Technologie treibt die Hochgeschwindigkeitssynchronisation an, die von flächendeckender KI benötigt wird.
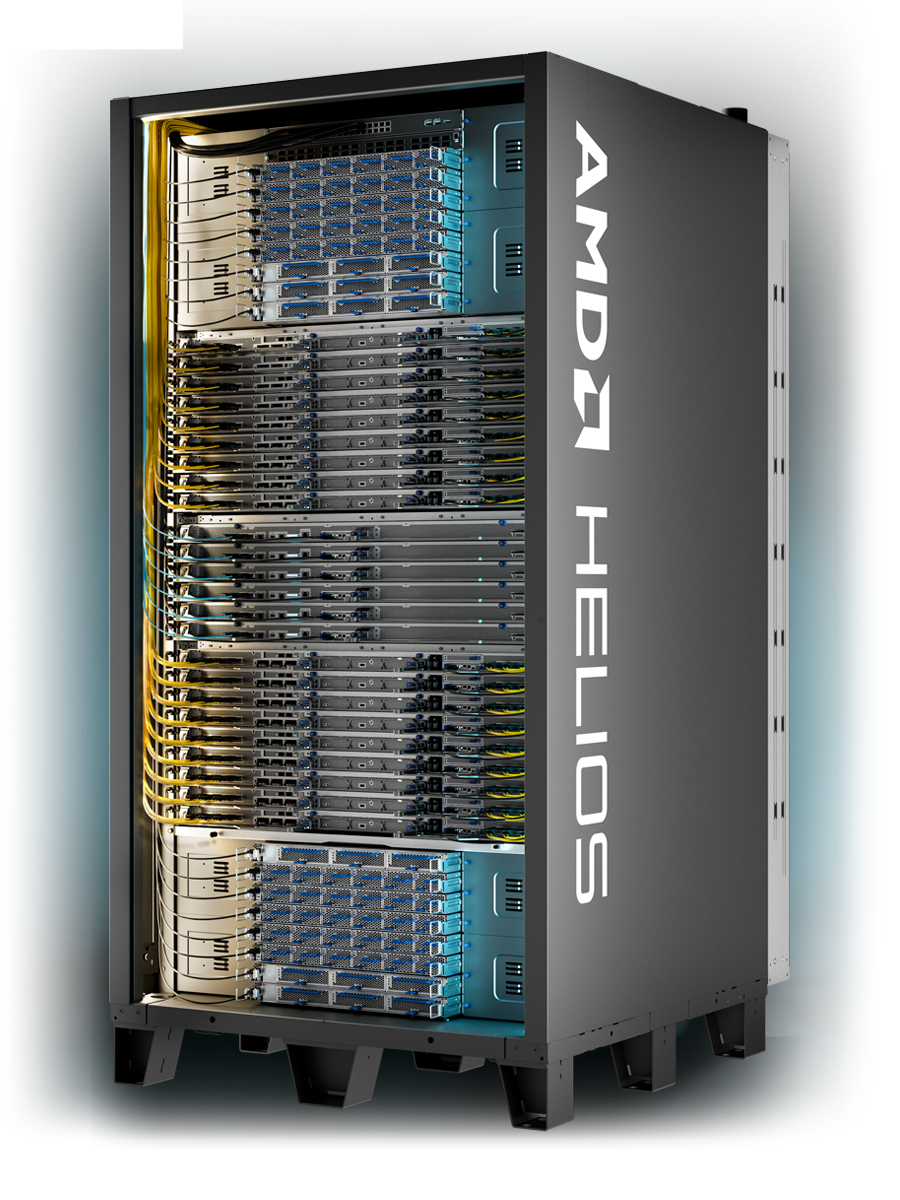
AMD Helios: Führende Rack-Performance für Hyperscale AI1
Die AMD Helios Rack-Scale-Lösung ist eine vollständig integrierte KI-Infrastruktur, die die neuesten AMD Instinct™ GPUs, AMD EPYC™ Server-CPUs sowie die AMD Pensando™ Netzwerktechnologie zusammenführt. Sie wurde auf Basis offener Industriestandards entwickelt und ermöglicht flächendeckende Inferenz sowie Training und Feinkalibrierung von Frontier-Modellen.
AMD Pensando™ Vulcano 800 AI NIC
Bis zu 13 % schnellerer Abschluss von KI-Aufträgen2 mit der einzigen KI-Netzwerkkarte auf dem Markt, die pro GPU eine auf bis zu 2,4 Tbit/s erweiterbare Bandbreite unterstützt.


Bereitstellung von KI-fähigen, erweiterbaren Netzwerken für KI-Workloads
So verbessern erweiterbare Netzwerke die GPU-Auslastung, beschleunigen KI-Aufträge und senken die Kosten für die Skalierung der KI-Infrastruktur.
Adapter und CPUs
Die Welt handelt mit AMD Solarflare™ Netzwerkadaptern mit niedriger Latenz
Speziell entwickelte Chips, Software und Adapter für Kapitalmärkte
9 von 10 globalen Börsen setzen für den Handel Solarflare Solutions ein3


AMD x86 Embedded-Prozessoren
AMD x86 Embedded Prozessoren bieten Rechenleistung mit hohem Durchsatz, stabilen E/A und Skalierbarkeit für Anwendungen wie Firewalls, Router und Netzwerkgeräte und stellen so Performance, Effizienz und langfristige Zuverlässigkeit an der Edge oder im Rechenzentrum bereit.

Ressourcen
Für Performance in jeder Größenordnung konzipieren wir das Netzwerk auf Basis offener Standards
Fußnoten
- Berechnungen durchgeführt vom AMD Leistungslabor im Juni 2025 basierend auf den prognostizierten Spezifikationen hinsichtlich der Speicherkapazität/Bandbreite sowie der Skalierungs-/Erweiterungsbandbreite des AMD Instinct™ MI455X 72xGPU „Helios“ KI-Racks im Vergleich zum offiziell angekündigten NVIDIA „Vera Rubin“ 72xGPU „Oberon“-KI-Rack. Serverhersteller wählen möglicherweise andere Konfigurationen, was zu anderen Ergebnissen führen kann. MI350-045A.
Berechnungen durchgeführt vom AMD Leistungslabor im September 2025 basierend auf den Datentypen FP8/FP4 und den prognostizierten Spezifikationen für das AMD Instinct™ MI455X 72xGPU „Helios“-KI-Rack im Vergleich zu den offiziell bekannt gegebenen Spezifikationen für das NVIDIA „Vera Rubin“ 72xGPU „Oberon“-KI-Rack. Die tatsächlichen Ergebnisse auf Basis von Chips aus der Produktion können abweichen. Serverhersteller wählen möglicherweise andere Konfigurationen, was zu anderen Ergebnissen führen kann. MI350-046B.
- Basierend auf Halbleitermodellierungen von AMD Engineering und synthetischen Benchmark-Simulationen von AMD wurde mithilfe des Benchmark-Tests MOE_4p5T hi_sparsity_ea9 die Beschleunigung der Zeit in Tagen von der Projektierung bis zur Lösung unter Einsatz des FP8-Trainingsdatentyps auf einem mit 8.000 AMD Instinct MI455X GPUs und (3) vs. (2) AMD Pensando Vulcano AI NIC ausgestatteten LLM-Systemmodell simuliert.
Die Ergebnisse spiegeln die Analyse der reinen Trainingsberechnungen (nur Dekodierungsschichten) wider. Die Konfiguration wurde mit einer globalen Batchgröße von 4096 und einer Sequenzlänge von 4K unter Einsatz der SwiGLU-Aktivierung bewertet. Die Ergebnisse berücksichtigen nicht den Overhead für die Auswertung und die Checkpoints. FlashAttention V3 mit matmul–softmax overlap wurde als gegeben angenommen. Die Kommunikationskosten für AllReduce und All2All wurden vollständig berücksichtigt und nicht mithilfe von Tiled Compute-Communication overlap verdeckt. Der Gradientenabgleich und das FSDP-Gewichte-Vorauslesen wurden für die Bewertung der Erweiterbarkeit bei unterschiedlichen Überlappungsgraden bewertet. Die Ergebnisse gehen von einem idealen und nicht vollständig optimierten Verhalten unter realen Bedingungen aus und können bei der Markteinführung der tatsächlichen Produkte abweichen. MI400-018.
- https://focus.world-exchanges.org/issue/june-2025/market-statistics, AMD Internal Sales Data
Fußnoten
- Berechnungen durchgeführt vom AMD Leistungslabor im Juni 2025 basierend auf den prognostizierten Spezifikationen hinsichtlich der Speicherkapazität/Bandbreite sowie der Skalierungs-/Erweiterungsbandbreite des AMD Instinct™ MI455X 72xGPU „Helios“ KI-Racks im Vergleich zum offiziell angekündigten NVIDIA „Vera Rubin“ 72xGPU „Oberon“-KI-Rack. Serverhersteller wählen möglicherweise andere Konfigurationen, was zu anderen Ergebnissen führen kann. MI350-045A.
Berechnungen durchgeführt vom AMD Leistungslabor im September 2025 basierend auf den Datentypen FP8/FP4 und den prognostizierten Spezifikationen für das AMD Instinct™ MI455X 72xGPU „Helios“-KI-Rack im Vergleich zu den offiziell bekannt gegebenen Spezifikationen für das NVIDIA „Vera Rubin“ 72xGPU „Oberon“-KI-Rack. Die tatsächlichen Ergebnisse auf Basis von Chips aus der Produktion können abweichen. Serverhersteller wählen möglicherweise andere Konfigurationen, was zu anderen Ergebnissen führen kann. MI350-046B. - Basierend auf Halbleitermodellierungen von AMD Engineering und synthetischen Benchmark-Simulationen von AMD wurde mithilfe des Benchmark-Tests MOE_4p5T hi_sparsity_ea9 die Beschleunigung der Zeit in Tagen von der Projektierung bis zur Lösung unter Einsatz des FP8-Trainingsdatentyps auf einem mit 8.000 AMD Instinct MI455X GPUs und (3) vs. (2) AMD Pensando Vulcano AI NIC ausgestatteten LLM-Systemmodell simuliert.
Die Ergebnisse spiegeln die Analyse der reinen Trainingsberechnungen (nur Dekodierungsschichten) wider. Die Konfiguration wurde mit einer globalen Batchgröße von 4096 und einer Sequenzlänge von 4K unter Einsatz der SwiGLU-Aktivierung bewertet. Die Ergebnisse berücksichtigen nicht den Overhead für die Auswertung und die Checkpoints. FlashAttention V3 mit matmul–softmax overlap wurde als gegeben angenommen. Die Kommunikationskosten für AllReduce und All2All wurden vollständig berücksichtigt und nicht mithilfe von Tiled Compute-Communication overlap verdeckt. Der Gradientenabgleich und das FSDP-Gewichte-Vorauslesen wurden für die Bewertung der Erweiterbarkeit bei unterschiedlichen Überlappungsgraden bewertet. Die Ergebnisse gehen von einem idealen und nicht vollständig optimierten Verhalten unter realen Bedingungen aus und können bei der Markteinführung der tatsächlichen Produkte abweichen. MI400-018. - https://focus.world-exchanges.org/issue/june-2025/market-statistics, AMD Internal Sales Data