智能体电脑时代的企业 AI 算力革命
Sep 28, 2026
一、智能体电脑/智能体主机:企业 AI 的新范式
2026 年初,以 OpenClaw 为代表的 AI 智能体迅速走红,部署和训练这类工具被网友形象地称为“养龙虾”。这股热潮让更多人第一次直观感受到,AI 已不再局限于回答问题,而是能够读取文件、调用工具、操作应用并自主完成多步骤任务。它也折射出企业 IT 环境过去两年的明显变化:大量基于大语言模型(LLM)的 AI 助手正从“呼叫—响应”模式加速迈向可执行的数字代理。
然而,智能体要真正“动手干活”,往往需要访问邮箱、文档、浏览器和本地应用等高权限资源。对企业而言,如何在释放智能体 AI 效率的同时保障数据主权、敏感信息不离开受信任环境,同时降低 Token 的消耗成本,已成为规模化部署的关键前提。正是在这一背景下,AI 计算开始跨越从被动响应到主动执行的门槛。智能体电脑/智能体主机凭借高性能本地AI算力,为企业在端点侧运行模型、处理私有数据并执行工作流提供了更可控的路径。
1.1 从 AI 助手到自主代理——三个演进阶段
AMD 将端点 AI 的演进划分为三个清晰阶段:
阶段 |
时间窗口 |
典型能力 |
算力需求 |
AI 助手 |
2023–2024 |
会议摘要、邮件优化、文件检索 |
数十 TOPS |
智能体 AI |
2025–2026 |
理解上下文、项目规划、收件箱分类、从说明文档生成演示文稿 |
多线程 CPU + 大内存 |
自主执行 |
2026 年及以后 |
完成多步骤工作流、操作私有数据、跨应用协调任务 |
高性能本地 AI |
1.2 智能体电脑/智能体主机的商业价值主张
对于企业决策者而言,智能体电脑/智能体主机的战略意义不仅在于提升员工效率,更在于从根本上重构 AI 使用的经济模型。
降低云推理成本:随着企业 AI Agent 部署规模扩大,智能体执行任务每一次云端推理调用都产生成本。智能体电脑/智能体主机 通过将更多 AI 工作负载本地化执行,直接削减 Token 消耗量,同时为更复杂的模型保留云端资源。
强化数据主权与合规:本地推理意味着敏感的企业数据无需离开端点设备,对金融、医疗、法律等强监管行业而言,这是合规框架下的关键诉求。
缩短响应延迟:本地执行消除了网络往返时延,Agent 执行多步骤工作流时的整体响应时间将显著缩短,提升用户体验。
实现 AI 工作流的完整闭环:Agentic AI 并非单一工作负载,而是一个端到端的工作流:意图解析 → 上下文检索 → 任务规划 → 工具调用 → 结果验证。这一工作流的每个环节对算力的需求各不相同,需要 CPU、GPU 与 NPU 协同发力。
二、AMD 锐龙 AI Max+ 495:旗舰芯片深度解析
2026 年 5 月,AMD 正式发布锐龙 AI Max PRO 400 系列处理器。旗舰型号锐龙 AI Max+ PRO 495 集成 16 核“Zen 5”CPU、Radeon 8065S 集成显卡、基于 XDNA 2 架构且算力最高可达 55 TOPS 的 NPU,最高支持 192 GB 统一内存,为新一代智能体 PC 与紧凑型工作站提供本地 AI 算力支撑。锐龙锐龙
2.1 Zen 5 CPU 架构
锐龙 AI Max+ PRO 495 集成 16 个“Zen 5”核心(32 线程)锐龙,基础频率 3.1 GHz,最高加速频率 5.2 GHz。与采用“Zen 5”+“Zen 5c”混合架构的锐龙 AI 400 系列(Gorgon Point)不同,锐龙 AI Max PRO 400 系列全系采用完整“Zen 5”核心,在重线程任务中具备明显优势。
在 AMD 指定测试集上,“Zen 5”相较“Zen 4”实现平均约 16% 的 IPC 提升(实际提升幅度视工作负载与应用而定),源自改进的分支预测器、更宽的执行引擎以及更高效的内存子系统。处理器支持完整的 AVX-512 指令集,对科学计算、数据分析及部分 AI 框架加速具有重要意义。
处理器搭载 16 MB L2 + 64 MB L3 缓存(总缓存 80 MB),配合 256 位 LPDDR5x-8533 内存控制器,为大型工作集提供充足的带宽储备。
2.2 Radeon 8065S 集成 GPU
集成显卡 Radeon 8065S 基于 RDNA 3.5 架构,配备 40 个计算单元(2560 个统一着色器),GPU 频率最高 3.0 GHz,其图形性能可与主流独立显卡相当。
对于企业用户而言,Radeon 8065S 的价值更多体现在其作为 AI 推理加速器的角色——与 NPU 协同,承担图形密集型 AI 推理任务,最多支持 4 路显示输出,单屏最高可实现 8K 60Hz(DisplayPort 2.1),满足专业创意工作站需求。
2.3 XDNA 2 NPU —— 本地 AI 推理引擎
处理器内置基于 XDNA 2 架构 的神经网络处理单元(NPU),算力至高达 55 TOPS,满足Windows 11 AI+ PC 对 NPU 至少40 TOPS 的算力要求。
2.4 统一内存架构:企业 AI 的关键优势
为了给企业私有化部署 本地 LLM 推理 提供关键支撑,锐龙 AI Max+ PRO 495 采用 256 位 LPDDR5x-8533 内存接口,最高支持 192 GB 统一内存(相较上一代锐龙 AI Max 300 系列处理器的最高 128 GB 提升 50%)。其中最高 160 GB 可划拨为专用显存²,用于图形和 AI 计算工作负载。锐龙 AI Max+ PRO 495是首款能够在本地运行 3000 亿(300B)参数以上模型的 x86 客户端处理器。
统一内存架构的核心优势在于消除了 CPU 与 GPU 之间的数据传输瓶颈。对于运行本地大模型推理、大规模数据分析或复杂 AI Agent 工作流的企业用户,这一架构意味着可以在单一设备上完成此前必须依赖数据中心 GPU 服务器才能完成的任务。
完整的产品规格,请参见产品参数页面。
三、合作伙伴整机产品矩阵
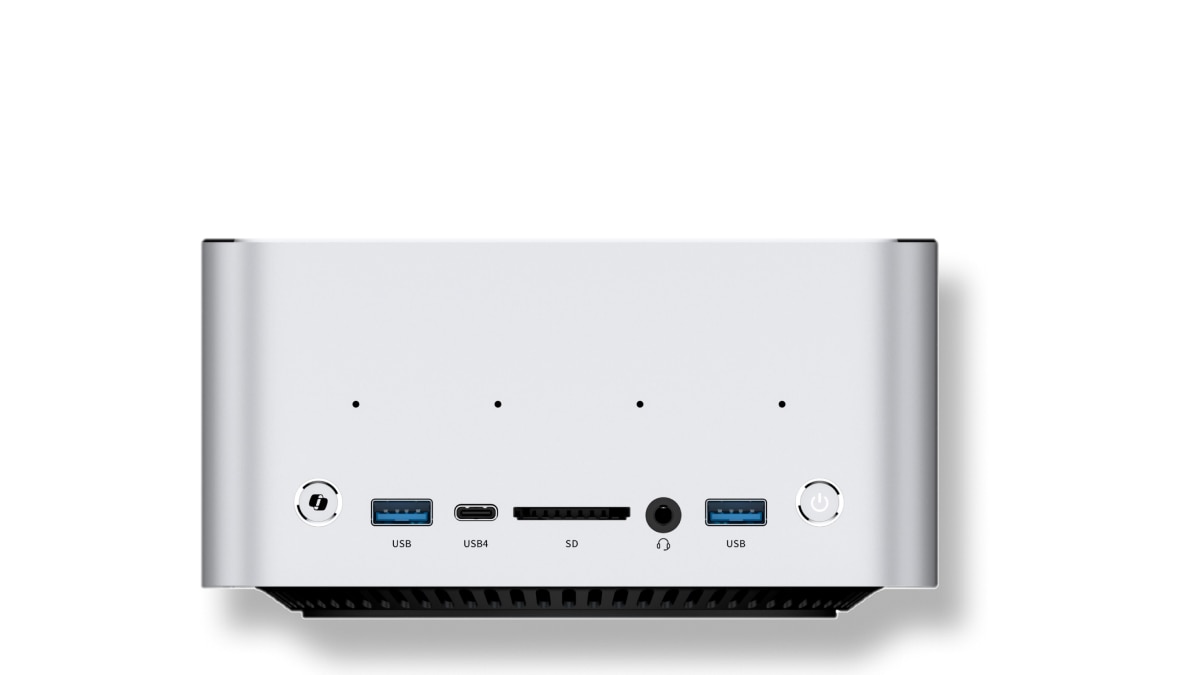
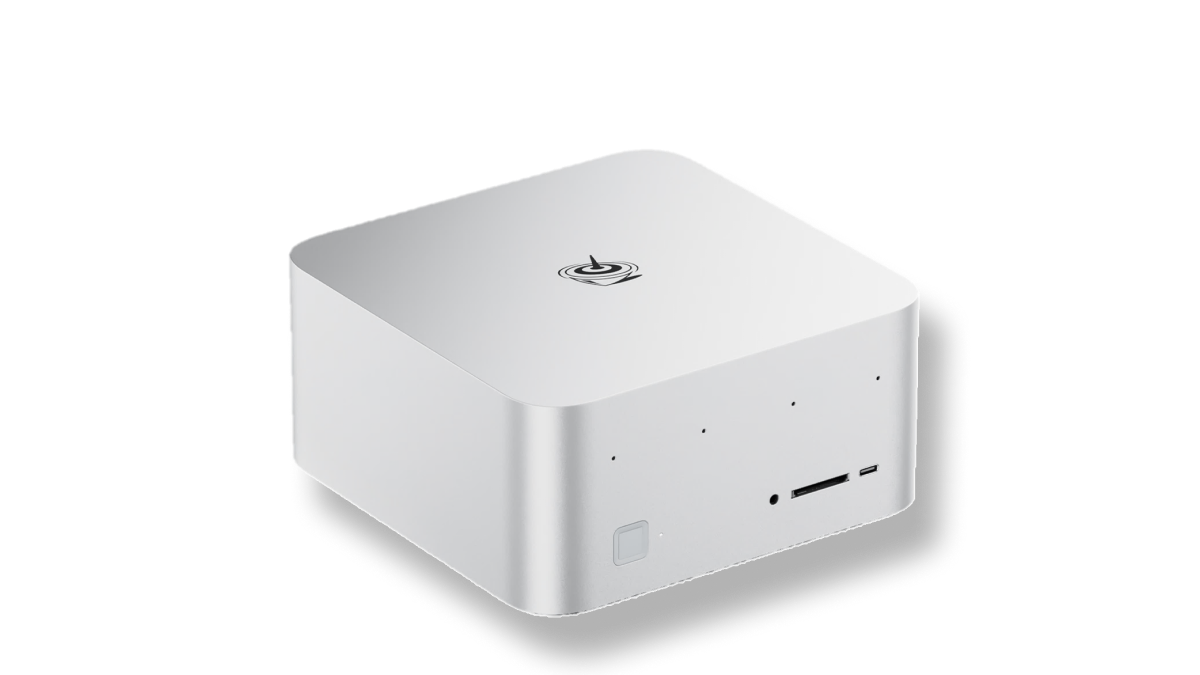
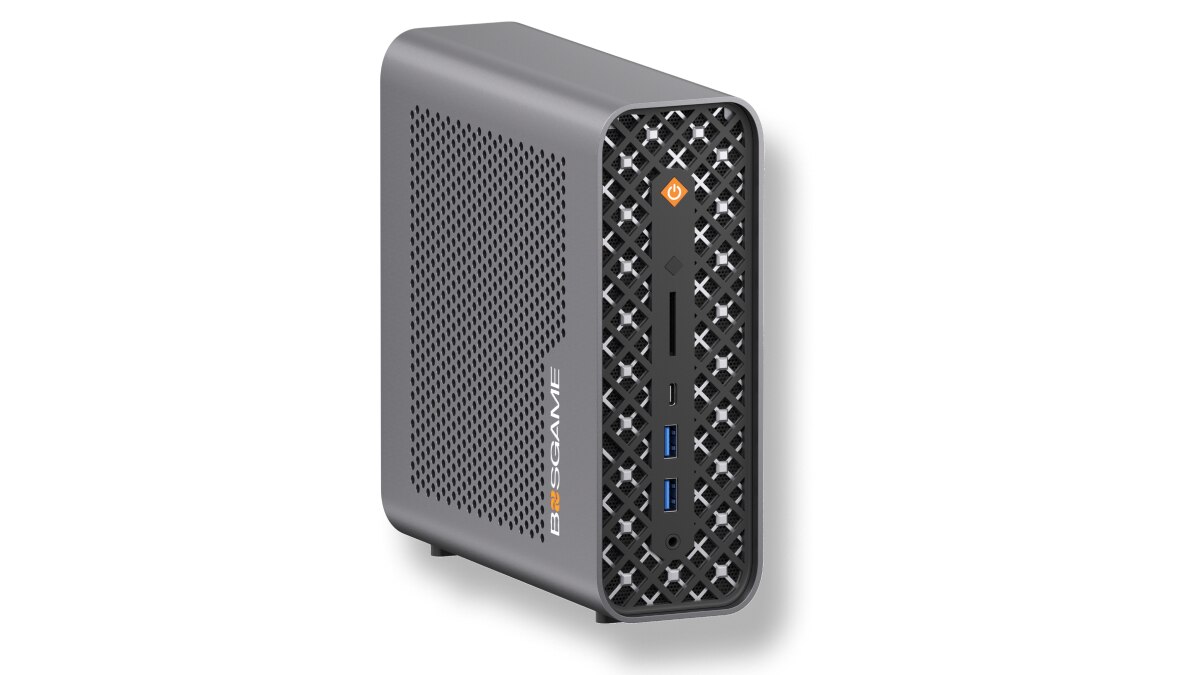
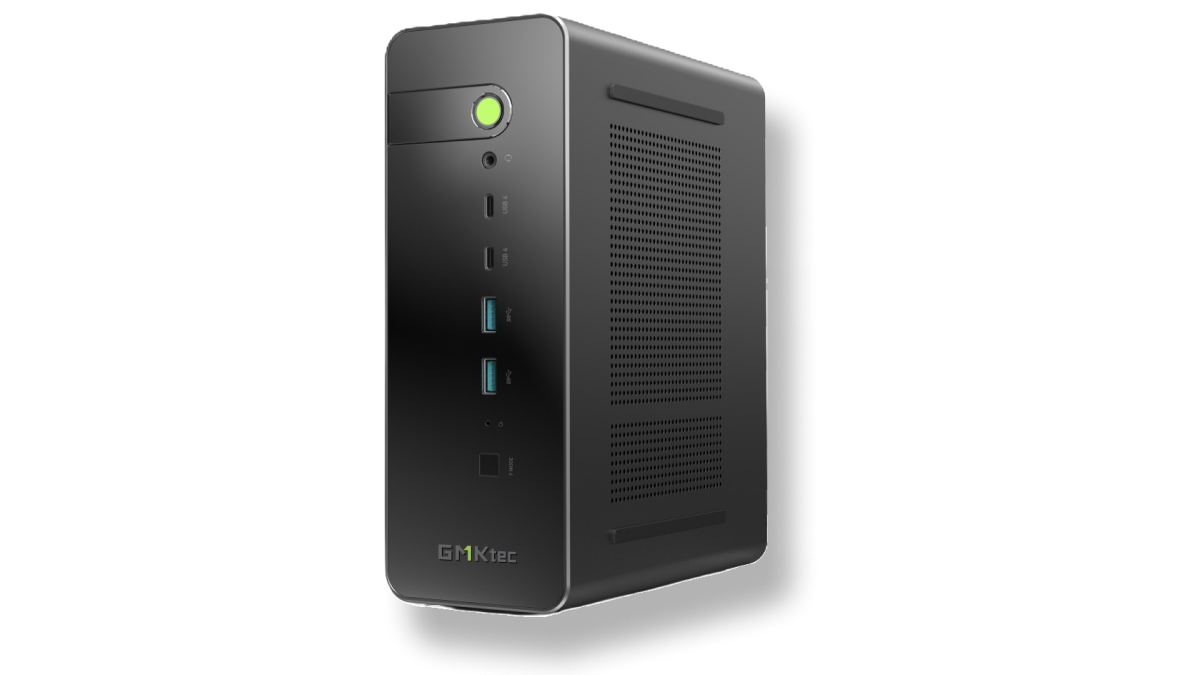
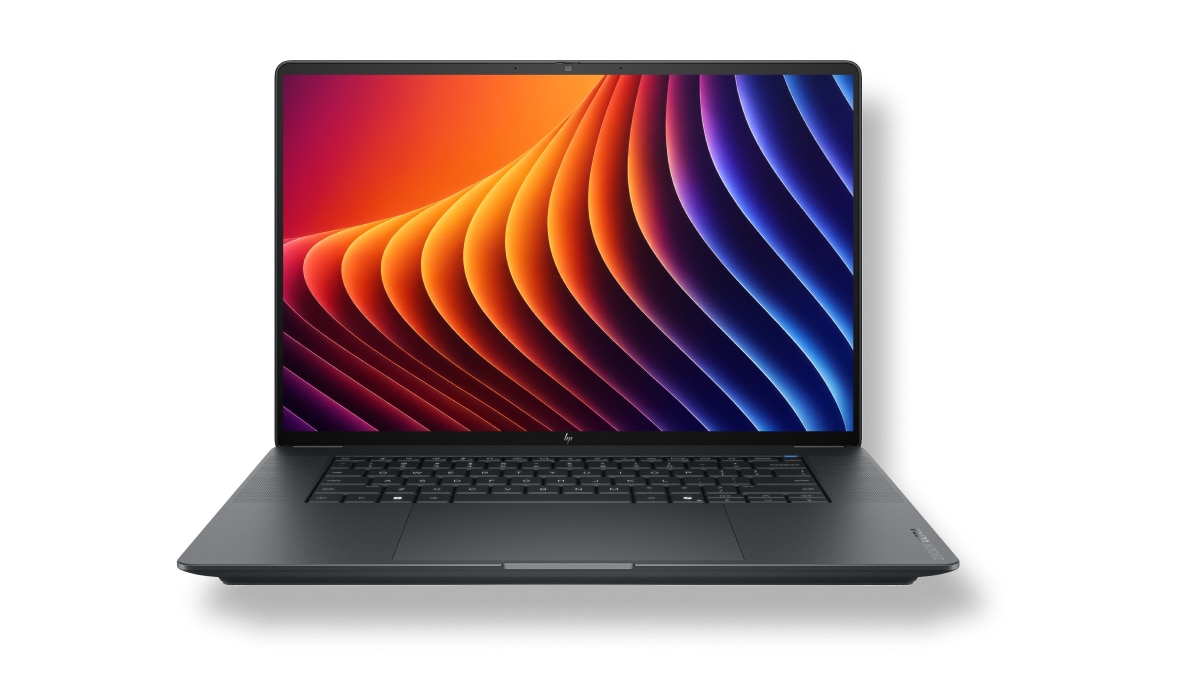
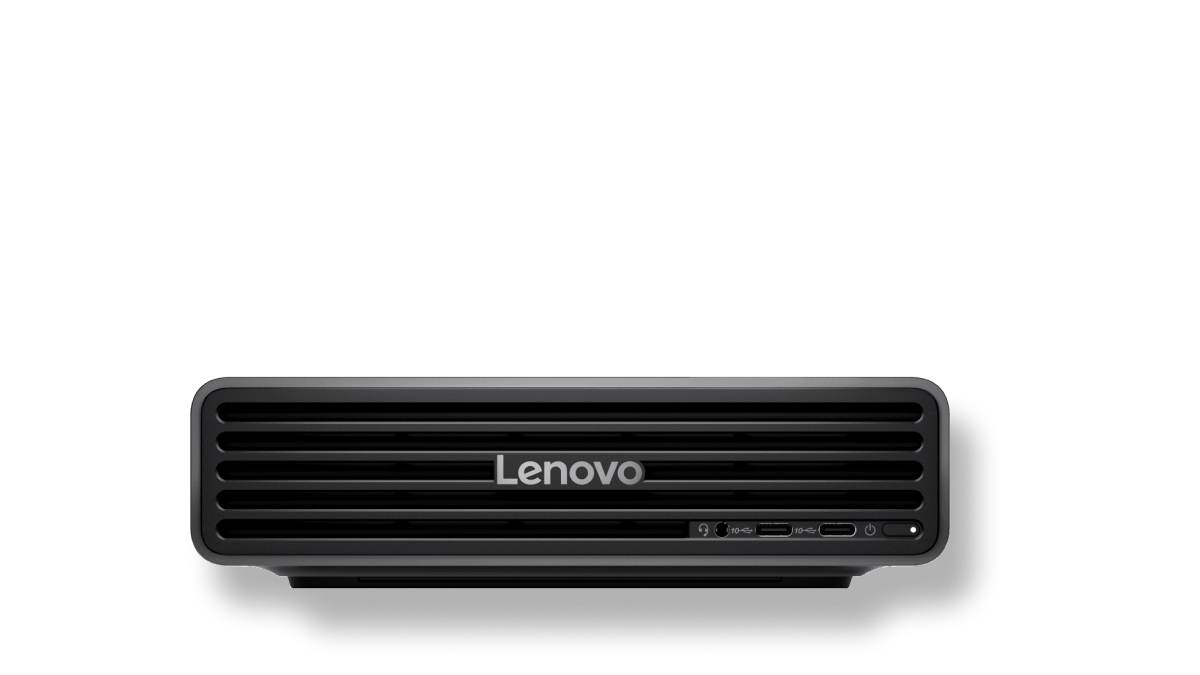
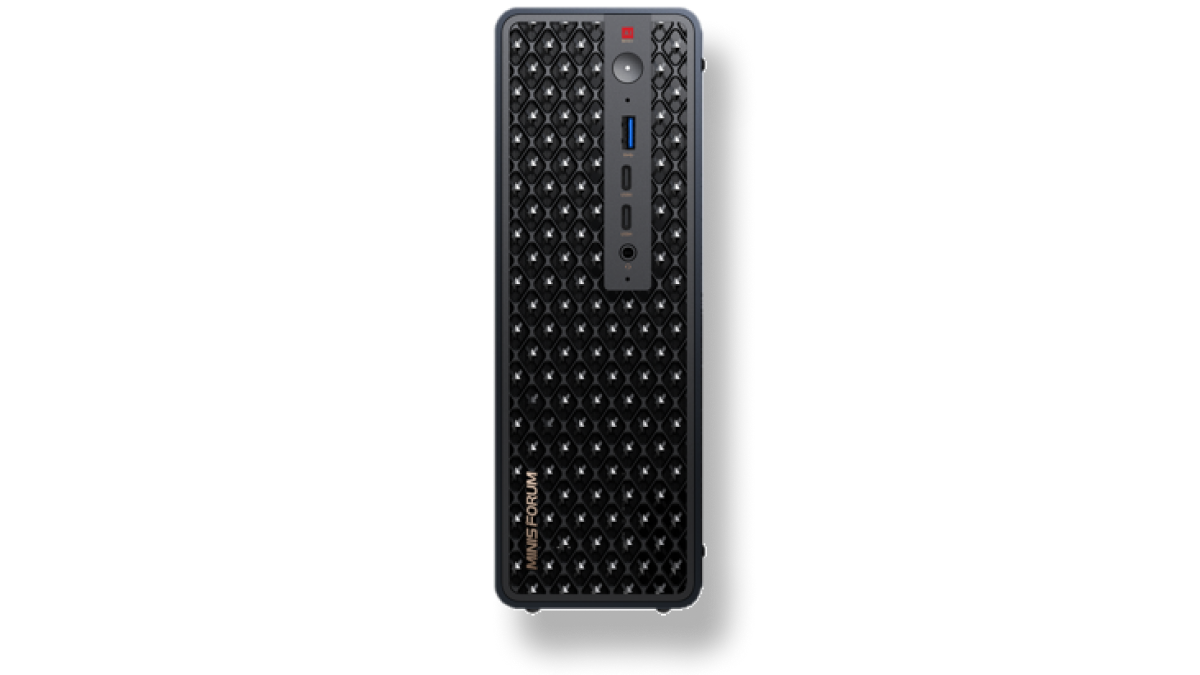
随着锐龙 AI Max+ PRO 495 正式发布,AMD 生态合作伙伴迅速跟进,推出多款面向企业市场的整机产品。以下重点介绍已公开亮相的几款代表性整机。
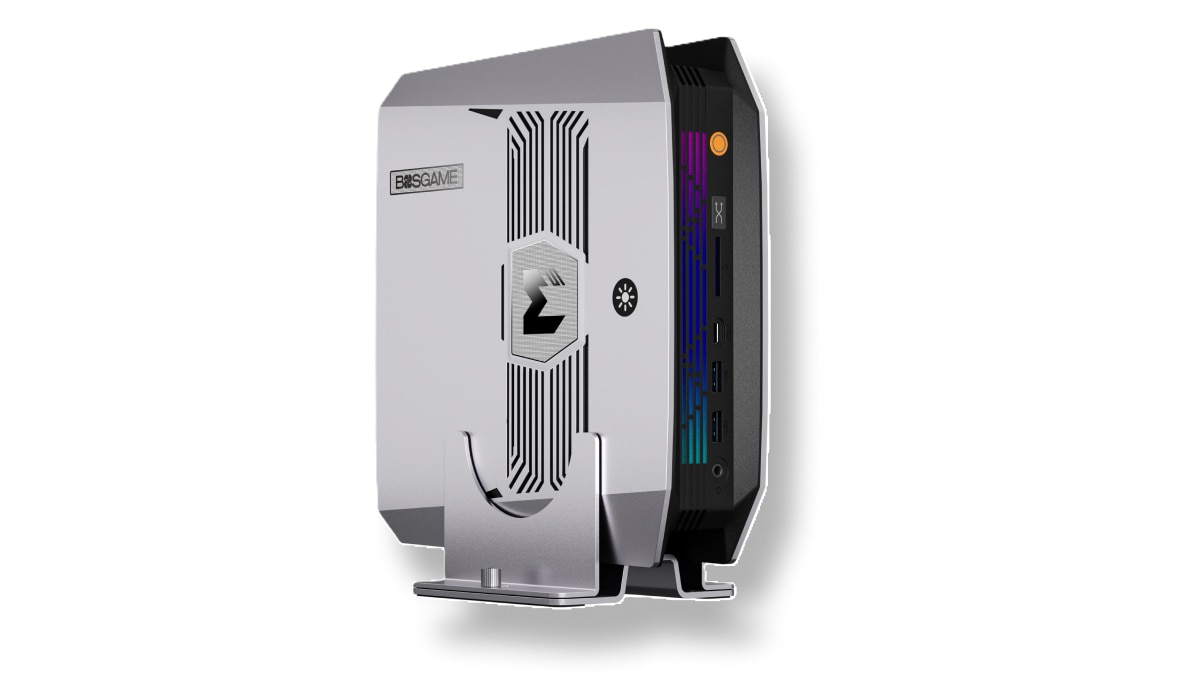
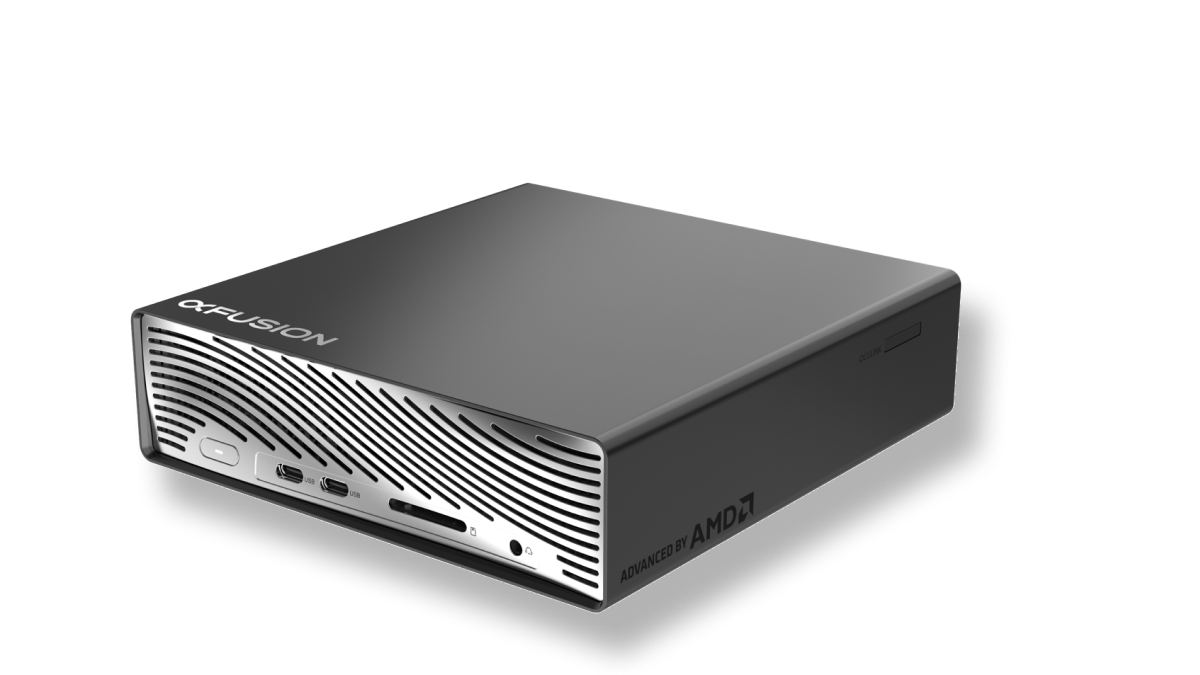
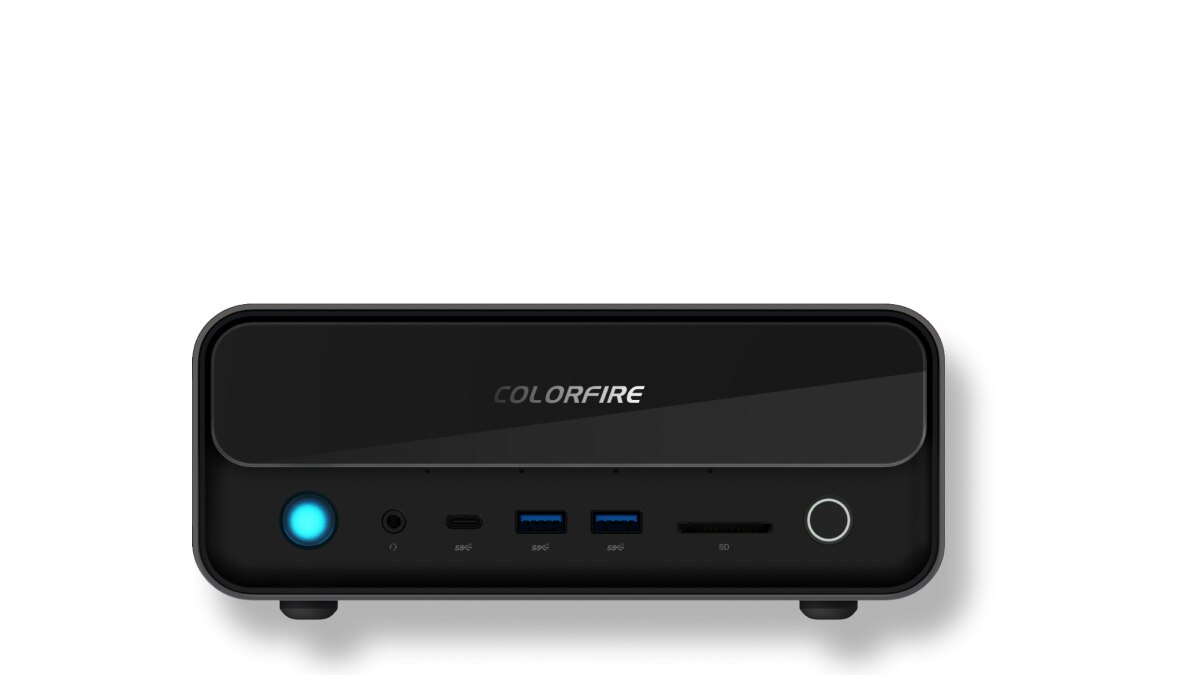
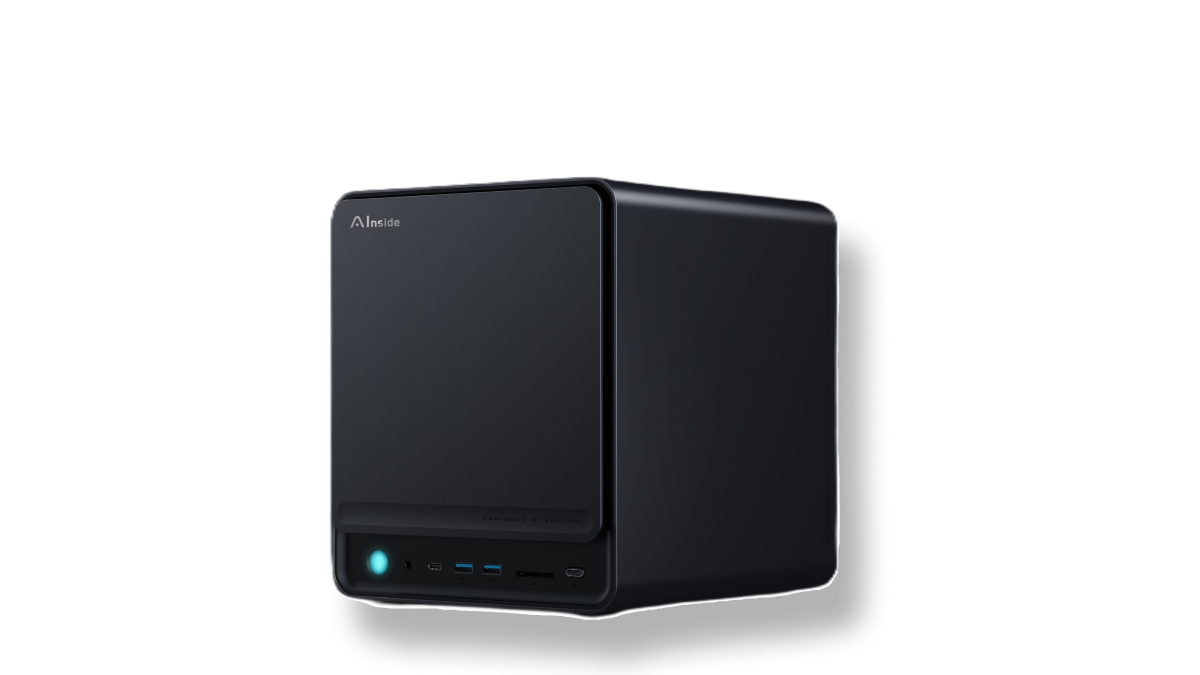
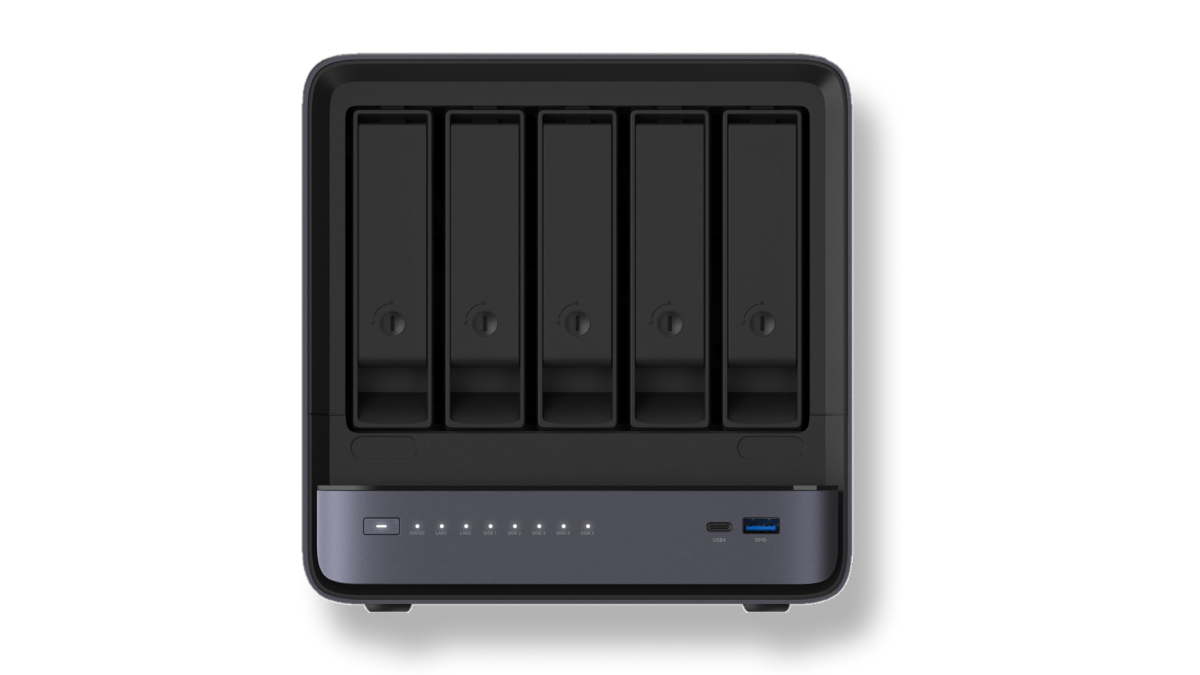
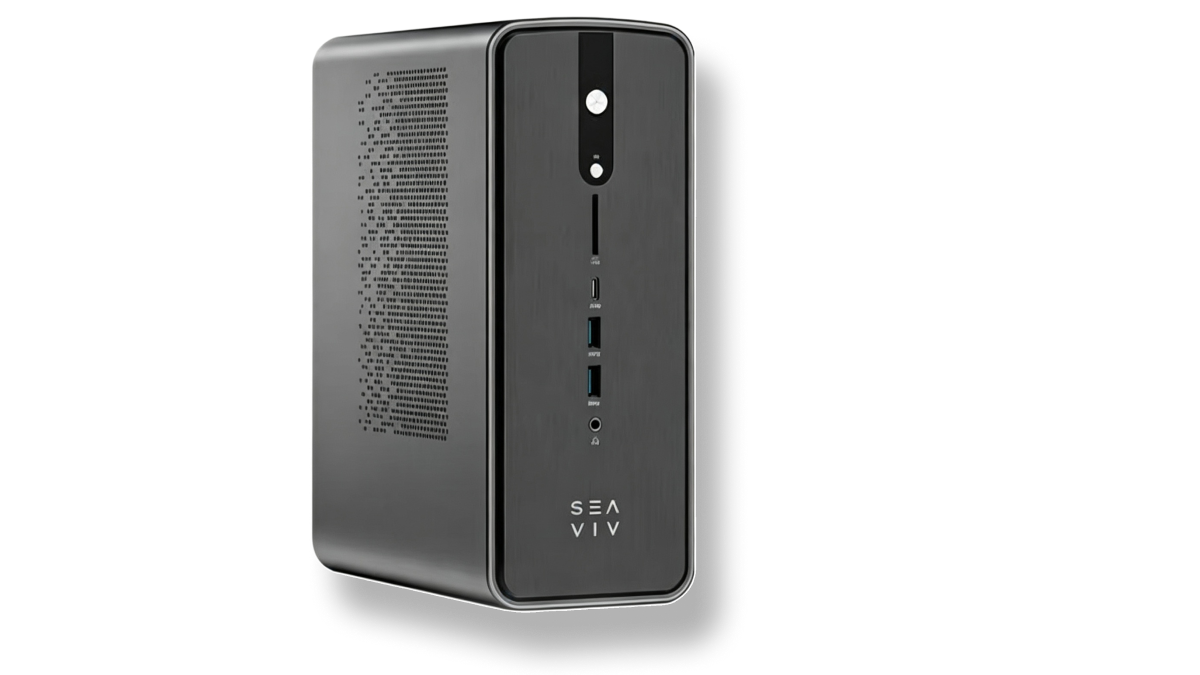
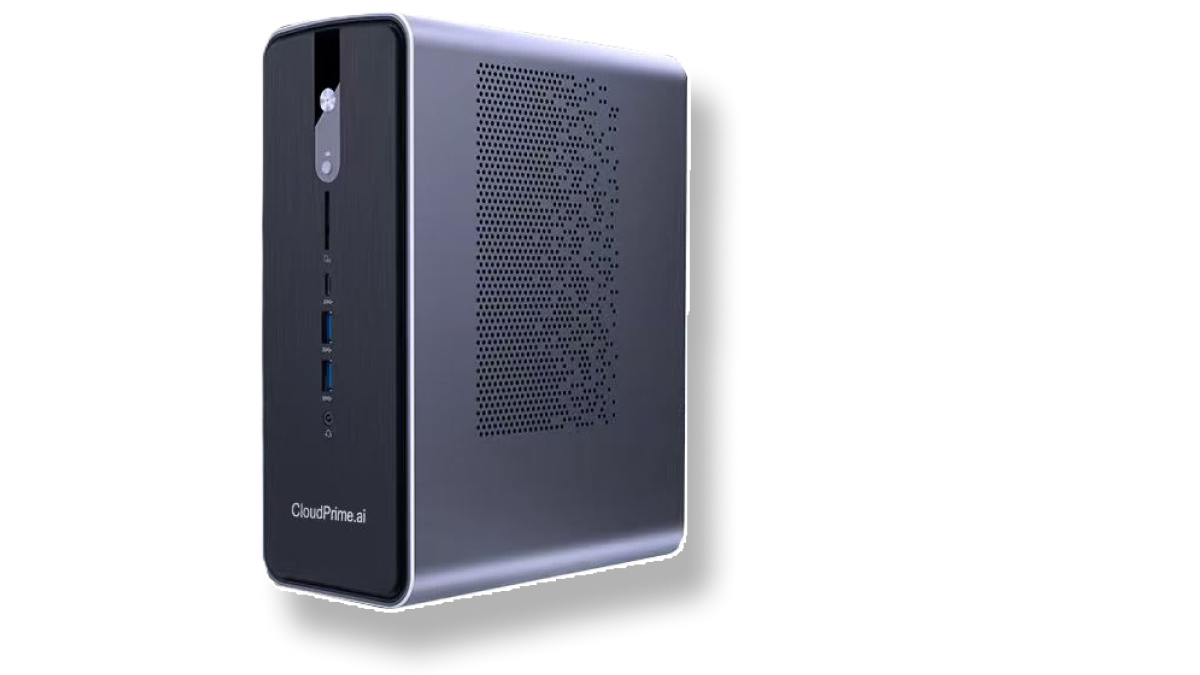
四、企业采购决策指南
对于正在评估智能体电脑/智能体主机解决方案的企业 IT 采购团队,以下维度可作为选型框架:
1. AI 工作负载类型与规模:明确业务场景所需的模型参数量级。若需本地运行 2000 亿参数以上模型,192 GB 统一内存配置是必要条件;较小模型(70 亿–130 亿参数)在 64 GB 配置下亦可流畅运行。
2. 数据合规与隐私要求:评估哪些数据不能离开端点设备。对于涉及个人信息、商业机密或受监管数据的场景,本地推理架构可大幅简化合规审计流程。
3. 部署形态:移动办公场景优先考虑笔记本方案。固定工位或数据中心边缘节点场景可选迷你 PC 以降低整体拥有成本。
4. 可管理性与企业生态:AMD PRO 系列处理器支持主流 MDM 平台统一管理、AMD Memory Guard 内存加密及 AMD-V 硬件辅助虚拟化,确保大规模部署的运维效率与安全合规。
5. 总拥有成本(TCO):将云推理费用节省与硬件采购成本结合计算。对于日均 AI 推理调用量较高的企业,本地化推理的 ROI 回收周期通常在 12–18 个月以内。
AMD 建议企业优先从高频 AI 任务场景启动智能体电脑/智能体主机试点,量化本地推理的成本节省,再基于实测数据制定规模化部署计划。
五、结语
智能体电脑/智能体主机并非遥远的未来愿景——它正在 2026 年的今天加速落地。AMD 锐龙 AI Max+ PRO 495 以 Gorgon Halo 平台的集成设计,将企业级 AI 算力凝聚于一颗芯片,并通过生态合作伙伴的整机产品,为各种企业场景提供了可落地的解决方案路径。
对于企业决策者而言,现在是制定智能体电脑/智能体主机战略的最佳窗口期:评估业务场景、选定试点项目、构建本地 AI 推理能力,在 AI 智能体规模化浪潮中抢占先机。
如需了解 AMD 商用解决方案的详细技术白皮书、概念验证支持或采购报价,请联系 AMD 大中华区商用解决方案团队。

Related Blogs
-
AI 智能体如何提升 AMD Quark 用户体验
Quark AI Agent Skills(Quark AI 智能体技能包)提供了一种引导式、对话式的模型量化方案,让用户可依托基于 Quark 官方文档与源代码构建的安全分步工作流程,轻松地对 PyTorch 和 ONNX 模型进行准备处理以适配 AMD 硬件。
August 24, 2026
-
在AMD 锐龙 AI Max 智能体PC和Radeon 显卡上运行Qwen3.8 27B模型
Qwen3.8 27B 现已发布,并针对 AMD Ryzen™ AI 处理器和 Radeon™ 显卡提供“Day 0”级支持。您可以在受支持的 AMD 硬件上,利用 LM Studio 本地运行这款最新的 Qwen 模型;同时,借助 Lemonade 和 AMD 提供的一流推理支持,您可以轻松构建并交付本地 AI 应用程序。
August 14, 2026
-
-
在 AMD 锐龙 AI Max+ Agentic PC 和 Radeon GPU 上运行 Meta Muse Glimmer 30B
Meta 的 Muse Glimmer 30B 为 AMD 系统带来了强大的本地 AI 能力。 您可以在搭载 AMD Ryzen™ AI Max+ 芯片的智能体 PC(Agentic PC)或 Radeon™ AI PRO R9700 显卡上本地运行该模型。利用 LM Studio 进行探索,使用 Lemonade 进行构建,并将本地 AI 功能集成到您的应用程序中。
August 10, 2026
-
借助 Poro 2 Long 扩展上下文窗口并探索多语言推理
AMD Silo AI 发布两款全新开源 Poro 2 模型:Poro 2 8B Long(上下文窗口实现 16 倍扩展),以及 Poro 2 8B Math Reasoning。
August 06, 2026
-
AMD 携手上海挚科 (ZHIKE),助力青心意创打造新一代具身角色智能机器人
随着具身智能机器人迈向产业化,机器人正从执行固定任务的自动化设备,演进为能够理解环境、感知情绪并与人自然交互的智能伙伴。面向这一快速发展的新赛道,AMD携手生态伙伴挚科(ZHIKE),为上海青心意创打造搭载AMD 锐龙 Threadripper PRO 9975WX处理器的高性能AI液冷工作站,助力其加速具身智能机器人研发,为机器人创新提供强劲算力支撑。
August 03, 2026
-
-