从命令到对话:AI 智能体如何提升 AMD Quark 用户体验
Aug 25, 2026
内容摘要
AMD Quark 是功能强大的跨平台量化工具包,但是如果直接使用,用户需要自行选择正确的入口点、梳理繁杂的配置选项、管理运行环境,并在遇到错误时自行排查解决。本文旨在介绍 Quark AI Agent Skills(Quark AI 智能体技能包)。这是一个对话交互层,借助它,用户只需描述自己的需求(例如“将 Qwen/Qwen3-8B 量化为 FP8”或“将 ResNet-50 量化为 XINT8”),智能体便会自动路由请求、检查模型与环境、提出执行方案、生成可供审查的脚本,并在用户批准后运行脚本。这将带来一种开箱即用、结果可复现的使用体验,既能完整保留 Quark 强大功能,同时还能免去绝大部分的手动操作。我们将通过 PyTorch(大语言模型)和 ONNX(视觉模型)示例进行演示,并阐明在使用该技能包时需要注意的若干事项。
Quark 工作流程简介
AMD Quark 是一种跨平台模型量化工具包,旨在让大型模型变得更小、更快、部署成本更低,同时尽可能保留模型精度。它高度灵活且由脚本驱动,让开发者能够全面掌控量化过程。
通常情况下,Quark 工作流程如下:安装软件包及匹配的目标构建版本;找到适合当前任务的入口点,例如 quantize_quark.py 适合 PyTorch 后端的语言模型,而对于 ONNX 后端,则需自行编写脚本;选择量化设置,如数据类型、校准数据、量化算法及精度提升算法等;运行命令或脚本;最后,评估或验证结果。这是一个成熟的流程,但前提是用户对量化概念和 Quark 规范有一定的了解。如需了解更多详情,请参阅 Quark 文档。
然而,Quark 的高度灵活性也意味着,大部分决策工作需由用户自行承担。在实际使用中,用户通常面临以下几个常见挑战:
- 处理繁琐的设置过程。
在首次运行前,用户必须选择正确的安装包 (wheel),匹配 PyTorch 构建版本,并为大模型设置相关变量。 - 确定合适的入口点。
用户必须决定是使用 PyTorch 还是 ONNX,然后找到适配目标任务的示例或脚本。 - 选择具体配置。
用户须自行选择数据类型、校准方式、量化算法、排除项和目标平台,而这需要具备专业的量化知识。 - 从错误中恢复。
遇到内存溢出 (OOM)、提供程序缺失或模型不受支持等错误时,用户须自行诊断、调整并重试。 - 复现结果。
如果没有检查点或未记录生成的工件,结果的可复现性完全取决于用户是否详细记录了每一个步骤。
从规划、配置、环境设置、错误恢复到记录归档,这些痛点正是 AI Agent Skills 旨在解决的问题。
Quark AI Agent Skills 如何赋能 Quark 用户
Quark AI Agent Skills 是一套可复用、独立完整的能力集合,可将 Quark 量化工作流程打包成特定技能以供 AI 编码助手调用。每一项技能都通过名为 SKILL.md 的 Markdown 文件进行描述,并可通过 AI 助手(如 Claude Code 命令行界面)来调用。其核心理念是:用户无需知晓具体该调用哪一项 Quark 技能。相反,用户只需用自然语言表达量化目标,系统便会自动选择并按顺序执行相应的 Quark 技能。
Quark AI Agent Skills 的主要优势是提供开箱即用的体验:用户只需发出量化请求。用户不必研读示例、记忆命令行参数或编写脚本,而只需用通俗语言描述期望达成的结果,智能助手便会自动处理一系列底层操作,包括将请求路由到正确的后端、检查模型和环境、给出配置建议、执行量化任务并验证结果。这意味着,Quark 的强大功能完整保留,但手动操作 Quark 的工作量大幅降低。
以 Quark 安装过程为例。以下示例充分展示了 Quark AI Agent Skills 如何为用户提供助力。
传统方式:
		# Choose the wheel that matches your accelerator and platform yourself:
pip install amd-quark                           # universal (CPU fallback)
pip install amd-quark --extra-index-url https://pypi.amd.com/quark/cu128/simple    # CUDA 12.8
pip install amd-quark --extra-index-url https://pypi.amd.com/quark/rocm72/simple   # ROCm 7.2
# ...then verify the install and confirm it matches your Python and PyTorch build.
AI 智能体方式:
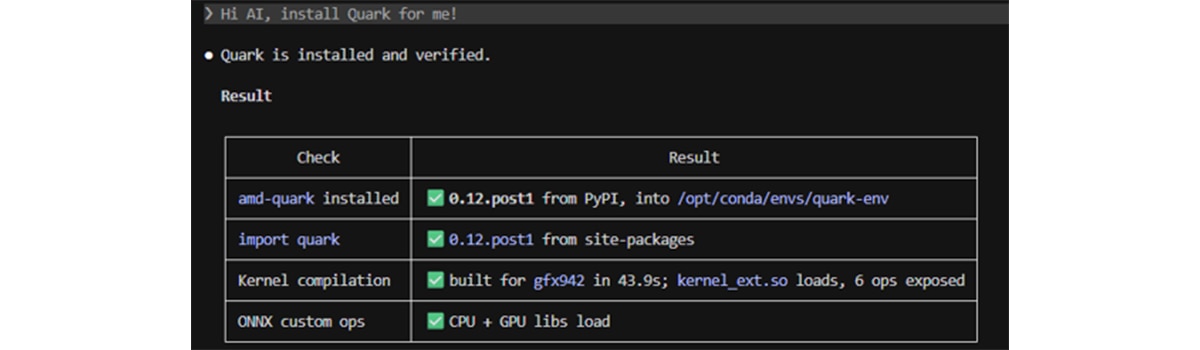
智能助手会自动检查操作系统、Python 版本、加速器及驱动程序栈,选择适配的命令,请求用户确认,执行安装并验证结果。用户无需了解哪个版本适用于自己的机器,即可完成正确的安装。
这为 Quark 用户带来了统一、可审查的工作流程,确保每次运行都会生成一套标准的工件,使得结果更易于复现且可交付使用。
Quark 技能使用示例
大语言模型量化示例
假设用户希望将 Qwen3-8B 量化为 FP8。用户无需手动寻找合适的脚本并逐一选择选项,只需描述期望达成的结果即可:
“将 Qwen/Qwen3-8B 量化为 FP8,并将结果保存到 ./output/qwen3-8b-fp8。”
quark-torch-ptq 技能会将上述请求转化为一个包含多个审查节点的引导式工作流程:
1.分析模型。助手会检查模型配置,并输出一份摘要,内容包括 Qwen3 架构、待量化的目标层、默认排除的 lm_head 层、兼容性信息以及可能影响运行的潜在风险。用户可以先核实该分析结果,然后再继续操作。
2.提出量化方案。基于请求中指定的 FP8 格式,助手会列出关键选项并解释默认设置:
设置 |
建议的值 |
原因 |
量化方案 |
FP8 |
用户请求 |
KV 缓存 |
FP8 |
匹配 FP8 推理路径 |
排除的层 |
lm_head |
保持输出头为全精度 |
校准 |
128 个样本,序列长度 512 |
实用的校准起点 |
算法 |
RTN 基线 |
简单快速的起点 |
用户可以批准该方案,或请求进行更改(例如更改校准数据规模或使用精度提升算法)。
3.审查并批准命令。方案确认后,助手会在执行任何操作前,展示确切的命令、输出目录和导出格式:
		python3 examples/torch/language_modeling/llm_ptq/quantize_quark.py \
  --model_dir Qwen/Qwen3-8B \
  --output_dir ./output/qwen3-8b-fp8 \
  --quant_scheme fp8 \
  --kv_cache_dtype fp8 \
  --num_calib_data 128 \
  --seq_len 512 \
  --model_export hf_format \
  --data_type auto \
  --device cuda
4.运行并报告结果。在用户批准命令后,助手会执行量化并验证输出结果。生成的 Hugging Face safetensors 模型、配置文件、分词器文件以及 Quark 配置文件将写入 ./output/qwen3-8b-fp8。随后,助手还可以帮助验证结果、评估精度或将其转换为其他受支持的格式。
该工作流程会保留 model_analysis.json、quant_plan.json 和 run_manifest.yaml 文件,便于后续审查相关决策和具体命令、进行复现或交付他人使用。如果运行过程中遇到内存溢出、模型加载失败或版本不匹配等问题,助手会解释问题所在,并利用 quark-torch-debug 指南推荐改动量最小的可行调整方案。
视觉模型量化示例
一项常见任务是对视觉模型(如 ResNet-50 图像分类器)进行准备处理,使其能够在 CPU、GPU 或 AMD NPU 上高效部署。假设工程师希望使用一批校准图像,将其模型量化为 XINT8。他们可以用自然语言描述目标:
“使用 ./calib 目录中的图像,将我的 resnet50.onnx 模型量化为 XINT8,并将结果写入 ./output/resnet50_xint8.onnx。”
不使用 Quark 技能
如果手动完成此任务,用户需要自行整合并正确处理多个环节:
1.准备校准数据。用户需编写自定义的 CalibrationDataReader (通常为 ImageDataReader),以便从磁盘加载图像、应用正确的预处理操作(如调整大小、归一化,以及 NCHW 与 NHWC 等数据排布格式),并生成与模型输入名称和形状相匹配的输入数据。
2.选择配置。用户需选择数据类型和预设(例如 XINT8 规范)、校准方法以及精度提升算法(如 CLE 或 AdaQuant),并决定排除哪些节点。如果部署目标是 NPU,还需要确保具备匹配的自定义算子库。
3.编写量化脚本。用户需在 Python 脚本中将数据读取器、QConfig 和 ModelQuantizer.quantize_model(...) 串联起来,并确保这些设置与预期的部署目标相兼容。
4.运行并排除故障。用户需启动脚本,并在遇到执行提供程序缺失、自定义算子加载失败或内存溢出等问题时,通过阅读报错信息和调整代码来自行解决。
5.验证结果。最后,用户需自行检查输出结果,确认模型已按预期完成量化,然后才能交付使用。
以上每一步虽然都能做到,但要完成整个流程,用户必须熟悉 ONNX 计算图、预处理流水线以及 Quark 配置体系,才能得到第一次量化结果。
使用 Quark 技能
通过使用 Quark 技能,相同的请求只需一句话即可完成;quark-onnx-ptq 工作流程将通过四步流程完成任务,并在每一处检查点暂停等待用户确认。重要的是,执行过程绝不会直接调用量化器,而是运行由助手生成并经过审查的脚本。
1.信息采集:读取 ONNX 计算图,并在 model_analysis.json 中记录 opset 版本、输入输出形状、算子直方图以及部署目标兼容性信息。
2.方案规划:选择 XINT8 预设、校准方法和相关算法,对选定的部署目标进行把关,并将决策记录在 quant_plan.json 中。
3.生成清单:工作流程生成校准和量化脚本(包括图像数据读取器和配置),并将其记录在 run_manifest.yaml 中。
4.执行:在用户确认后,运行脚本并生成量化模型,该模型可直接部署。
如果因为执行提供程序缺失、自定义算子加载失败或机器内存耗尽等问题而导致执行失败,该工作流程会跳转至专门的安装或调试步骤,通过该步骤诊断问题并提出调整最小的下一步操作以解除用户阻塞。之后,还可以执行验证步骤以确认 QDQ 节点是否已正确插入,以及未量化的初始值设定项是否与原始文件字节完全一致。
示例总结
上述对比正是本文的核心:原本需要编写多段脚本才能完成的复杂工作,现在只需用户简单描述目标即可;助手会自动处理数据准备、参数配置、部署目标兼容性、任务执行以及结果验证等各个环节,同时过程中仍会暂停,等待用户审阅确认。
挑战 |
不使用 AI Agent Skills |
使用 AI Agent Skills |
设置与环境 |
用户自行挑选正确的软件包版本、匹配的 PyTorch 构建版本及大模型环境设置,并自行验证安装。 |
助手自动检查操作系统、Python、加速器和驱动程序,给出适配的安装步骤,在用户确认后执行安装并检查 Quark 是否可用。 |
确定正确入口点 |
用户需在 PyTorch 和 ONNX 之间做选择,并在大量示例中费力寻找适配任务的脚本或模式。 |
用户只需用通俗语言描述期望的结果;助手自动将用户请求路由到正确的后端和工作流程。 |
配置 |
用户需摸索数据类型、校准方法、算法、排除项和部署目标,且必须清楚哪些配置可以组合使用。 |
助手自动分析模型和环境,给出包含默认值的方案并阐述理由,并等待用户批准或修改。 |
错误恢复 |
用户需查阅堆栈跟踪、搜索文档,并自行反复重试(解决内存溢出、提供程序缺失、算子不受支持等问题)。 |
助手解释失败原因,提出改动最少的可行修复方案,并在重试前引导用户完成安装或调试步骤。 |
可复现性与移交 |
除非用户手动记录,否则精确完整的命令和决策仅会留存于笔记或 Shell 历史记录中。 |
执行前的多个审查检查点,再加上保存下来的分析、方案和运行记录,使得任务更易于复现和分享。 |
注意事项
这套技能旨在提供更便捷、更安全的 Quark 使用体验;要想充分发挥它们的价值,关键在于用户全程保持积极参与。以下几点值得特别注意:
- 清晰说明部署目标和优先事项。助手会基于您提供的信息规划方案。因此,如果在请求中明确说明模型将在哪里运行(CPU、GPU 还是 AMD NPU),以及您最看重什么(例如:优先保证精度,而非一味追求模型体积最小化),而不是仅说明模型名称和数据类型,那么助手生成的第一版方案将明显更优。如果未提供这些信息,助手将采用通用的默认设置,这些设置虽然合理,但可能并不契合您的部署需求。
- 在执行前审查生成的所有脚本和命令。这些技能的核心价值很大程度上来自于“确认检查点”,即在运行任何操作之前,助手会向您展示详细方案、完整脚本和确切的命令。请务必阅读脚本本身,而不仅仅是阅读摘要,包括检查脚本的写入路径、编码的设置以及脚本所依赖的预处理逻辑。例如,生成的 ONNX 校准数据读取器会内置模板化的图像缩放、归一化和张量布局;如果您的模型所期望的处理方式有所不同,这些默认行为可能会在无明显提示的情况下影响精度。多花一点时间仔细核对,而不是匆匆点击确认,是确保运行结果符合预期的关键。
- 留意大规模运行的资源消耗。仅仅一句话就可能触发模型下载和完整的量化任务,您需要意识到这些操作可能会占用大量的磁盘空间、内存和时间。在确认执行前审查方案,有助于您有意识地启动这类高负载任务。
- 不同运行、不同模型的结果可能存在差异。请独立评估每一次生成的方案,不要想当然地认为它会复现上一次运行的结果。如果需要复现某次特定运行的结果,请利用记录的 model_analysis.json、quant_plan.json 和 run_manifest.yaml 文件。由于助手生成的分析和推荐的配置来源于语言模型,相同的请求在第二次运行时可能会产生略有不同的方案,不同助手对模型架构或部署目标的推理判断也可能存在差异。
以上这些问题是在功能强大的工具包之上叠加对话交互层所带来的固有取舍,而技能自带的检查点、生成脚本透明化机制以及验证能力,正是为了帮助您应对这些问题。
结语
Quark AI Agent Skills 带来了一种引导式、对话式的模型量化体验。通过让用户表达想要实现什么目标而不是如何实现目标,Quark AI Agent Skills 将功能强大但高度复杂的工具包转变为一种简单易用的分步式工作流程。每一项技能均保持稳定一致、默认安全,并且可追溯至 Quark 官方文档和源代码。
无论您是使用 PyTorch 后端对大语言模型进行量化,还是通过 ONNX 后端准备视觉模型以适配 AMD NPU,这套技能都能无缝对接您的工作流程:您只需描述要实现的目标、审查给出的方案并确认执行,繁琐工作均可交由助手处理。欢迎 Quark 用户在 Claude Code 中体验这套技能,并分享反馈意见。我们将持续扩充技能目录、扩大覆盖范围,并不断增强系统功能。
如需详细了解面向 PyTorch 和 ONNX 后端的 Quark AI Agent Skills,请参阅相应的 AI Agent Skills 文档:面向 PyTorch 的 Quark AI Agent Skills 和面向 ONNX 的 Quark AI Agent Skills
致谢
感谢 Ke Wang、Lin Zhao、Jiangyong Ren、Peng Lu 等同事以及 AMD Quark 团队成员提供富有洞见的反馈与技术支持。
附录
Quark 目前提供了一系列技能,覆盖完整的量化流程。技能分为三类:适用于两个后端的通用技能、PyTorch 后端流程专属技能、ONNX 后端流程专属技能。
通用技能(两个后端均适用)
- quark-env-preflight:在执行任何安装或量化步骤之前,收集环境信息,包括操作系统、Python 版本、GPU 以及 CUDA/ROCm 状态。
- quark-install:安装并验证 AMD Quark 软件包及其核心依赖项。
PyTorch 后端专属技能
- quark-torch-install:针对用户的加速器,安装或验证正确的 PyTorch 构建版本。
- quark-torch-model-intake:检查 Hugging Face 或 safetensors 模型,并报告模型架构、量化目标及潜在风险。
- quark-torch-ptq:端到端运行完整的 PyTorch 大语言模型 PTQ 流水线。
- quark-torch-export:将量化后的模型导出为 Hugging Face safetensors、GGUF 或 ONNX 格式。
- quark-torch-llm-eval:使用通用基准测试评估模型精度。
- quark-torch-file2file-quantization:针对超大检查点,执行低内存占用的文件到文件量化。
- quark-torch-result-validator:验证导出的 PyTorch 量化结果。
- quark-torch-debug:诊断 PyTorch 流程中的故障并提供修复建议。
ONNX 后端专属技能
- quark-onnx-install:安装或验证正确的 ONNX Runtime 构建版本及适配的 ONNX 软件包。
- quark-onnx-model-intake:检查 ONNX 计算图(包括 opset 版本、输入/输出形状、算子直方图以及部署目标兼容性)。
- quark-onnx-ptq:针对视觉模型和 CNN 模型运行完整的“ONNX 到 ONNX”PTQ 流水线。
- quark-onnx-autosearch-pro:自动搜索适配的量化配置。
- quark-onnx-result-validator:验证量化后的 ONNX 输出结果。
- quark-onnx-debug:诊断 ONNX 流程中的故障并提供修复建议。

Related Blogs
-
在AMD 锐龙 AI Max 智能体PC和Radeon 显卡上运行Qwen3.8 27B模型
Qwen3.8 27B 现已发布,并针对 AMD Ryzen™ AI 处理器和 Radeon™ 显卡提供“Day 0”级支持。您可以在受支持的 AMD 硬件上,利用 LM Studio 本地运行这款最新的 Qwen 模型;同时,借助 Lemonade 和 AMD 提供的一流推理支持,您可以轻松构建并交付本地 AI 应用程序。
August 14, 2026
-
-
在 AMD 锐龙 AI Max+ Agentic PC 和 Radeon GPU 上运行 Meta Muse Glimmer 30B
Meta 的 Muse Glimmer 30B 为 AMD 系统带来了强大的本地 AI 能力。 您可以在搭载 AMD Ryzen™ AI Max+ 芯片的智能体 PC(Agentic PC)或 Radeon™ AI PRO R9700 显卡上本地运行该模型。利用 LM Studio 进行探索,使用 Lemonade 进行构建,并将本地 AI 功能集成到您的应用程序中。
August 10, 2026
-
借助 Poro 2 Long 扩展上下文窗口并探索多语言推理
AMD Silo AI 发布两款全新开源 Poro 2 模型:Poro 2 8B Long(上下文窗口实现 16 倍扩展),以及 Poro 2 8B Math Reasoning。
August 06, 2026
-
AMD 携手上海挚科 (ZHIKE),助力青心意创打造新一代具身角色智能机器人
随着具身智能机器人迈向产业化,机器人正从执行固定任务的自动化设备,演进为能够理解环境、感知情绪并与人自然交互的智能伙伴。面向这一快速发展的新赛道,AMD携手生态伙伴挚科(ZHIKE),为上海青心意创打造搭载AMD 锐龙 Threadripper PRO 9975WX处理器的高性能AI液冷工作站,助力其加速具身智能机器人研发,为机器人创新提供强劲算力支撑。
August 03, 2026
-
-
-