基于 AMD EPYC(霄龙)加速 llama.cpp:ZenDNN 将提示词处理性能提升高达 4.5 倍
Aug 18, 2026
关于 AI 推理的叙事几乎一直围绕 GPU 展开。这无可厚非,因为对于繁重的训练和高吞吐量推理任务,GPU 依然是黄金标准。但在机架内部,正发生一场不那么引人注目的变革。几乎每台服务器中都搭载的 CPU,不再仅仅为加速器提供数据输入、处理粘合逻辑;CPU 本身正成为高度可靠且具备成本优势的推理引擎。
Llama.cpp 正是这场变革的核心。它是全球应用非常广泛的开源大语言模型推理引擎之一,在 GitHub 拥有超 1,700 位贡献者和超过 113,000 颗星标。llama.cpp 采用纯 C/C++ 编写,无外部依赖项,可在各类设备上运行,从 Raspberry Pi 到双路数据中心服务器均可适配。数百万开发者在本地运行模型时,都会优先选择 llama.cpp。
但存在一个问题:在 AMD EPYC(霄龙)处理器上,llama.cpp 以往依赖于通用 CPU 内核,未能充分发挥硬件性能。而底层芯片的能力远不止于此。
这正是 llama.cpp 的 ZenDNN 后端所要解决的问题。ZenDNN 是 AMD 专为 EPYC(霄龙)处理器中的“Zen”架构核心而打造的开源深度学习库 (GitHub)。现在,它可作为 GGML 后端直接集成到 llama.cpp 中。该后端在 ZenDNN 5.2 开发周期内完成工程开发(详见 ZenDNN 5.2 发布公告),并已合并至上游代码库。
本文将介绍该后端如何接入 GGML,更重要的是,说明在 AMD EPYC(霄龙)上运行的开发者有望实现怎样的性能提升。我们在 BF16 和 Q8_0 精度下对 12 个模型进行了基准测试,结果表明提示词处理性能得到显著提升。
核心结论(AMD EPYC [霄龙] 9755,128 个核心,单路):
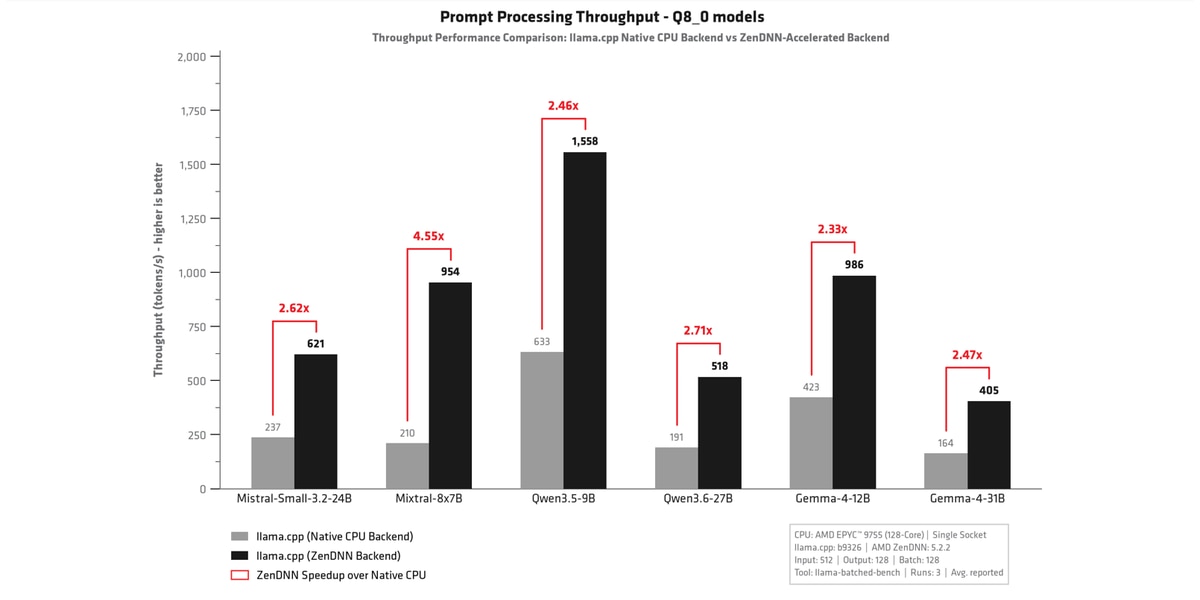
- 在 Mixtral-8x7B (Q8_0) 上,得益于 ZenDNN 的 MoE 专家矩阵乘法加速,提示词处理性能提升高达 4.5 倍2
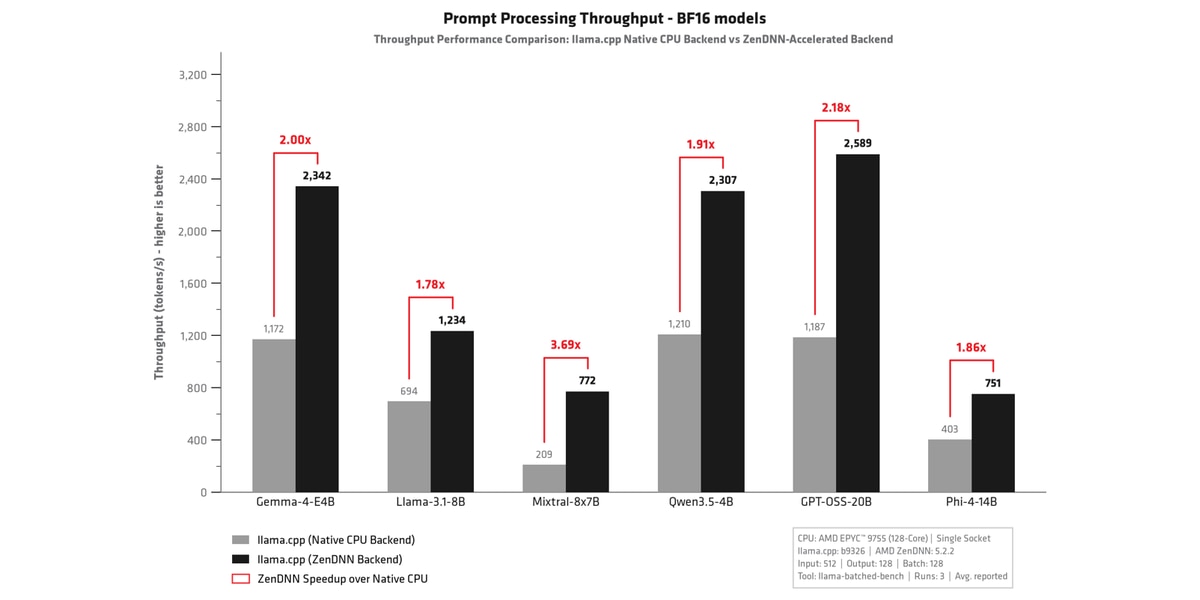
- 在 Mixtral-8x7B (BF16) 上,提示词处理性能提升高达 3.7 倍1
- 在密集模型上,提示词处理性能提升约 2 倍(BF16 精度下提升 1.8–2.2 倍,Q8_0 精度下提升 2.3–2.7 倍)1
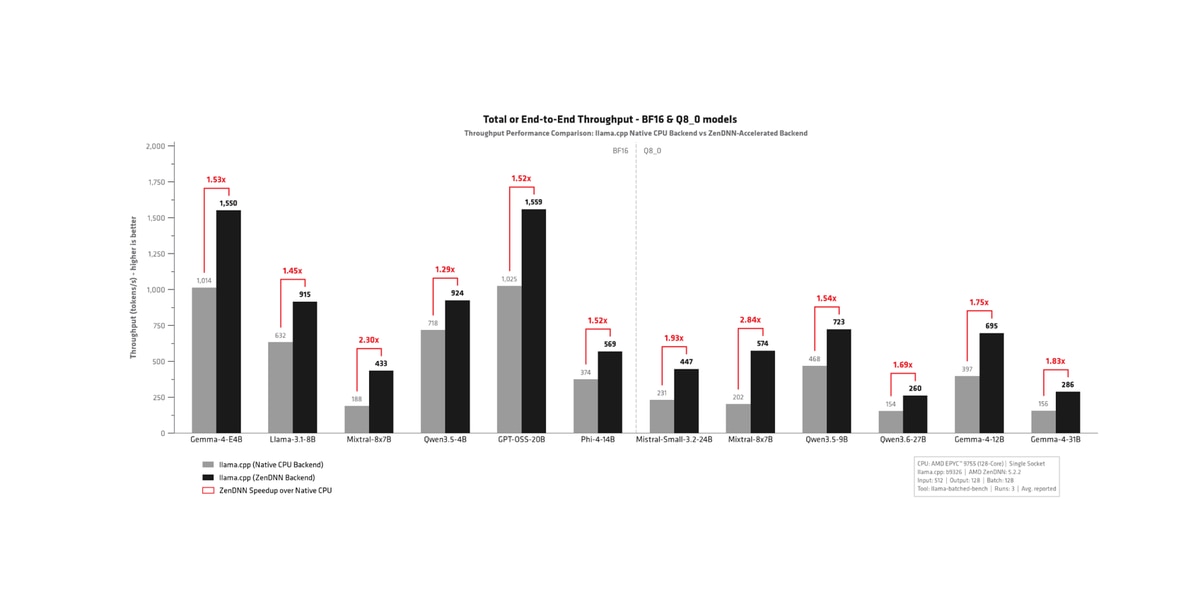
- 在预填充与解码混合工作负载下,端到端吞吐量提升高达 2.84 倍
- Token 生成速度与原生 CPU 后端保持一致;小批量解码目前仍回退至 CPU 路径(在 ZenDNN 针对小批量处理场景进行性能优化期间,这是主动做出的临时选择)
ZenDNN 如何接入 llama.cpp
llama.cpp 的核心机制是将所有张量数学运算委托给底层张量库 GGML。GGML 采用可插拔的后端系统:每个后端在启动时自行注册,声明其支持的运算;随后,调度器会在运行时将计算图中的每个运算路由到最合适的后端。后端未声明的任何运算都会自动回退到 CPU 后端,无需配置,也无需手动对接。
这使得添加专用硬件支持变得非常干净利落。ZenDNN 后端与 CUDA® 和 HIP 等成熟后端遵循相同的模式:优先于通用 CPU 后端接入 GGML 后端注册表,拦截 Transformer 推理中占主要算力开销的矩阵乘法运算,并将这类运算交由经过优化的 AMD ZenDNN 库执行。其他所有运算则继续像以前一样在 CPU 后端上运行。这种集成采用精准定向改造的设计思路,可确保改动量小,但带来显著性能收益。
图像缩放
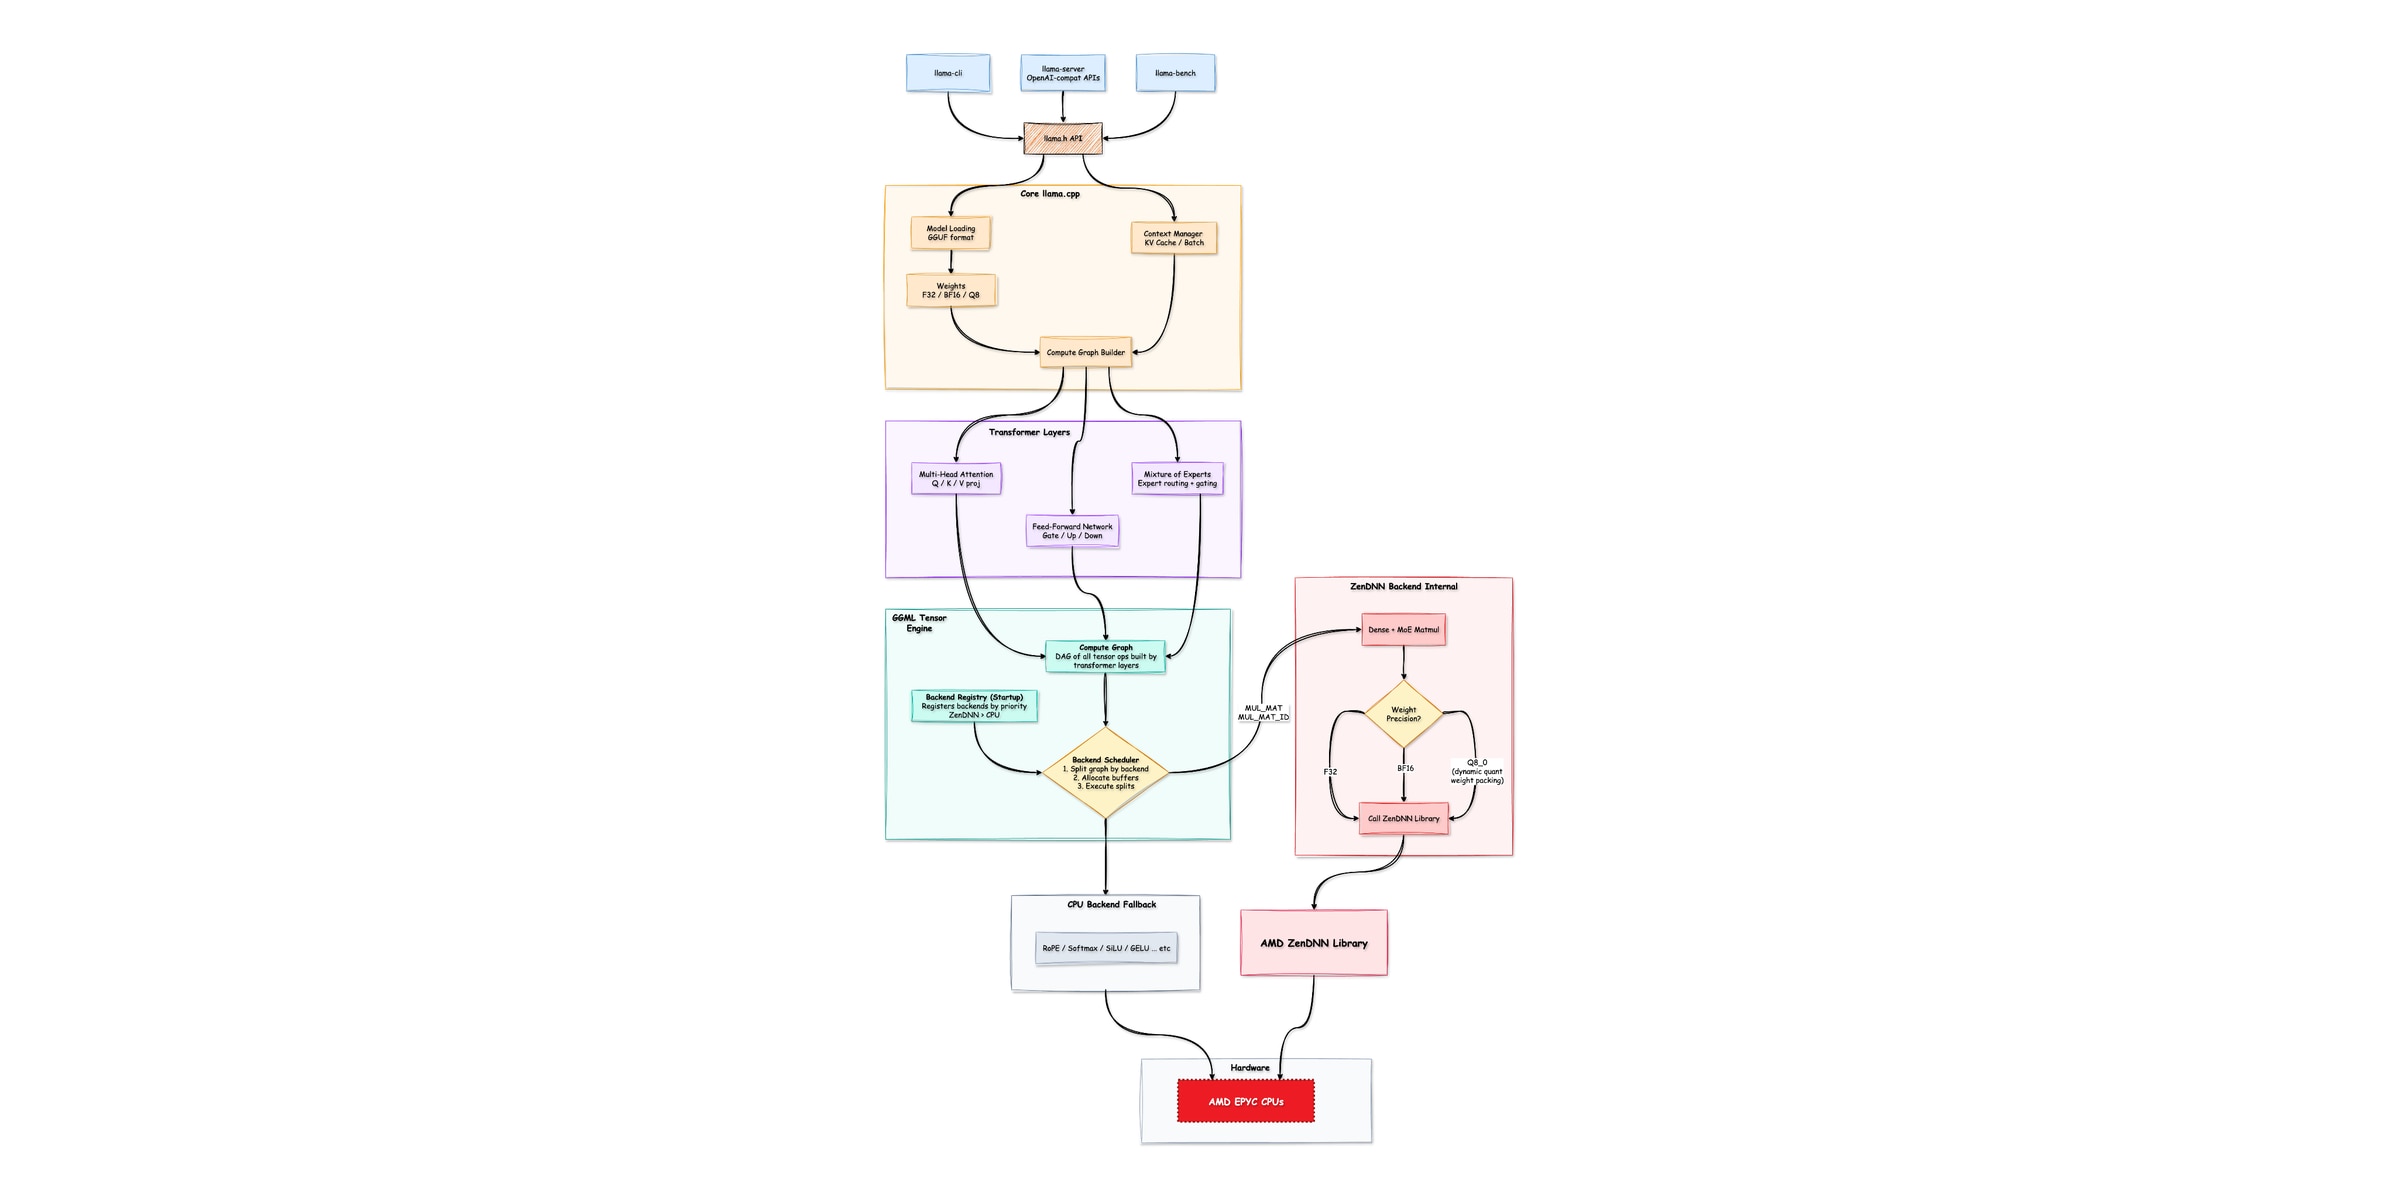
请求通过 llama.h API 进入。核心 llama.cpp 加载 GGUF 模型,管理 KV 缓存和批处理,并构建计算图 - 这是一个有向无环图 (DAG),包含 Transformer 层所需的每个张量运算:多头注意力机制、前馈网络,以及针对 MoE 模型的专家路由和门控。该计算图到达 GGML 后端调度器,调度器按后端进行拆分、分配缓冲区并执行这些拆分任务。由于在注册表中 ZenDNN 的优先级高于 CPU,两个最重要的运算会被路由到 ZenDNN:
- GGML_OP_MUL_MAT:构成 Transformer 计算主体的密集矩阵乘法
- GGML_OP_MUL_MAT_ID:MoE 模型(如 Mixtral)使用的专家门控矩阵乘法
每项矩阵乘法都会检查权重精度 - F32、BF16 或 Q8_0(通过动态权重打包处理),然后调用 ZenDNN 库。其他所有运算,包括 RoPE、RMS 归一化、Softmax、SiLU/GELU 等,都会透明地回退到 CPU 后端。
ZenDNN 的两大机制在此处起到关键作用。低开销 API (LowOHA):尽可能降低每次调用的分发成本。这非常重要,因为 Transformer 推理会产生海量、重复的小批次矩阵乘法。权重缓存:将模型的常量权重仅打包一次 (is_weights_const = true),并在后续每次调用中重用打包后的布局,而不是每次都重新打包。在底层,矩阵乘法路径可通过 ZENDNNL_MATMUL_ALGO 进行选择,包括 AOCL-DLP(AMD 优化的 BLAS,推荐的默认选项)、oneDNN 或 LIBXSMM。对于大多数 llama.cpp 工作负载,AOCL-DLP 能够提供出色性能。ZenDNN 代码库中记录了 ZenDNN 的完整分层架构。
该后端声明支持以下运算:
运算 |
F32 |
BF16 |
Q8_0 |
注释 |
GGML_OP_MUL_MAT |
✓ |
✓ |
✓ |
全方位 ZenDNN 加速 |
GGML_OP_MUL_MAT_ID |
✓ |
✓ |
✓ |
MoE;当专家数量大于 32 时回退至 CPU 处理 |
所有其他运算 |
— |
— |
— |
透明的 CPU 后端回退机制 |
启用该后端只需添加一个 CMake 编译标志:-DGGML_ZENDNN=ON。在首次编译时,系统会自动下载并构建 ZenDNN。如需了解完整的设置步骤(包括编译/运行命令),请参阅 llama.cpp 的 ZenDNN 后端文档。
性能测试结果
所有基准测试均在 AMD EPYC(霄龙)9755 128 核系统上进行,绑定至单路(128 个核心,一个 NUMA 节点),将 ZenDNN 5.2.2 与原生 llama.cpp CPU 后端(构建版本 b9326)进行对比。我们使用 llama-batched-bench 工具,提示词输入为 512 个 token,生成 128 个 token,128 个并行序列,即有效的输入/输出/批次大小为 512/128/128。每项测试运行三次,取平均值。所有指标遵循“数值越高越好”的原则。完整配置详见附注(附注 1,ZD-066)。
由于以下两项指标的表现差异极大,我们对其进行了独立测量
- 提示词处理(预填充):模型处理输入 token 的速度。受算力限制。
- 总计/端到端吞吐量:实际综合吞吐量。
提示词处理 - BF16 模型
提示词处理 - Q8_0 模型
总计/端到端吞吐量
精度:结果一致,速度提升
只有在输出结果准确可靠的前提下,加快推理速度才有意义。ZenDNN 后端可以加速矩阵乘法,同时不会改变模型精度或量化格式,Q8_0 依然是 Q8_0,BF16 依然是 BF16。因此,运行相同 GGUF 模型时,ZenDNN 后端的输出结果在数值上与原生 CPU 后端一致。
我们可以通过两个后端运行同一模型,并基于 WikiText-2 数据集测量困惑度 (perplexity) 来直接验证这一点:
模型 |
原生 CPU (PPL) |
ZenDNN (PPL) |
差值 |
Llama-3.1-8B (BF16) |
7.3214 |
7.3214 |
0.0000 |
Mixtral-8x7B(BF16、MoE) |
4.4087 |
4.4083 |
0.0004 |
Mixtral-8x7B(Q8_0、MoE) |
4.4134 |
4.4136 |
0.0002 |
无论是密集模型还是 MoE 模型,在 BF16 和 Q8_0 精度下,两个后端之间的最大困惑度差值仅为 0.0004。这完全在 ±0.02–0.05 的测量误差范围内,属于数值噪声,而非行为上的改变。此外,Q8_0 结果与 BF16 结果也很接近:Mixtral-8x7B 的分数分别为 4.4136 和 4.4083,差距仅约 0.1%。
支持的硬件
CPU 系列 |
代号 |
世代 |
架构 |
AMD EPYC(霄龙)9005 系列 |
“_Turin_” |
第五代 |
“_Zen 5_” |
AMD EPYC(霄龙)9004 系列 |
“_Genoa_” |
第四代 |
“_Zen 4_” |
AMD EPYC(霄龙)7003 系列 |
“_Milan_” |
第三代 |
“_Zen 3_” |
*对于 Zen 3 (Milan) 架构,ZenDNN 仅可加速 FP32 精度。ZenDNN 后端仅面向 CPU。如需实现 AMD GPU 加速,请使用基于 ROCm 的 HIP 后端。
未来规划
ZenDNN 后端仍在积极开发中。接下来的规划包括:
- 解码阶段与小批量处理加速:补齐小批量处理性能短板,使 ZenDNN 能够接管 token 生成任务,消除当前回退至 CPU 后端的机制
- 更广泛的量化支持:超越 Q8_0,支持 K-quants、IQ-quants 等格式
- 进一步优化 MoE 以降低 CPU 回退阈值,支持超过 32 个专家的模型
- 融合算子与更广泛的算子覆盖范围:超越 MUL_MAT 和 MUL_MAT_ID;如需全面了解 GGML 算子及后端支持状态,请参阅 docs/ops.md
欢迎通过 llama.cpp GitHub 代码库贡献代码和提交反馈。
致谢
本成果由 AMD ZenDNN 团队与 llama.cpp 开源社区协作完成。特别感谢促成上游代码合并的 llama.cpp 维护者和审查人员。
附注
附注
- ZD-066:结果基于截至 2026 年 6 月 15 日的 AMD 内部测试。AMD 系统:双路 AMD EPYC(霄龙)9755 128 核处理器,仅使用单路,禁用 SMT(1 线程/核心),NPS1 模式,最大加速频率 4.06 GHz;共计 256 个线程,分布于 2 个 NUMA 节点(节点 0:CPU 0-127,节点 1:CPU 128-255),工作负载绑定至节点 1;缓存配置:L1d 12 MiB,L1i 8 MiB,L2 256 MiB,L3 1 GiB;BIOS RVOT1004C;Ubuntu 22.04.5 LTS,内核版本 5.15.0-174-generic。软件:llama.cpp 版本 b9326;AMD ZenDNN 5.2.2;矩阵乘法算法 ZENDNNL_MATMUL_ALGO=1 (AOCL-DLP)。基准为原生 llama.cpp CPU 后端;ZenDNN 加速配置采用同一编译版本,并开启 -DGGML_ZENDNN=ON。基准测试:llama-batched-bench,512 个 token 的提示词输入,生成 128 个 token,128 个并行序列 (512/128/128);Flash Attention 开启;KV 缓存精度与模型精度保持一致;针对每个后端调优微批次 (-ub) 参数;每项测试运行 3 次,取平均值。提示词处理吞吐量(token 数/秒),BF16 模型,数值越高越好:模型 原生 CPU ZenDNN 加速倍率
gemma-4-E4B 1172.32 2341.72 2.00x
gpt-oss-20B 1187.31 2589.40 2.18x
Llama-3.1-8B-Instruct 694.18 1233.85 1.78x
Mixtral-8x7B-Instruct-v0.1 209.15 771.73 3.69x
phi-4 403.06 751.24 1.86x
Qwen3.5-4B 1209.53 2307.04 1.91x
结果可能会因系统配置、软件版本和 BIOS 设置等因素而有所不同。
- ZD-067:结果基于截至 2026 年 6 月 15 日的 AMD 内部测试。AMD 系统:双路 AMD EPYC(霄龙)9755 128 核处理器,仅使用单路,禁用 SMT(1 线程/核心),NPS1 模式,最大加速频率 4.06 GHz;共计 256 个线程,分布于 2 个 NUMA 节点(节点 0:CPU 0-127,节点 1:CPU 128-255),工作负载绑定至节点 1;缓存配置:L1d 12 MiB,L1i 8 MiB,L2 256 MiB,L3 1 GiB;BIOS RVOT1004C;Ubuntu 22.04.5 LTS,内核版本 5.15.0-174-generic。软件:llama.cpp 版本 b9326;AMD ZenDNN 5.2.2;矩阵乘法算法 ZENDNNL_MATMUL_ALGO=1 (AOCL-DLP)。基准为原生 llama.cpp CPU 后端;ZenDNN 加速配置采用同一编译版本,并开启 -DGGML_ZENDNN=ON。基准测试:llama-batched-bench,512 个 token 的提示词输入,生成 128 个 token,128 个并行序列 (512/128/128);Flash Attention 开启;KV 缓存精度与模型精度保持一致;针对每个后端调优微批次 (-ub) 参数;每项测试运行 3 次,取平均值。提示词处理吞吐量(token 数/秒),Q8_0 模型,数值越高越好:模型 原生 CPU ZenDNN 加速倍率
gemma-4-12B-it 422.94 986.31 2.33x
gemma-4-31B-it 163.58 404.54 2.47x
Mistral-Small-3.2-24B-Instruct-2506 237.18 620.85 2.62x
Mixtral-8x7B-Instruct-v0.1 209.84 954.14 4.55x
Qwen3.5-9B 633.40 1557.65 2.46x
Qwen3.6-27B 190.73 517.55 2.71x
结果可能会因系统配置、软件版本和 BIOS 设置等因素而有所不同。
- ZD-068:结果基于截至 2026 年 6 月 15 日的 AMD 内部测试。AMD 系统:双路 AMD EPYC(霄龙)9755 128 核处理器,仅使用单路,禁用 SMT(1 线程/核心),NPS1 模式,最大加速频率 4.06 GHz;共计 256 个线程,分布于 2 个 NUMA 节点(节点 0:CPU 0-127,节点 1:CPU 128-255),工作负载绑定至节点 1;缓存配置:L1d 12 MiB,L1i 8 MiB,L2 256 MiB,L3 1 GiB;BIOS RVOT1004C;Ubuntu 22.04.5 LTS,内核版本 5.15.0-174-generic。软件:llama.cpp 版本 b9326;AMD ZenDNN 5.2.2;矩阵乘法算法 ZENDNNL_MATMUL_ALGO=1 (AOCL-DLP)。基准为原生 llama.cpp CPU 后端;ZenDNN 加速配置采用同一编译版本,并开启 -DGGML_ZENDNN=ON。基准测试:llama-batched-bench,512 个 token 的提示词输入,生成 128 个 token,128 个并行序列 (512/128/128);Flash Attention 开启;KV 缓存精度与模型精度保持一致;针对每个后端调优微批次 (-ub) 参数;每项测试运行 3 次,取平均值。总端到端吞吐量(token 数/秒),数值越高越好:模型 (BF16) 原生 CPU ZenDNN 加速倍率
gemma-4-E4B 1013.85 1550.29 1.53x
gpt-oss-20B 1024.95 1558.54 1.52x
Llama-3.1-8B-Instruct 632.17 914.85 1.45x
Mixtral-8x7B-Instruct-v0.1 188.42 433.45 2.30x
phi-4 374.29 568.70 1.52x
Qwen3.5-4B 717.55 924.28 1.29x
模型 (Q8_0) 原生 CPU ZenDNN 加速倍率 gemma-4-12B-it 397.06 695.38 1.75x
gemma-4-31B-it 156.06 286.03 1.83x
Mistral-Small-3.2-24B-Instruct-2506 231.06 446.51 1.93x
Mixtral-8x7B-Instruct-v0.1 201.90 573.59 2.84x
Qwen3.5-9B 468.31 723.37 1.54x
Qwen3.6-27B 153.53 260.09 1.69x
结果可能会因系统配置、软件版本和 BIOS 设置等因素而有所不同。
- ZD-069:结果基于截至 2026 年 6 月 15 日的 AMD 内部测试。AMD 系统:双路 AMD EPYC(霄龙)9755 128 核处理器,仅使用单路,禁用 SMT(1 线程/核心),NPS1 模式,最大加速频率 4.06 GHz;共计 256 个线程,分布于 2 个 NUMA 节点(节点 0:CPU 0-127,节点 1:CPU 128-255),工作负载绑定至节点 1;缓存配置:L1d 12 MiB,L1i 8 MiB,L2 256 MiB,L3 1 GiB;BIOS RVOT1004C;Ubuntu 22.04.5 LTS,内核版本 5.15.0-174-generic。软件:llama.cpp 版本 b9326;AMD ZenDNN 5.2.2;矩阵乘法算法 ZENDNNL_MATMUL_ALGO=1 (AOCL-DLP)。基准为原生 llama.cpp CPU 后端;ZenDNN 加速配置采用同一编译版本,并开启 -DGGML_ZENDNN=ON。精度:通过 llama-perplexity 基于 WikiText-2 (wiki.test.raw) 数据集测试困惑度,上下文长度设为 512 个 token。两个后端运行完全相同的 GGUF 模型,且保持相同的线程数、核心绑定、Flash Attention 以及 KV 缓存类型;后端类型是唯一的变量。困惑度的数值越低越好。
模型 精度 原生 CPU ZenDNN 差值
Llama-3.1-8B BF16 7.3214 7.3214 0.0000
Mixtral-8x7B BF16 (MoE) 4.4087 4.4083 0.0004
Mixtral-8x7B Q8_0 (MoE) 4.4134 4.4136 0.0002
结果可能会因系统配置、软件版本和 BIOS 设置等因素而有所不同。
附注
附注
- ZD-066:结果基于截至 2026 年 6 月 15 日的 AMD 内部测试。AMD 系统:双路 AMD EPYC(霄龙)9755 128 核处理器,仅使用单路,禁用 SMT(1 线程/核心),NPS1 模式,最大加速频率 4.06 GHz;共计 256 个线程,分布于 2 个 NUMA 节点(节点 0:CPU 0-127,节点 1:CPU 128-255),工作负载绑定至节点 1;缓存配置:L1d 12 MiB,L1i 8 MiB,L2 256 MiB,L3 1 GiB;BIOS RVOT1004C;Ubuntu 22.04.5 LTS,内核版本 5.15.0-174-generic。软件:llama.cpp 版本 b9326;AMD ZenDNN 5.2.2;矩阵乘法算法 ZENDNNL_MATMUL_ALGO=1 (AOCL-DLP)。基准为原生 llama.cpp CPU 后端;ZenDNN 加速配置采用同一编译版本,并开启 -DGGML_ZENDNN=ON。基准测试:llama-batched-bench,512 个 token 的提示词输入,生成 128 个 token,128 个并行序列 (512/128/128);Flash Attention 开启;KV 缓存精度与模型精度保持一致;针对每个后端调优微批次 (-ub) 参数;每项测试运行 3 次,取平均值。提示词处理吞吐量(token 数/秒),BF16 模型,数值越高越好:模型 原生 CPU ZenDNN 加速倍率
gemma-4-E4B 1172.32 2341.72 2.00x
gpt-oss-20B 1187.31 2589.40 2.18x
Llama-3.1-8B-Instruct 694.18 1233.85 1.78x
Mixtral-8x7B-Instruct-v0.1 209.15 771.73 3.69x
phi-4 403.06 751.24 1.86x
Qwen3.5-4B 1209.53 2307.04 1.91x
结果可能会因系统配置、软件版本和 BIOS 设置等因素而有所不同。
- ZD-067:结果基于截至 2026 年 6 月 15 日的 AMD 内部测试。AMD 系统:双路 AMD EPYC(霄龙)9755 128 核处理器,仅使用单路,禁用 SMT(1 线程/核心),NPS1 模式,最大加速频率 4.06 GHz;共计 256 个线程,分布于 2 个 NUMA 节点(节点 0:CPU 0-127,节点 1:CPU 128-255),工作负载绑定至节点 1;缓存配置:L1d 12 MiB,L1i 8 MiB,L2 256 MiB,L3 1 GiB;BIOS RVOT1004C;Ubuntu 22.04.5 LTS,内核版本 5.15.0-174-generic。软件:llama.cpp 版本 b9326;AMD ZenDNN 5.2.2;矩阵乘法算法 ZENDNNL_MATMUL_ALGO=1 (AOCL-DLP)。基准为原生 llama.cpp CPU 后端;ZenDNN 加速配置采用同一编译版本,并开启 -DGGML_ZENDNN=ON。基准测试:llama-batched-bench,512 个 token 的提示词输入,生成 128 个 token,128 个并行序列 (512/128/128);Flash Attention 开启;KV 缓存精度与模型精度保持一致;针对每个后端调优微批次 (-ub) 参数;每项测试运行 3 次,取平均值。提示词处理吞吐量(token 数/秒),Q8_0 模型,数值越高越好:模型 原生 CPU ZenDNN 加速倍率
gemma-4-12B-it 422.94 986.31 2.33x
gemma-4-31B-it 163.58 404.54 2.47x
Mistral-Small-3.2-24B-Instruct-2506 237.18 620.85 2.62x
Mixtral-8x7B-Instruct-v0.1 209.84 954.14 4.55x
Qwen3.5-9B 633.40 1557.65 2.46x
Qwen3.6-27B 190.73 517.55 2.71x
结果可能会因系统配置、软件版本和 BIOS 设置等因素而有所不同。
- ZD-068:结果基于截至 2026 年 6 月 15 日的 AMD 内部测试。AMD 系统:双路 AMD EPYC(霄龙)9755 128 核处理器,仅使用单路,禁用 SMT(1 线程/核心),NPS1 模式,最大加速频率 4.06 GHz;共计 256 个线程,分布于 2 个 NUMA 节点(节点 0:CPU 0-127,节点 1:CPU 128-255),工作负载绑定至节点 1;缓存配置:L1d 12 MiB,L1i 8 MiB,L2 256 MiB,L3 1 GiB;BIOS RVOT1004C;Ubuntu 22.04.5 LTS,内核版本 5.15.0-174-generic。软件:llama.cpp 版本 b9326;AMD ZenDNN 5.2.2;矩阵乘法算法 ZENDNNL_MATMUL_ALGO=1 (AOCL-DLP)。基准为原生 llama.cpp CPU 后端;ZenDNN 加速配置采用同一编译版本,并开启 -DGGML_ZENDNN=ON。基准测试:llama-batched-bench,512 个 token 的提示词输入,生成 128 个 token,128 个并行序列 (512/128/128);Flash Attention 开启;KV 缓存精度与模型精度保持一致;针对每个后端调优微批次 (-ub) 参数;每项测试运行 3 次,取平均值。总端到端吞吐量(token 数/秒),数值越高越好:模型 (BF16) 原生 CPU ZenDNN 加速倍率
gemma-4-E4B 1013.85 1550.29 1.53x
gpt-oss-20B 1024.95 1558.54 1.52x
Llama-3.1-8B-Instruct 632.17 914.85 1.45x
Mixtral-8x7B-Instruct-v0.1 188.42 433.45 2.30x
phi-4 374.29 568.70 1.52x
Qwen3.5-4B 717.55 924.28 1.29x
模型 (Q8_0) 原生 CPU ZenDNN 加速倍率 gemma-4-12B-it 397.06 695.38 1.75x
gemma-4-31B-it 156.06 286.03 1.83x
Mistral-Small-3.2-24B-Instruct-2506 231.06 446.51 1.93x
Mixtral-8x7B-Instruct-v0.1 201.90 573.59 2.84x
Qwen3.5-9B 468.31 723.37 1.54x
Qwen3.6-27B 153.53 260.09 1.69x
结果可能会因系统配置、软件版本和 BIOS 设置等因素而有所不同。
- ZD-069:结果基于截至 2026 年 6 月 15 日的 AMD 内部测试。AMD 系统:双路 AMD EPYC(霄龙)9755 128 核处理器,仅使用单路,禁用 SMT(1 线程/核心),NPS1 模式,最大加速频率 4.06 GHz;共计 256 个线程,分布于 2 个 NUMA 节点(节点 0:CPU 0-127,节点 1:CPU 128-255),工作负载绑定至节点 1;缓存配置:L1d 12 MiB,L1i 8 MiB,L2 256 MiB,L3 1 GiB;BIOS RVOT1004C;Ubuntu 22.04.5 LTS,内核版本 5.15.0-174-generic。软件:llama.cpp 版本 b9326;AMD ZenDNN 5.2.2;矩阵乘法算法 ZENDNNL_MATMUL_ALGO=1 (AOCL-DLP)。基准为原生 llama.cpp CPU 后端;ZenDNN 加速配置采用同一编译版本,并开启 -DGGML_ZENDNN=ON。精度:通过 llama-perplexity 基于 WikiText-2 (wiki.test.raw) 数据集测试困惑度,上下文长度设为 512 个 token。两个后端运行完全相同的 GGUF 模型,且保持相同的线程数、核心绑定、Flash Attention 以及 KV 缓存类型;后端类型是唯一的变量。困惑度的数值越低越好。 模型 精度 原生 CPU ZenDNN 差值 Llama-3.1-8B BF16 7.3214 7.3214 0.0000 Mixtral-8x7B BF16 (MoE) 4.4087 4.4083 0.0004 Mixtral-8x7B Q8_0 (MoE) 4.4134 4.4136 0.0002 结果可能会因系统配置、软件版本和 BIOS 设置等因素而有所不同。

Related Blogs
-
-
-
AMD Advancing AI 2026 前瞻:精彩内容抢先看
抢先了解“AMD Advancing AI 2026”大会,探索塑造 AI 未来的核心议题、会议环节及创新技术。了解行业领军者如何携手合作,共同探讨实际应用场景以及在企业范围内规模化部署 AI 的策略。
July 14, 2026
-
-
AMD Ryzen AI 开发者平台:开源、就绪,专为 AI 而生
了解 AMD Ryzen AI 开发者平台:开源、AI 优先,致力于帮助开发者构建、测试和部署 AI 工作负载。
July 06, 2026
-
HandBrake 1.11.0 提升 AMD 锐龙 Threadripper 及 Threadripper PRO 的可扩展性
AMD 帮助 HandBrake 1.11.0 优化了高核心数 Threadripper 系统的线程管理和转码性能。
June 17, 2026
-
Vultr 通过 AMD 软件组件助力企业级 AI 发展
Vultr 在 Vultr Marketplace 上提供 AMD 企业级 AI 软件组件,助力企业实现 AI 规模化应用。
June 15, 2026
-