
GPU AMD Instinct
Descubre cómo los aceleradores AMD Instinct potencian la IA y la HPC.

Crea y entrena modelos de IA con marcos de trabajo familiares, luego optimízalos y ejecútalos en GPU AMD, desde un solo sistema hasta implementaciones de múltiples nodos.

Algunos equipos necesitan entrenar o ajustar un modelo; otros, poner en producción un modelo abierto existente. ROCm es compatible con ambas opciones en GPU AMD, con flujos de trabajo de entrenamiento distribuido y software para optimizar, ejecutar y operar la inferencia de IA a gran escala.
Implementa los principales modelos abiertos en GPU de AMD con una pila de inferencia de código totalmente abierto. Empieza a trabajar rápidamente con contenedores preconfigurados y compatibilidad con marcos integrados.
Elige tu motor
AMD ROCm ofrece una pila de inferencia de extremo a extremo con compatibilidad con marcos de trabajo ascendentes, contenedores para vLLM o SGLang, y mucho más para que tu equipo pueda comenzar con el software de inferencia establecido antes de integrar un modelo en tu aplicación.
Menor tamaño
ROCm combina paquetes de modelos cuantificados con ejecución nativa de baja precisión y kernels de ruta crítica de transformadores optimizados para reducir el esfuerzo de ajuste al tiempo que maximiza el rendimiento y la eficiencia para la ejecución real.
Satisface la creciente demanda
Cuando un volumen de solicitud o modelo supera la capacidad de un servidor, distribuye la ejecución en GPU AMD Instinct™. Las implementaciones compatibles pueden separar el prellenado y la decodificación para que los equipos puedan asignar recursos a cada etapa.
Control de equipamiento
ROCm se integra en Kubernetes a través del operador de GPU de AMD, la telemetría integrada y una arquitectura modular de controladores, lo que admite la implementación automatizada, la observabilidad y una gestión del ciclo de vida predecible en entornos seguros y aislados.
Desde flujos de trabajo unificados hasta confiabilidad a escala de clúster, Primus simplifica y acelera el entrenamiento de modelos grandes.
Flexibilidad del marco de trabajo
Comienza el entrenamiento en GPU AMD Instinct™ con flujos de trabajo unificados a través de las fórmulas de AMD Primus para Megatron-LM, PyTorch TorchTitan o JAX MaxText. Usa una sola CLI y configuraciones reutilizables para volver a ejecutar experimentos y comparar cambios.
Mantén las GPU ocupadas
Primus mejora el rendimiento del entrenamiento y la utilización de GPU con kernels optimizados y aceleración basada en la comunicación. Los equipos pueden utilizar estas capacidades a través de la pila de Primus completa o conectar Primus Turbo en entornos de entrenamiento personalizados.
Mantén los trabajos en movimiento
Cuando un modelo supera la capacidad de un servidor, Primus ayuda a distribuir el entrenamiento en nodos y GPU AMD Instinct™. Primus-SaFE utiliza la ubicación basada en la topología y los reintentos automáticos para ayudar a que los trabajos de ejecución prolongada se recuperen de las interrupciones a medida que aumentan los clústeres.
Revisa y realiza un seguimiento
Primus ayuda a los equipos a evaluar el estado de los nodos antes de iniciar trabajos de entrenamiento grandes. Durante el entrenamiento, la telemetría y los paneles proporcionan visibilidad del rendimiento y el estado del clúster, lo que ayuda a los equipos a identificar los problemas y solucionarlos con mayor rapidez.
Lee acerca de los avances más recientes en el desarrollo de la IA mediante ROCm.
Pre-train hybrid LLMs mixing MLA attention with Gated DeltaNet, Kimi Delta Attention and Mamba2 mixers on AMD Instinct MI355X GPUs, with open recipes.
October 07, 2026
Learn how to serve a 1.4 TiB Kimi-K3 MXFP4 mixture-of-experts model disaggregated across AMD Instinct MI300X and MI325X GPUs.
October 07, 2026
Explore the MI455X vs MI355X inference numbers from Advancing AI 2026, and learn how each benchmark was measured and what it really means.
October 07, 2026
TraceLens Agent is an agentic workflow that examines GPU traces to deliver a prioritized optimization report, detailing root causes and fixes.
September 29, 2026
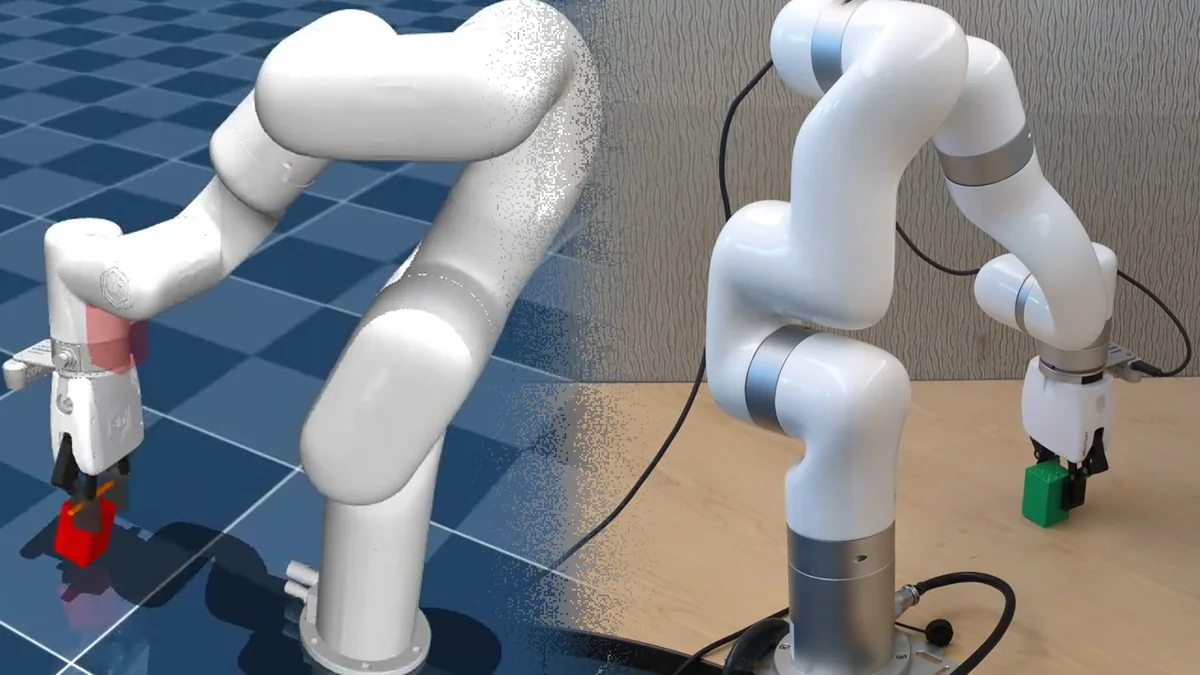
Train an XArm-6 pick-and-lift policy with PPO in MuJoCo Warp on AMD Instinct GPUs, then transfer it to the real robot.
September 28, 2026
Quantize a 35B MoE model directly on AMD Strix Halo with AMD Quark, export to GGUF and safetensors, validate with llama.cpp and vLLM, and deploy throu…
September 24, 2026
Introduce Model Weight Profiles and compare embeddings, attention, and dense layers so checkpoint size and quantization savings make sense.
September 24, 2026
Scale agentic AI at the edge with AMD Ryzen™ AI Embedded X100 Series: more concurrent agents, unified memory, x86 compatibility, and long life.
September 24, 2026

Recibe las últimas noticias de ROCm.
©2024 Advanced Micro Devices, Inc. Todos los derechos reservados. AMD, el logotipo de la flecha de AMD, AMD ROCm, AMD Instinct, EPYC, Radeon Instinct y sus combinaciones son marcas registradas de Advanced Micro Devices, Inc. PyTorch es una marca comercial o marca comercial registrada de PyTorch. Los otros nombres de productos utilizados en esta publicación se presentan solo con fines de identificación y pueden ser marcas comerciales de sus respectivas empresas.