
GPU AMD Instinct
Découvrez comment les accélérateurs AMD Instinct dynamisent l'IA et le HPC.

Créez et entraînez des modèles d'IA à l'aide de frameworks familiers, puis optimisez-les et mettez-les en production sur des GPU AMD, qu'il s'agisse d'un système unique ou de déploiements multinœuds.

Certaines équipes doivent entraîner ou ajuster un modèle, tandis que d'autres cherchent à mettre en production un modèle ouvert existant. ROCm prend en charge ces deux approches sur les GPU AMD, grâce à des flux de travail d'entraînement distribué et à des softwares permettant d'optimiser, de déployer et de développer l'inférence d'IA à grande échelle.
Déployez les meilleurs modèles ouverts sur les GPU AMD à l'aide d'une pile d'inférence entièrement open source. Soyez opérationnel rapidement grâce à des conteneurs préconfigurés et à la prise en charge des frameworks en amont.
Choisissez votre moteur
AMD ROCm propose une pile d'inférence complète avec la prise en charge des frameworks en amont, des conteneurs vLLM ou SGLang, ainsi que d'autres composants afin que votre équipe puisse démarrer rapidement avec des softwares d'inférence éprouvés avant d'intégrer un modèle à votre application.
Empreinte réduite¹
ROCm associe des paquets de modèles quantifiés à une exécution native en basse précision et à des noyaux de chemin critique optimisés pour les transformateurs, afin de réduire l'effort de réglage tout en maximisant le débit et l'efficacité pour une mise en service en conditions réelles.
Répondez à une demande croissante
Lorsqu'un modèle ou un volume de requêtes dépasse les capacités d'un seul serveur, répartissez la mise en service sur plusieurs GPU AMD Instinct™. Les déploiements compatibles peuvent séparer les phases de préremplissage et de décodage afin d'allouer les ressources de manière optimale.
Contrôlez votre parc
ROCm s'intègre à Kubernetes via AMD GPU Operator, la télémétrie intégrée et une architecture de pilotes modulaire, prenant en charge le déploiement automatisé, l'observabilité et la gestion prévisible du cycle de vie dans des environnements sécurisés et isolés physiquement.
Des flux de travail unifiés à la fiabilité à l'échelle du cluster, Primus simplifie et accélère l'entraînement de grands modèles.
Frameworks flexibles
Commencez à entraîner vos modèles sur les GPU AMD Instinct™ à l'aide de flux de travail unifiés via les recettes AMD Primus pour Megatron-LM, PyTorch TorchTitan ou JAX MaxText. Utilisez une interface CLI unique et des configurations réutilisables pour réexécuter vos expériences et comparer facilement les modifications.
Maximisez l'utilisation des GPU
Primus améliore le débit d'entraînement et l'utilisation des GPU grâce à des noyaux optimisés et à une accélération tenant compte des communications. Les équipes peuvent utiliser ces fonctionnalités via l'ensemble de la pile Primus ou intégrer Primus Turbo à leurs environnements d'entraînement personnalisés.
Maximisez l'exécution de vos tâches
Lorsqu'un modèle dépasse les capacités d'un seul serveur, Primus facilite la distribution de l'entraînement sur plusieurs GPU et nœuds AMD Instinct™. Primus-SaFE utilise un placement tenant compte de la topologie du système et des mécanismes automatiques de relance afin d'aider les tâches de longue durée à se remettre des interruptions, même lorsque les clusters gagnent en taille.
Vérifiez et surveillez
Primus aide les équipes à évaluer l'état des nœuds avant le lancement d'importantes tâches d'entraînement. Pendant l'exécution, ses outils de télémétrie et ses tableaux de bord offrent une visibilité complète sur les performances et la santé du cluster, afin d'aider les équipes à identifier les problèmes et à les résoudre plus rapidement.
Découvrez les dernières avancées dans le domaine du développement de l'IA avec ROCm.
TraceLens Agent is an agentic workflow that examines GPU traces to deliver a prioritized optimization report, detailing root causes and fixes.
September 29, 2026
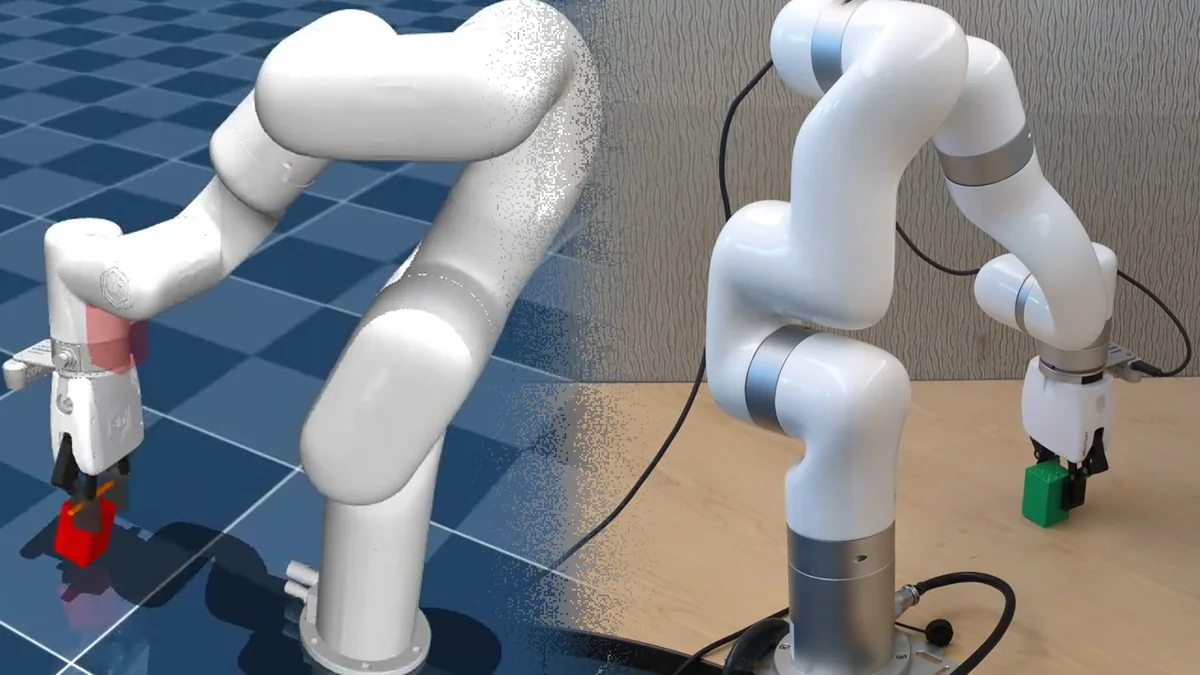
Train an XArm-6 pick-and-lift policy with PPO in MuJoCo Warp on AMD Instinct GPUs, then transfer it to the real robot.
September 28, 2026
Quantize a 35B MoE model directly on AMD Strix Halo with AMD Quark, export to GGUF and safetensors, validate with llama.cpp and vLLM, and deploy throu…
September 24, 2026
Introduce Model Weight Profiles and compare embeddings, attention, and dense layers so checkpoint size and quantization savings make sense.
September 24, 2026
Scale agentic AI at the edge with AMD Ryzen™ AI Embedded X100 Series: more concurrent agents, unified memory, x86 compatibility, and long life.
September 24, 2026
Learn to debug logprob mismatches between rollout and training with Qwen3 examples on AMD Instinct MI355X GPUs.
September 22, 2026
Learn how one declarative madengine command benchmarks day-0 Kimi-K3 across vLLM, SGLang, and ATOM on AMD Instinct MI350X.
September 21, 2026
Upcycle pretrained Transformers into long-context hybrid MLA + linear models on AMD Instinct MI300X GPUs, with 14 open checkpoints and training code.
September 21, 2026

Recevez les dernières actualités concernant ROCm.
©2024 Advanced Micro Devices, Inc. Tous droits réservés. AMD, le logo AMD avec la flèche, AMD ROCm, AMD Instinct, EPYC, Radeon Instinct et leurs combinaisons sont des marques commerciales d'Advanced Micro Devices, Inc. PyTorch est une marque commerciale ou une marque déposée de PyTorch. Les autres noms de produits cités dans cette publication ne sont mentionnés qu'à des fins d'identification et peuvent être des marques déposées de leurs sociétés respectives.