


概述
針對 AI 工作負載最佳化
有些團隊需要訓練或微調模型;有些團隊需要將現有的開放式模型投入生產。 對於 AMD 顯示卡,ROCm 兩種路徑都有支援,既提供適用於分散式訓練的工作流程,也提供用於大規模最佳化、提供和運行 AI 推論的軟體。
AI 推論
使用 ROCm 開發生產級 AI 推論
運用完全開放原始碼推論堆疊,使用 AMD 顯示卡部署領先的開放式模型。透過預先建置的容器與上游架構支援,來啟動並執行。
選擇您的引擎
開始提供開放式模型
AMD ROCm 提供具備上游架構支援、vLLM 或 SGLang 容器等項目的端對端推論堆疊,讓您的團隊可先從既有的推論軟體開始,再將模型整合到應用程式中。
更小的佔用空間
提升記憶體與服務效率
ROCm 將量化模型套件,與原生低精度執行及最佳化的 Transformer 熱點路徑內核結合,可減少調整工作,同時為真實世界的部署運作充分提升輸送量與效率。
滿足不斷成長的需求
將推論擴充到多個顯示卡與節點
模型或要求數量的成長速度快過一台伺服器所能負荷的程度時,可將服務分散到多個 AMD Instinct™ 顯示卡。支援的部署可將預填與解碼分離,讓團隊能分別為各階段配置資源。
機群控制
使用 Kubernetes 運行推論
ROCm 透過 AMD GPU Operator、內建遙測與模組化驅動程式架構與 Kubernetes 整合,可在安全及實體隔離的環境中支援自動化部署、可觀察性,以及可預測的生命週期管理。
AI 訓練
使用 AMD 顯示卡進行大規模端對端 AI 訓練
從統一工作流程到叢集規模可靠性,Primus 可簡化並加速大型模型訓練。
架構彈性
啟動可重現的訓練任務
透過適用於 Megatron-LM、PyTorch TorchTitan 或 JAX MaxText 的 AMD Primus 訓練方案,運用統一工作流程以 AMD Instinct™ 顯示卡開始訓練。使用單一 CLI 與可重複使用的配置,來再次執行實驗並比較差異。
讓顯示卡保持高使用率
解決 Transformer 訓練瓶頸
Primus 透過最佳化內核與通訊感知加速,來提高訓練輸送量與顯示卡使用率。團隊可透過完整 Primus 堆疊使用這些功能,也可將 Primus Turbo 整合到自訂訓練環境中。
讓工作持續推進
可擴充的分散式訓練
模型的成長速度快過單一伺服器的成長速度時,Primus 可協助將訓練分散到多個 AMD Instinct™ 顯示卡與節點。在叢集數量成長時,Primus-SaFE 透過拓撲感知配置與自動重試,協助長時間執行的工作從中斷復原。
檢查,然後追蹤
企業級的訓練作業
Primus 可協助團隊在啟動大型訓練工作前評估節點健康狀況。訓練期間,其遙測與儀表板可提供效能與叢集健康狀況的可視性,協助團隊更快找出並排除問題。
最新消息
閱讀在 AI 開發方面使用 ROCm 的最新進展。
-
Long Context, One Node: Serving GLM-5.3-FP8 on MI300X with DP8+EP8 — ROCm Blogs
Learn how to serve GLM-5.3-FP8 on one AMD Instinct™ MI300X node with DP8+EP8 and vLLM v0.28 for long-context workloads, and compare it with TP=8.
October 13, 2026
-
Pre-Training Hybrid LLMs from Scratch in Primus on AMD Instinct™ GPUs — ROCm Blogs
Pre-train hybrid LLMs mixing MLA attention with Gated DeltaNet, Kimi Delta Attention and Mamba2 mixers on AMD Instinct MI355X GPUs, with open recipes.
October 07, 2026
-
DI Series: Serving Kimi-K3 MXFP4 Wide-EP Disaggregated on AMD Instinct MI300X and MI325X — ROCm Blogs
Learn how to serve a 1.4 TiB Kimi-K3 MXFP4 mixture-of-experts model disaggregated across AMD Instinct MI300X and MI325X GPUs.
October 07, 2026
-
AMD Instinct MI455X vs MI355X: A Technical Look at the Advancing AI 2026 Inference Numbers — ROCm Blogs
Explore the MI455X vs MI355X inference numbers from Advancing AI 2026, and learn how each benchmark was measured and what it really means.
October 07, 2026
-
Automating Performance Bottleneck Identification with the TraceLens Agent — ROCm Blogs
TraceLens Agent is an agentic workflow that examines GPU traces to deliver a prioritized optimization report, detailing root causes and fixes.
September 29, 2026
-
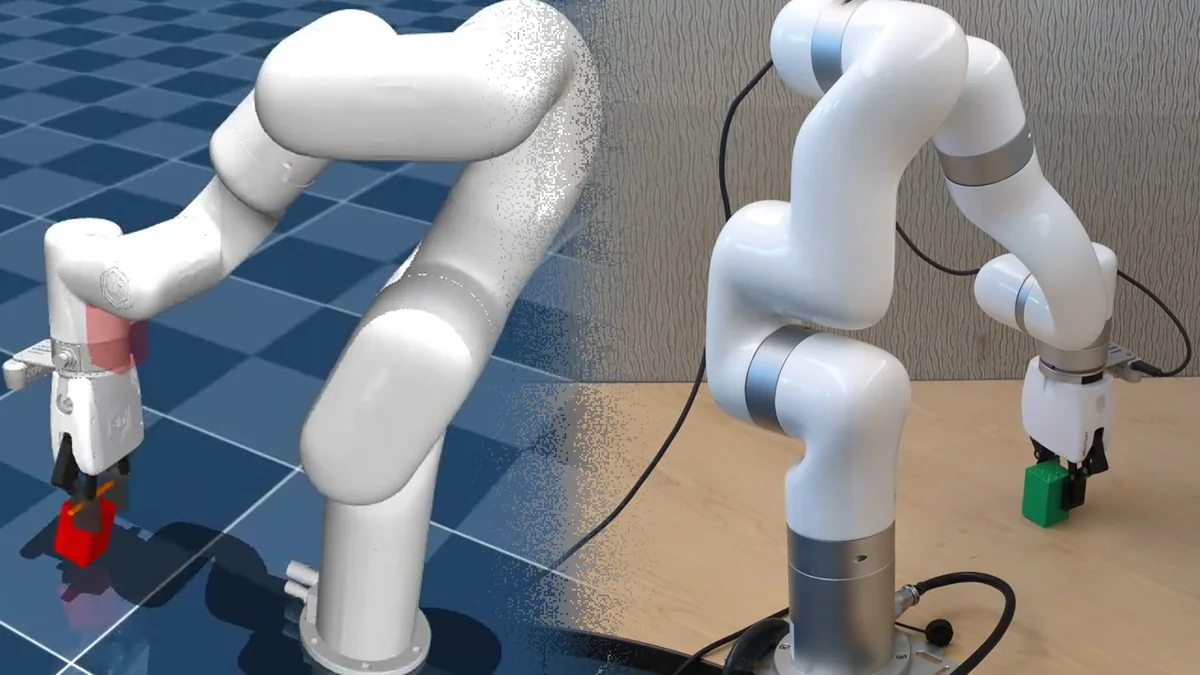
Unlocking Sim2Real for a Robotic Arm with RL Accelerated by AMD Instinct GPUs — ROCm Blogs
Train an XArm-6 pick-and-lift policy with PPO in MuJoCo Warp on AMD Instinct GPUs, then transfer it to the real robot.
September 28, 2026
-
Local Quantization and Multi-Backend Deployment with AMD Quark on Strix Halo — ROCm Blogs
Quantize a 35B MoE model directly on AMD Strix Halo with AMD Quark, export to GGUF and safetensors, validate with llama.cpp and vLLM, and deploy throu…
September 24, 2026
-
Model Weight Profiles: Where Do the Parameters Go? — ROCm Blogs
Introduce Model Weight Profiles and compare embeddings, attention, and dense layers so checkpoint size and quantization savings make sense.
September 24, 2026

支援的硬體
開發人員資源
接收最新的 ROCm 資訊。
尾註
©2024 Advanced Micro Devices, Inc. 保留所有權利。AMD、AMD 箭頭標誌、AMD ROCm、AMD Instinct、EPYC、Radeon Instinct 及其相關組合為 Advanced Micro Devices, Inc. 的商標。PyTorch 為 PyTorch 的商標或註冊商標。本出版物中使用的其他產品名僅用於識別目的,可能屬於其各自公司的商標。
- 如需 ROCm 支援的 Radeon 料件完整清單,請前往 https://rocm.docs.amd.com/en/latest/reference/gpu-arch-specs.html