


概述
已针对 AI 工作负载进行优化
有些团队需要训练或微调模型;另一些团队则需要将已有的开源模型投入生产环境。 ROCm 在 AMD GPU 上同时支持上述两种场景,提供分布式训练工作流以及用于大规模优化、部署和运行 AI 推理的软件工具。
AI 推理
基于 ROCm 实现生产级 AI 推理
依托完全开源的推理技术栈,在 AMD GPU 上部署主流开源模型。凭借预构建的容器和上游框架支持,快速启动并运行。
选择您的引擎
开始部署开源模型
AMD ROCm 提供端到端推理栈,包含上游框架支持、vLLM 与 SGLang 容器等组件。团队可先使用成熟的推理软件起步,再将模型集成至应用中。
更小的占用空间
提高内存和服务效率
ROCm 将量化模型包、原生低精度执行能力和经过优化的 Transformer 热点路径内核相结合,减少调整工作量,同时充分提高实际服务的吞吐量和效率。
满足不断增长的需求
跨 GPU 和节点环境扩展推理能力
当模型或请求量超出单台服务器的处理能力时,可基于 AMD Instinct GPU 进行分布式服务部署。支持的部署可以将预填充和解码分开,以便团队可以为每个阶段分配资源。
机群控制
在 Kubernetes 上运行推理
ROCm 通过 AMD GPU Operator、内置遥测能力和模块化驱动程序架构与 Kubernetes 实现集成,支持在安全环境和物理隔离环境中实现自动化部署、可观测性以及可预测的生命周期管理。
AI 训练
基于 AMD GPU 的大规模端到端 AI 训练
从统一的工作流到集群级可靠性,Primus 可简化并加速大模型训练。
框架灵活性
启动可重复的训练任务
依托 AMD Primus 提供的 Megatron-LM、PyTorch TorchTitan、JAX MaxText 方案,在 AMD Instinct GPU 上通过统一工作流启动训练。使用单一 CLI 和可复用配置,重新运行实验并比较变更。
保持 GPU 高利用率
解决 Transformer 训练瓶颈
Primus 通过优化内核和通信感知加速技术,提升训练吞吐率与 GPU 利用率。团队可通过完整的 Primus 栈使用这些功能,或将 Primus Turbo 集成到自定义的训练环境中。
保持作业持续运行
可扩展的分布式训练
当模型超出单个服务器的处理能力时,Primus 支持跨 AMD Instinct GPU 和节点环境开展分布式训练。Primus-SaFE 采用拓扑感知布局与自动重试机制,随着集群规模扩大,帮助长时间运行的作业从中断故障中恢复。
先检查,然后跟踪
企业级训练和运维
Primus 可帮助团队在启动大型训练任务前评估节点健康状态。训练过程中,其遥测数据与控制面板可展示性能与集群健康状态,帮助团队快速确定并排查问题。
最新动态
了解有关使用 ROCm 进行 AI 开发的最新进展。
-
-
-
AMD Advancing AI 2026 前瞻:精彩内容抢先看
抢先了解“AMD Advancing AI 2026”大会,探索塑造 AI 未来的核心议题、会议环节及创新技术。了解行业领军者如何携手合作,共同探讨实际应用场景以及在企业范围内规模化部署 AI 的策略。
July 14, 2026
-
-
-
AMD 亮相 Microsoft Build 2026
在旧金山举办的 Microsoft Build 2026 大会上,开发者、工程师和 AI 构建者们齐聚一堂,AMD 举办了四场实操工作坊,向参会者全方位展示 AMD AI 生态系统
June 12, 2026
-
AMD Silo AI 与 Delphyr AI 强强联手,推动实用临床 AI 规模化落地
AMD Silo AI 与 Delphyr AI 联合推出可扩展、隐私保护优先的临床 AI 解决方案:实现更快速的电子病历 (EHR) 检索、高性能嵌入以及无缝工作流程集成。
June 02, 2026
-
智能体计算机:一次购买,尽享云级智能
探索由 AMD 技术赋能的智能体计算机如何将云端级 AI 带到用户身边,凭借本地高性能、可预测的成本以及更强的控制权等优势,全面支持持续运行的 AI 工作负载。
May 20, 2026

支持的硬件
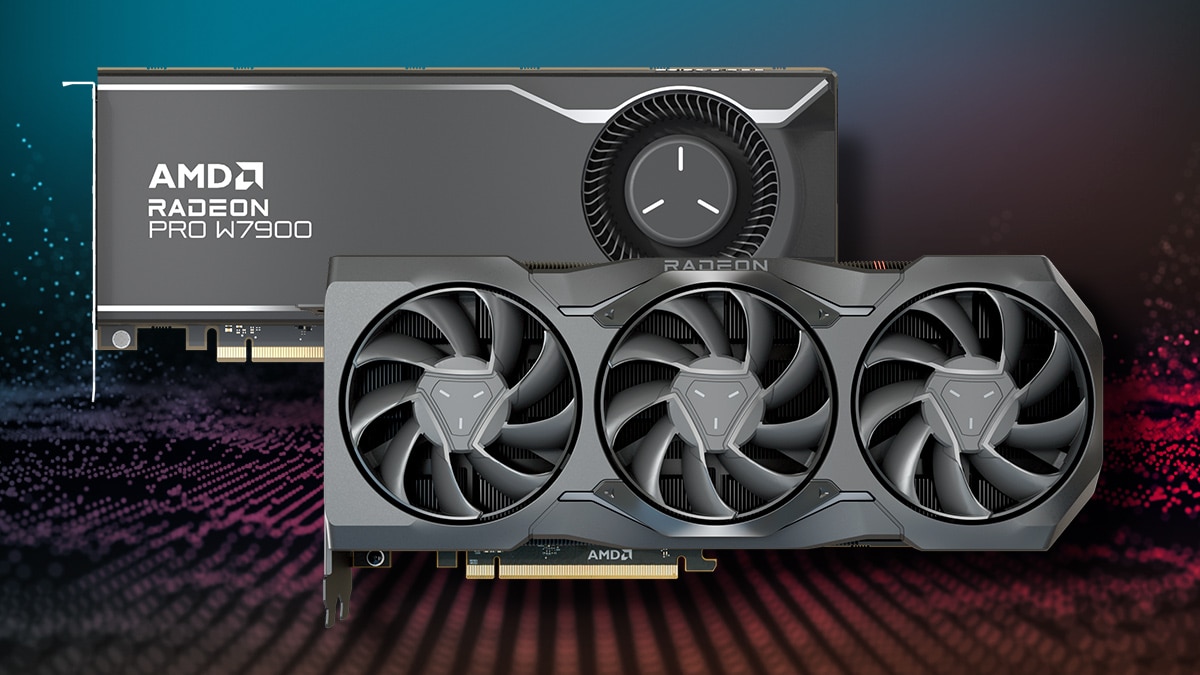

开发人员资源
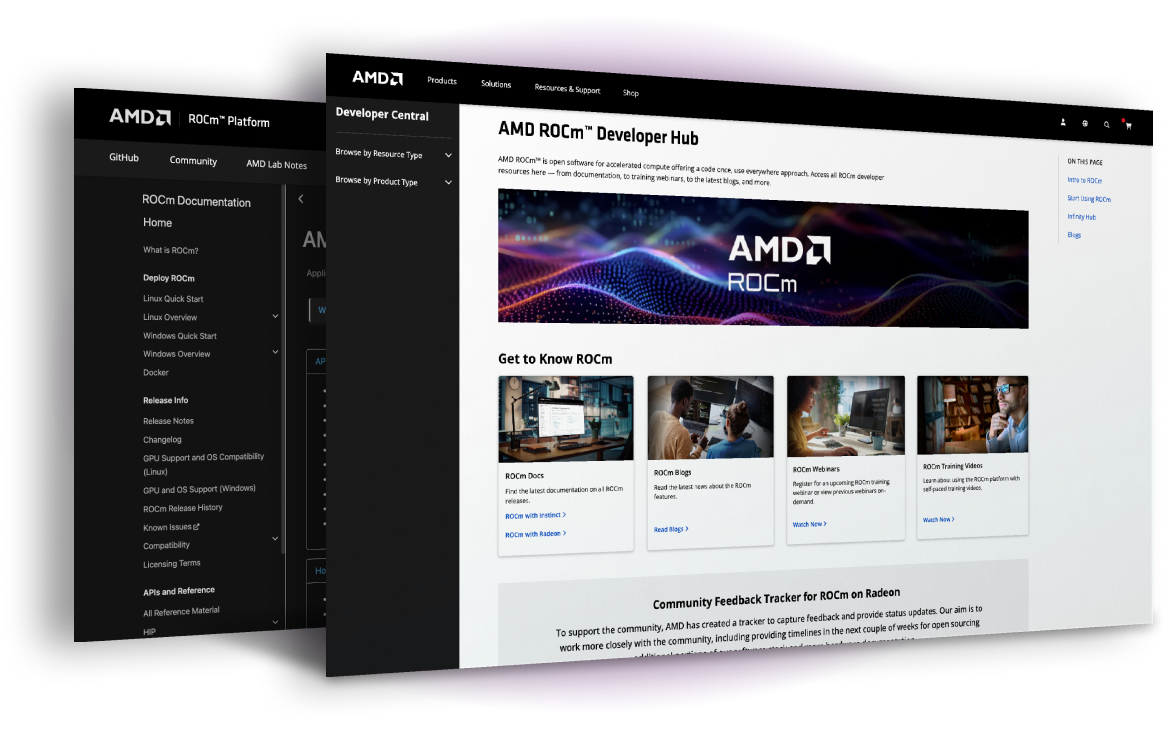
接收最新 ROCm 资讯。
附注
©2024 AMD 公司,版权所有。保留所有权利。AMD、AMD 箭头标识、AMD ROCm、AMD Instinct、霄龙、EPYC、Radeon Instinct 及其组合是 AMD 公司的商标。PyTorch 是 PyTorch 公司的商标或注册商标。本文中用到的其他产品名称仅用于标识目的,可能是其各自公司的商标。
- 如需了解 ROCm 所支持的全部 Radeon 产品,请访问 https://rocm.docs.amd.com/en/latest/reference/gpu-arch-specs.html
附注
©2024 AMD 公司,版权所有。保留所有权利。AMD、AMD 箭头标识、AMD ROCm、AMD Instinct、霄龙、EPYC、Radeon Instinct 及其组合是 AMD 公司的商标。PyTorch 是 PyTorch 公司的商标或注册商标。本文中用到的其他产品名称仅用于标识目的,可能是其各自公司的商标。
- 如需了解 ROCm 所支持的全部 Radeon 产品,请访问 https://rocm.docs.amd.com/en/latest/reference/gpu-arch-specs.html