
GPUs AMD Instinct
Descubra como os aceleradores AMD Instinct supercarregam a IA e a HPC.

Crie e treine modelos de IA com estruturas familiares, depois otimize-os e forneça-os em GPUs AMD, de um único sistema a implantações de vários nós.

Algumas equipes precisam treinar ou ajustar um modelo; outras precisam colocar um modelo aberto existente em produção. O ROCm possibilita ambos os caminhos em GPUs AMD, com fluxos de trabalho para treinamento distribuído e software para otimizar, fornecer e operar inferência de IA em escala.
Implante os principais modelos abertos em GPUs AMD usando uma pilha de inferência de código totalmente aberto. Comece a trabalhar com contêineres pré-criados e suporte a estrutura de upstream.
Escolha seu mecanismo
O AMD ROCm fornece uma pilha de inferência completa com suporte a estruturas upstream, contêineres vLLM ou SGLang e muito mais, para que sua equipe possa começar com um software de inferência estabelecido antes de integrar um modelo à sua aplicação.
Redução na ocupação de espaço
O ROCm combina pacotes de modelos quantizados com execução nativa de baixa precisão e kernels de caminho crítico otimizados para transformadores, reduzindo o esforço de ajuste e maximizando a taxa de transferência e a eficiência na execução em ambientes reais.
Atenda à crescente demanda
Quando um modelo ou o volume de solicitações ultrapassar a capacidade de um servidor, distribua a execução entre GPUs AMD Instinct™. As implantações suportadas podem separar o preenchimento prévio e a decodificação para que as equipes consigam alocar recursos para cada estágio.
Controle de frota
O ROCm integra-se ao Kubernetes por meio do AMD GPU Operator, da telemetria integrada e de uma arquitetura modular de drivers, oferecendo suporte à implantação automatizada, à observabilidade e ao gerenciamento previsível do ciclo de vida em ambientes seguros e isolados da Internet.
De fluxos de trabalho unificados à confiabilidade em escala de cluster, o Primus simplifica e acelera o treinamento de grandes modelos.
Flexibilidade da estrutura
Comece a treinar em GPUs AMD Instinct™ com fluxos de trabalho unificados por meio das receitas do AMD Primus para Megatron-LM, PyTorch TorchTitan ou JAX MaxText. Use uma única CLI e configurações reutilizáveis para executar experimentos novamente e comparar as alterações.
Mantenha as GPUs ocupadas
O Primus melhora a eficiência do treinamento e a utilização das GPUs com kernels otimizados e aceleração com reconhecimento das características de comunicação. As equipes podem usar esses recursos por meio da pilha completa do Primus ou conectar o Primus Turbo em ambientes de treinamento personalizados.
Mantenha os trabalhos em andamento
Quando um modelo ultrapassa a capacidade de um único servidor, o Primus ajuda a distribuir o treinamento entre GPUs e nós AMD Instinct™. O Primus-SaFE usa posicionamento com reconhecimento de topologia e novas tentativas automáticas para ajudar trabalhos de longa execução a se recuperarem de interrupções à medida que os clusters crescem.
Verifique e monitore
O Primus ajuda as equipes a avaliar a integridade do nó antes de iniciar grandes trabalhos de treinamento. Durante o treinamento, sua telemetria e seus painéis fornecem visibilidade do desempenho e da integridade do cluster, ajudando as equipes a identificar problemas e solucioná-los mais rapidamente.
Leia sobre os últimos avanços no desenvolvimento de IA usando o ROCm.
TraceLens Agent is an agentic workflow that examines GPU traces to deliver a prioritized optimization report, detailing root causes and fixes.
September 29, 2026
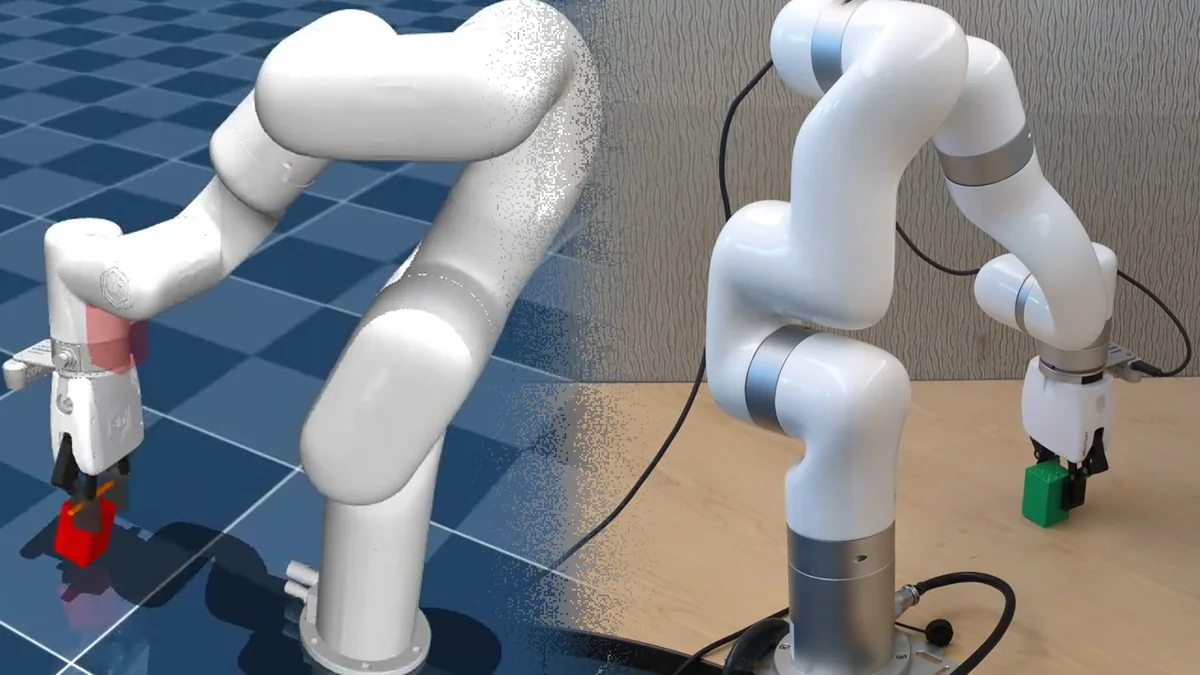
Train an XArm-6 pick-and-lift policy with PPO in MuJoCo Warp on AMD Instinct GPUs, then transfer it to the real robot.
September 28, 2026
Quantize a 35B MoE model directly on AMD Strix Halo with AMD Quark, export to GGUF and safetensors, validate with llama.cpp and vLLM, and deploy throu…
September 24, 2026
Introduce Model Weight Profiles and compare embeddings, attention, and dense layers so checkpoint size and quantization savings make sense.
September 24, 2026
Scale agentic AI at the edge with AMD Ryzen™ AI Embedded X100 Series: more concurrent agents, unified memory, x86 compatibility, and long life.
September 24, 2026
Learn to debug logprob mismatches between rollout and training with Qwen3 examples on AMD Instinct MI355X GPUs.
September 22, 2026
Learn how one declarative madengine command benchmarks day-0 Kimi-K3 across vLLM, SGLang, and ATOM on AMD Instinct MI350X.
September 21, 2026
Upcycle pretrained Transformers into long-context hybrid MLA + linear models on AMD Instinct MI300X GPUs, with 14 open checkpoints and training code.
September 21, 2026

Receba as últimas novidades sobre o ROCm.
©2024 Advanced Micro Devices, Inc. Todos os direitos reservados. AMD, o logotipo de seta AMD, AMD ROCm, AMD Instintic, EPYC, Radeon Instinct e suas combinações são marcas registradas da Advanced Micro Devices, Inc. PyTorch é uma marca comercial ou marca registrada da PyTorch. Outros nomes de produtos usados nesta publicação são apenas para fins de identificação e podem ser marcas comerciais de suas respectivas empresas.