Versal™ AI Core 系列
AMD Versal AI Core 系列運用帶來卓越運算效能的 AI 引擎,提供突破性的 AI 推論和無線加速能力。Versal AI Core 自適應 SoC 具有 Versal 產品組合中最高的運算能力,其應用包括資料中心運算、無線波束成形、視訊與影像處理,以及無線測試設備。

在許多不斷變遷演進的市場(例如 5G 行動通訊、資料中心、汽車和工業),相關應用持續推動著運算加速能力屢創高峰,同時保持能效。不過,隨著摩爾定律和登納德縮放比例定律不再遵循傳統的軌跡,我們無法再像前幾代產品一般,單靠遷移到新一代晶片節點,就能提供更低功耗、更低成本和更高效能的優勢。
AMD 為了因應新一代應用(例如無線波束成形和機器學習推論)的非線性成長需求,已著手開發創新處理技術,即 AI 引擎,作為 AMD Versal™ 架構的一部分。
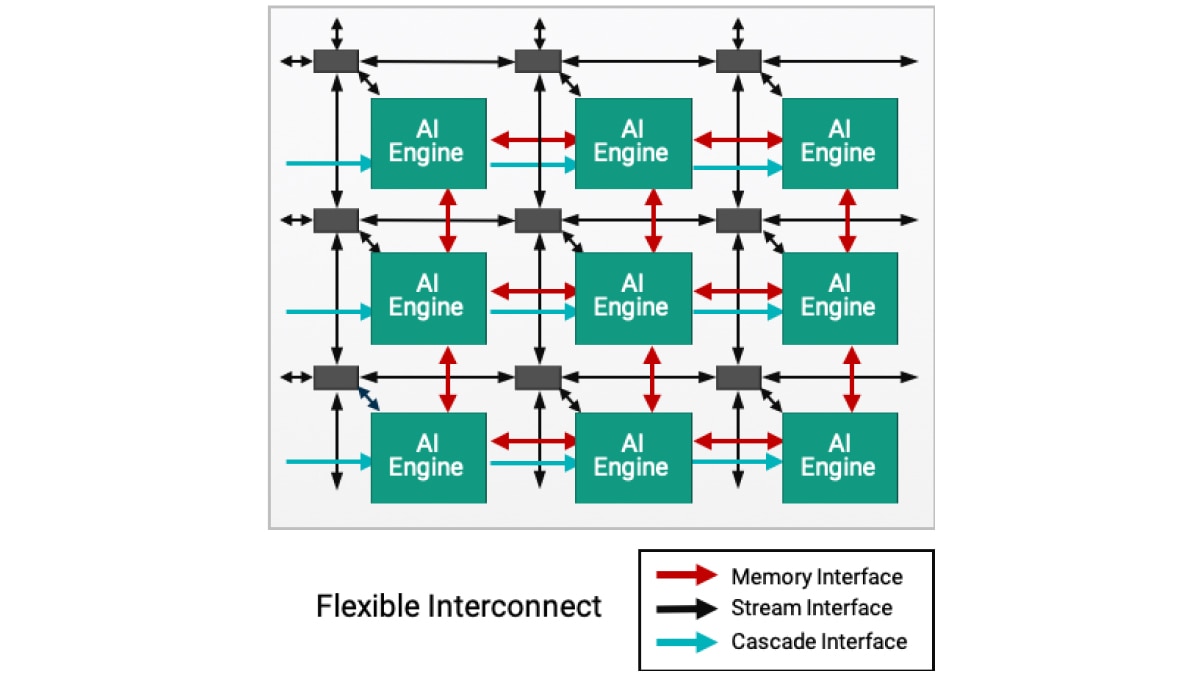
AI 引擎是由多個 AI 引擎磚組建而成的 2D 陣列,由於這樣的解決方案深具可擴充性,因而成就了高低不同級別的 Versal 產品,在單一器件提供數十個到數百個 AI 引擎,以滿足各種應用的運算需求。其優勢包括:
針對高效能 DSP 應用, AI 引擎有以下編碼方法可以選擇(如需詳細資訊,請造訪:AMD Vitis™ AI 引擎 DSP 設計)
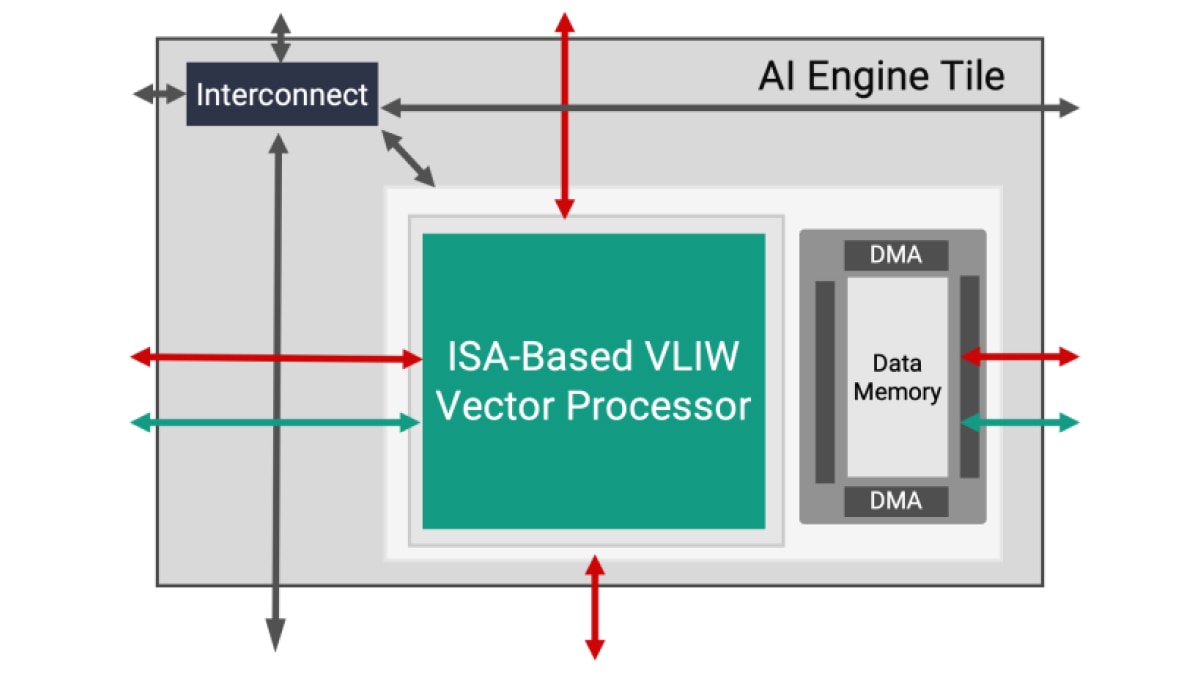
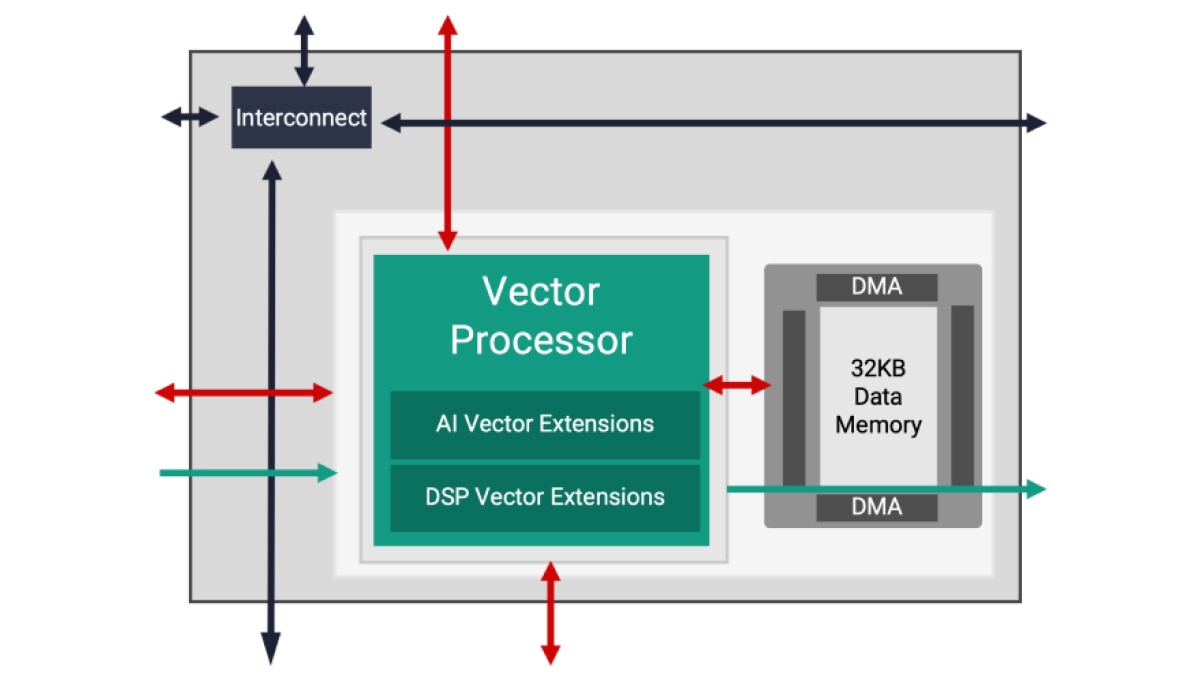
每塊 AI 引擎磚都是由超長指令字 (VLIW)、單一指令多重資料 (SIMD) 向量處理器所組成,且針對機器學習和進階訊號處理應用程式最佳化。AI 引擎處理器最高可執行至 1.3 GHz,實現高效率、高輸送量和低延遲功能。
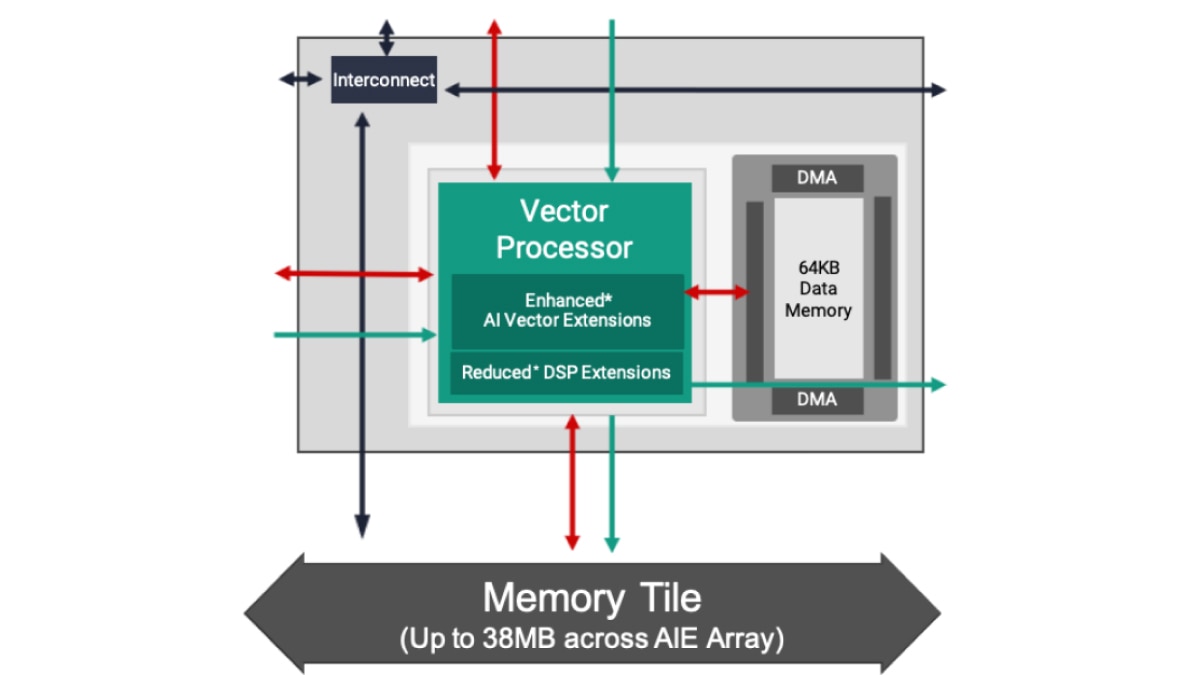
除了 VLIW 向量處理器外,每塊磚都擁有儲存必要指令所需的程式記憶體;用於儲存資料、權重、活化值和係數的本地資料記憶體;以及用於處理不同類型資料通訊的 RISC 純量處理器和不同互連模式。
AMD 提供兩種類型的 AI 引擎:AIE 和 AIE-ML(用於機器學習的 AI 引擎),與上一代 FPGA 相比,兩者效能都獲得顯著改善。AIE 可對各種工作負載提供較為均衡的加速能力,包括 ML 推論應用和高效能 DSP 訊號處理工作負載,如波束成形、雷達和其他需要大量濾波和轉換的工作負載。AIE-ML 透過增強的 AI 向量延伸指令集和導入 AI 引擎陣列中的共用記憶體磚,在 ML 推論應用方面,提供了優於 AIE 的效能,不過 AIE 在部分類型的進階訊號處理方面,其效能則優於 AIE-ML。
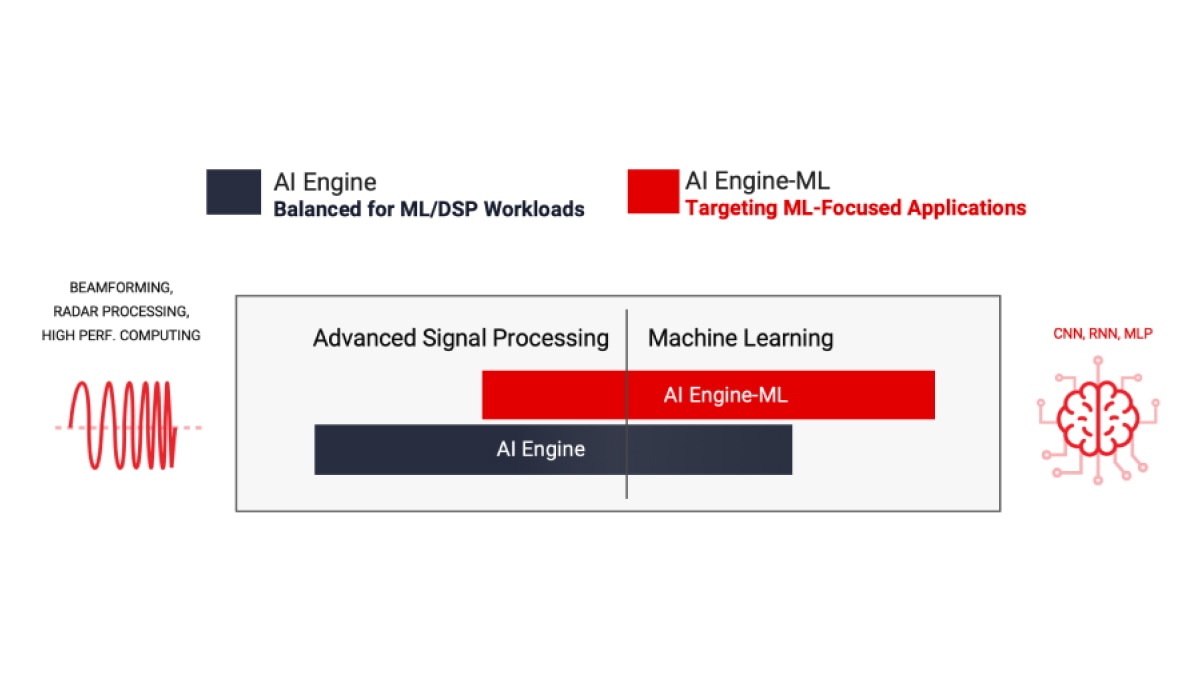
AIE 可對各種工作負載均衡提供加速能力,包括 ML 推論應用和進階訊號處理工作負載,如波束成形、雷達、FFT 和濾波器。
請參閱 AMD Versal AI Engine 架構手冊以瞭解更多資訊。
*BFLOAT16 的實作,使用的是 FP32 向量處理器。
AI 引擎 - ML 架構針對機器學習進行最佳化,增強運算核心和記憶體架構。為了增強以 ML 為中心的應用,這類能處理 ML 和進階訊號的 AI 引擎磚經過最佳化之後,便不再側重對於 INT32 和 CINT32 的支援(常見於雷達處理)。
AIE-ML 將提供兩種版本:運算能力倍於 AIE 的 AIE-ML,以及運算能力再倍於 AIE-ML,且在串流互連之間增加額外頻寬的 AIE-MLv2。
**AIE-ML 對於 FP32 的支援是基於軟體模擬。
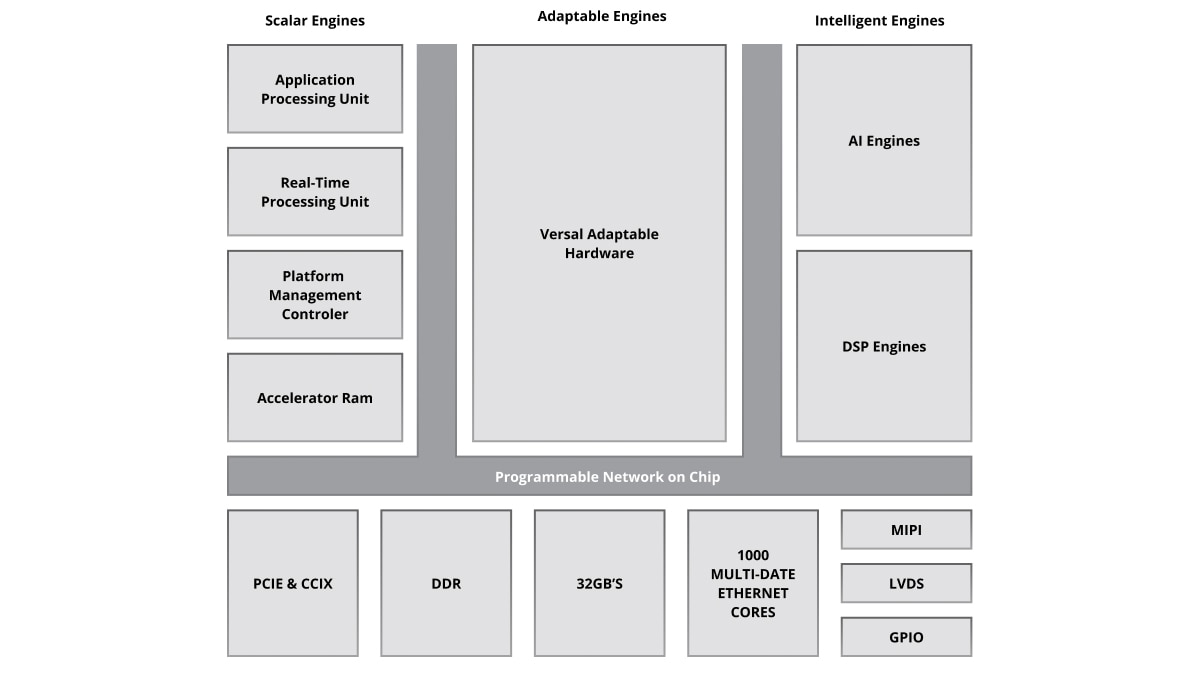
AI 引擎連同可程式化邏輯和處理系統,在 Versal 自適應 SoC 中,形成了緊密整合的異構架構,這套架構可在硬體和軟體層級變更,靈活適應各種應用和工作負載的需求。
以原生軟體可程式化為設計目標全新打造的 Versal 架構,搭載了每秒數兆位元的靈活可程式化晶片上網路 (NoC),以此流暢整合所有元件和關鍵介面,讓平台一啟動即可使用,軟體開發人員、資料科學家和硬體開發人員,都能輕鬆進行程式設計。
從無線處理到在雲端、網路和邊緣的機器學習,適合異構工作負載的 AI 引擎
資料中心運算
影像和視訊分析是資料中心處理資料量暴增的主因。這些工作負載的卷積神經網路 (convolutional neural network, CNN) 性質需要大量運算,通常達到每秒數萬億次 (teraOPS)。AI 引擎經過最佳化,可採取符合成本效益和具備能效的方式,提供這種運算密度。
5G 無線處理
5G 可在極低延遲下,提供前所未有的輸送量,因此訊號處理必然大幅增加。AI 引擎可在無線電單元 (RU) 和分散式單元 (DU) 中,以較低功率執行這種即時訊號處理,例如運用 Massive MIMO 面板使用的精密波束形成技術,以增加網路頻寬。
ADAS 與自動駕駛
CNN 是一種深層前饋人工神經網路,最常用於視覺影像分析。隨著電腦普遍用於從自駕車到視訊監控等各種應用,CNN 已成為不可或缺的技術。AI 引擎可針對散熱條件有限的小巧外型規格,提供必要的運算密度和效率。
航太與國防
將功能強大的向量型 DSP 引擎與 AI 引擎合為一體,以小巧外型規格實現航太與國防 (A&D) 領域的多種系統,包括相位陣列雷達、早期預警 (EW)、MILCOM 和無人駕駛載具。AI 引擎支援多任務酬載的訊號處理、訊號調節和 AI 推論等異構工作負載,據此提供運算效率,以滿足這些關鍵任務系統在大小、重量和功率 (SWaP) 方面的嚴格要求。
工業
包括機器人和機器視覺在內的工業應用,都要結合感測器融合與 AI/ML,以利在邊緣和資訊來源附近執行資料處理。儘管環境存在不確定性,AI 引擎仍可提高這類即時系統的效能和可靠性。
無線測試設備
即時 DSP 廣泛用於無線通訊測試設備。AI 引擎架構很適合處理所有類型的通訊協定實作,包括從數位前端到波束成形和基頻的 5G 作業。
醫療保健
利用 AI 引擎的醫療保健應用,包括醫療超音波的高效能平行處理波束成形器、CT 掃描儀的反向投影、MRI 儀器的影像重建卸載,以及各種臨床和診斷應用的輔助診斷。
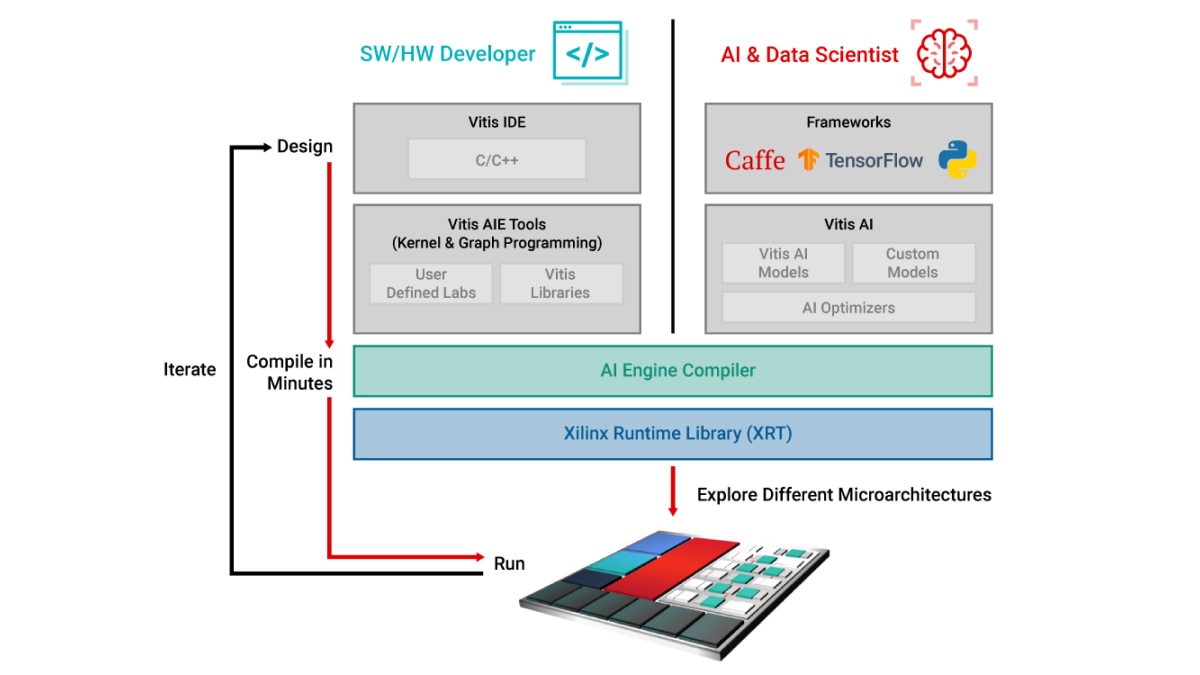
AI 引擎是以軟體可程式化及硬體適應力為設計目標打造而成。開發人員可透過兩種截然不同的設計流程,在幾分鐘內完成編譯,並快速探索不同的微架構,徹底釋放這些運算引擎的效能。這兩種設計流程包括:
AI 引擎陣列還可透過最佳化資源和功耗的方式,實現高效能 DSP 功能。將 AI 引擎與 FPGA 結構資源結合使用,可以非常有效率地實作高效能 DSP 應用程式。瞭解如何使用 AMD Vitis 工具流程,針對 DSP 應用釋放 AI 引擎的硬體加速能力:AMD Vitis AI 引擎 DSP 設計
AMD 透過 Vitis 加速庫,提供預先建構的核心,進而:
軟體和硬體開發人員直接設計以向量處理器為基礎的 AI 引擎程式,並在情況適當時,以 C/C++ 程式碼呼叫預先建置程式庫。
AI 資料科學家可以留在熟悉的架構環境,例如 PyTorch 或 TensorFlow,並透過 Vitis AI 呼叫預先建置的 ML 疊層,無需直接對 AI 引擎進行程式設計。
這些程式庫均屬開源程式庫,可從 GitHub 取得:https://github.com/Xilinx/Vitis_Libraries。
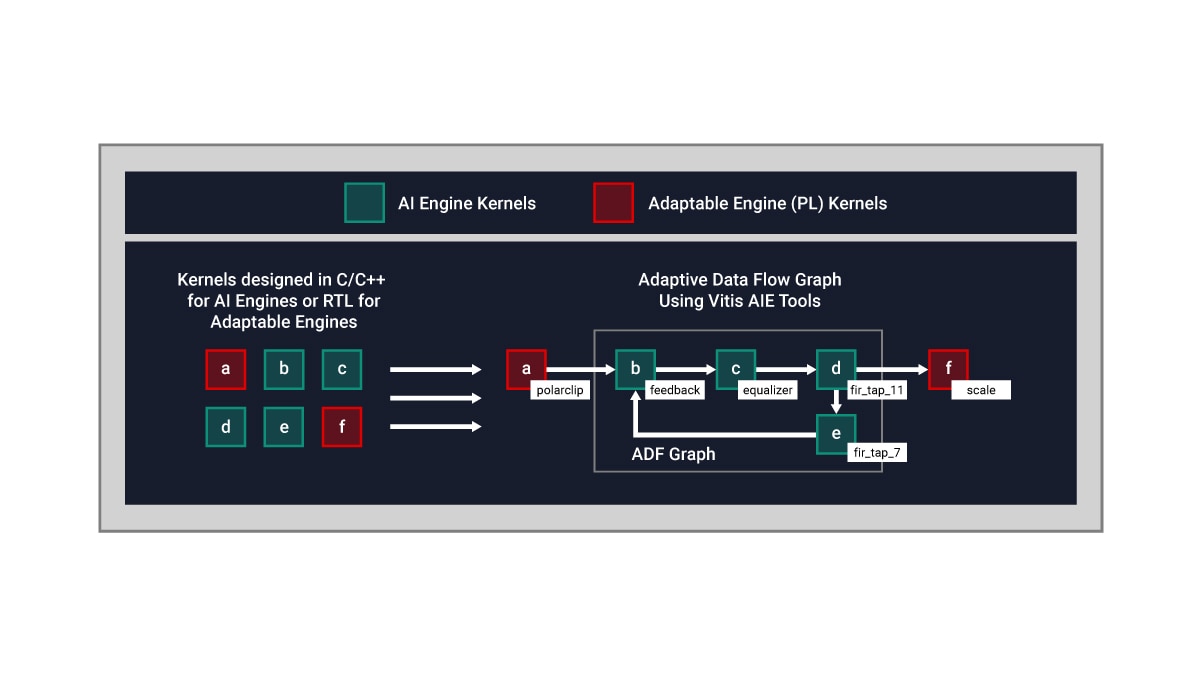
AI 引擎架構以資料流技術為基礎。處理元素採用 10 到 100 磚的陣列,可在多個運算單元中建立單一程式。對於設計人員來說,欲嵌入指令以指定這些磚之間的平行處理能力,可謂冗長乏味且幾近不可能。為了克服此一難題,AI 引擎設計於是分為兩個階段執行:首先開發單一內核,然後建立自適應資料流 (ADF) 圖形,將多個內核連接成一個整體應用程式。
Vitis 統一 IDE 提供單一 IDE 儀錶板,支援使用 C/C++ 程式碼和 ADF 圖設計開發 AI 引擎內核。具體而言,設計人員可以:
在預設情況下,單一內核會在單一 AI 引擎磚上執行。但是,多個內核可以在同一 AI 引擎磚上執行,在應用程式允許的範圍內共用處理時間。
概念範例如下所示:
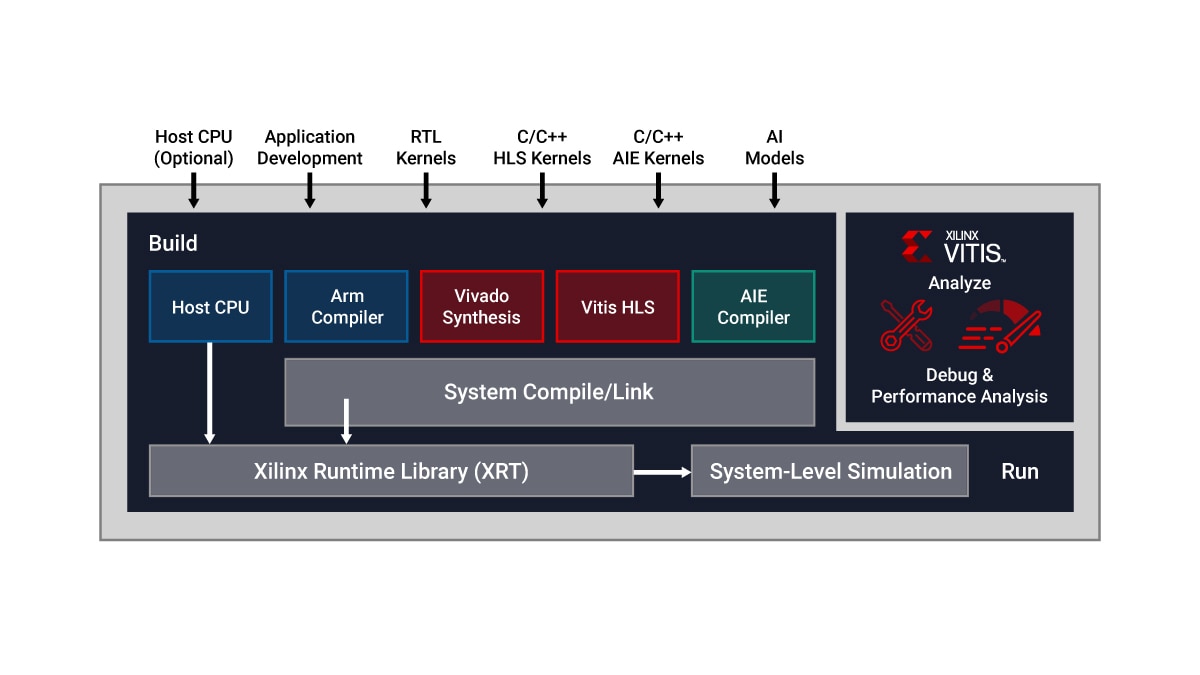
在 Vitis 統一 IDE 中,AI 引擎設計可以放入更大的完整系統中,將所有設計層面合併成一個整合流程,以進行模擬、硬體模擬、除錯和部署。
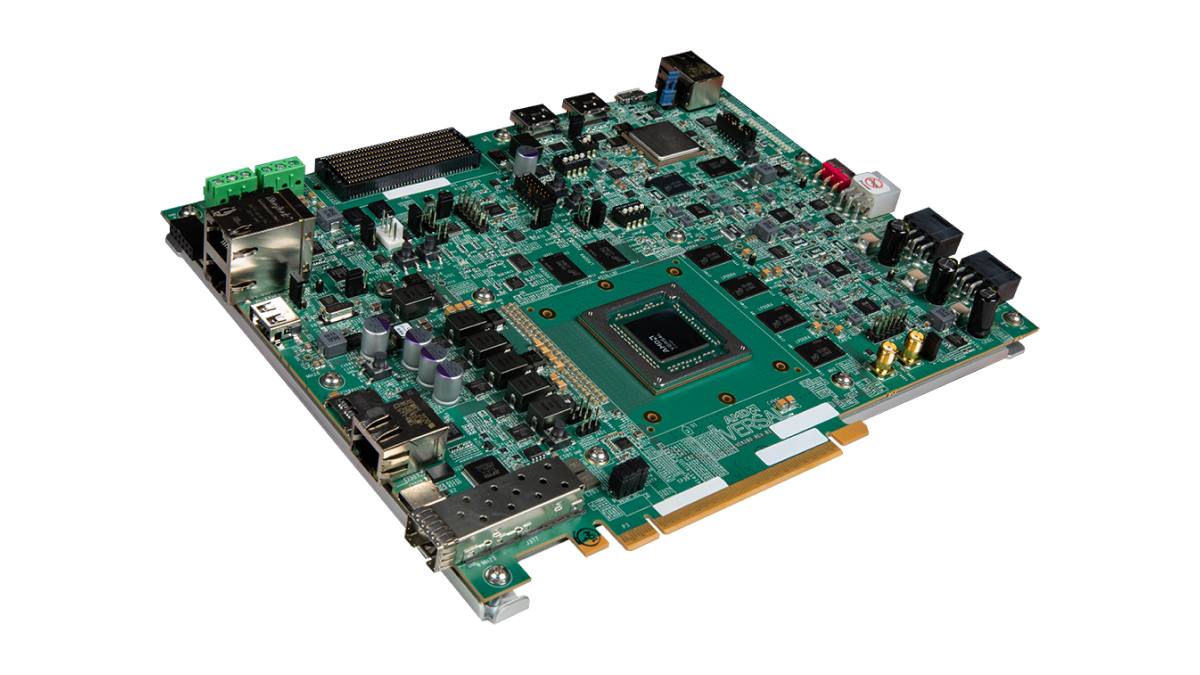
VEK280 評估套件配備 Versal AI Edge VE2802 自適應 SoC,提供 AIE-ML 和 DSP 硬體加速引擎,以及多種高速連線能力選項。此套件針對汽車、視覺、航太和國防、工業、科學和醫療等市場的 ML 推論應用進行最佳化。
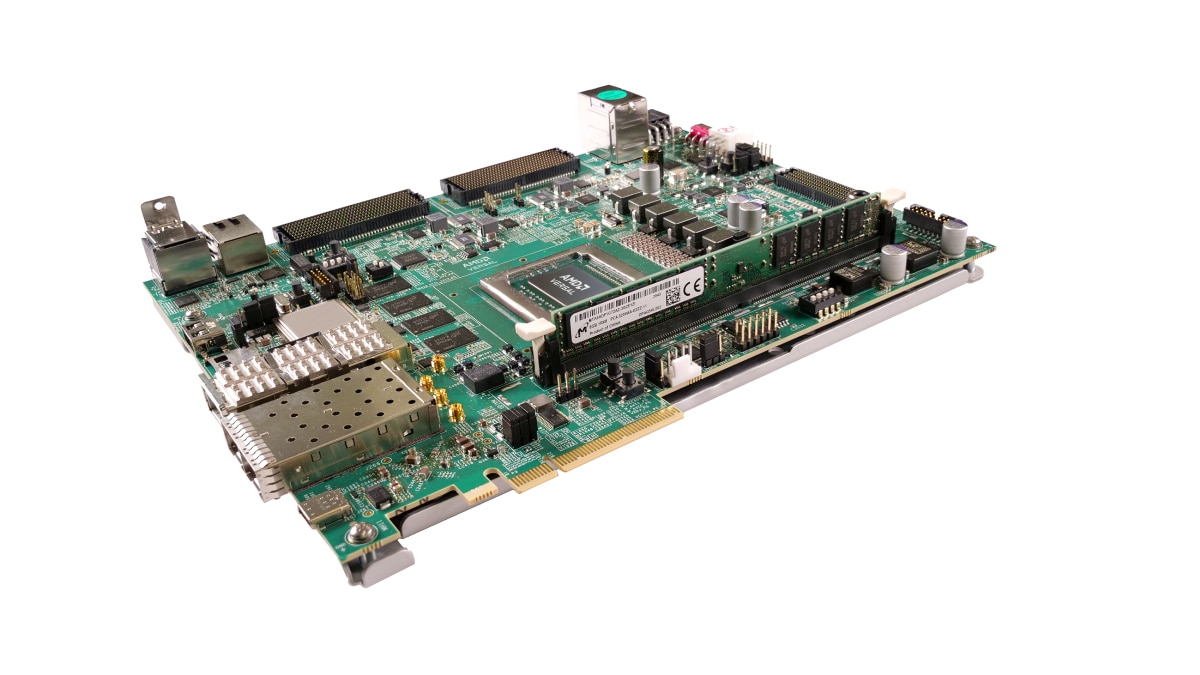
VCK190 評估套件讓設計人員可以使用 AI 和 DSP 引擎開發解決方案,這些引擎能夠提供比當前伺服器級處理器高 100 倍以上的運算效能。Versal AI Core 系列 VC1902 器件提供各式各樣的連線選項和標準化開發流程,為雲端、網路和邊緣應用,提供 Versal 產品組合最高的 AI 推論和訊號處理輸送量。
AMD Vitis 統一軟體平台提供了使用硬體加速技術的全方位核心開發套件和程式庫。
造訪 Vitis GitHub 和 AI 引擎開發儲存庫,存取各種 AI 引擎教學課程,並瞭解更多關於技術功能和設計方法的資訊。
編譯器和模擬器,這兩款 AI 引擎工具都已整合在 Vitis IDE 中,並需要額外專屬授權。有關如何取得 AI 引擎工具和授權的更多資訊,請聯絡您當地的 AMD 銷售代表,或前往填寫銷售人員聯絡表單。
AMD Vitis 模型編輯器是以模型為基礎的設計工具,可在 Simulink® 和 MATLAB® 環境中快速進行設計探索。此工具在系統層級促進 AI 引擎 ADF 圖的開發和測試,讓使用者可將 RTL 和 HLS 區塊,以及 AI 引擎內核和/或圖都納入同一模擬中。透過運用 Simulink 和 MATLAB 工具的訊號生成和視覺化功能,DSP 工程師可在熟悉的環境中進行設計和除錯。要瞭解 Versal AI Engine 如何搭配 Vitis 模型編輯器使用,請造訪 AI 引擎資源頁面。
VCK190 套件以 Versal AI Core 系列為基礎,讓設計人員能使用 AI 引擎和 DSP 引擎開發解決方案。此評估套件提供您立即展開設計所需的一切。
此外,我們還提供以 PCIe® 為基礎的 VCK5000 開發卡,此卡搭載的是含 AI 引擎的 Versal AI Core 器件,專為資料中心的高輸送量 AI 推論所打造。
關於 AIE-ML 開發,想探索 DSP 和 ML 應用的開發人員,則可參考以 Versal AI Edge 系列為基礎的 VEK280 評估套件。
AMD 訓練與學習資源提供您必備實務技能與基本知識,讓您在下一個 Versal 自適應 SoC 開發專案中,充分發揮生產力。課程包括:
AMD 從解決方案規劃到系統整合和驗證領域,針對眾多 Versal 自適應 SoC 文件,提供量身打造的檢索介面,力求大幅提升使用者的設計工作效率。造訪 Versal 自適應 SoC 設計實現中心,以取得符合設計需求的最新內容,並探索 AI 引擎功能和設計方法。
加入自適應 SoC 和 FPGA 通知清單,以接收最新消息與更新。