运行云端智能体?最重要的升级可能是一颗 AMD “Zen 5” CPU
Jul 16, 2026
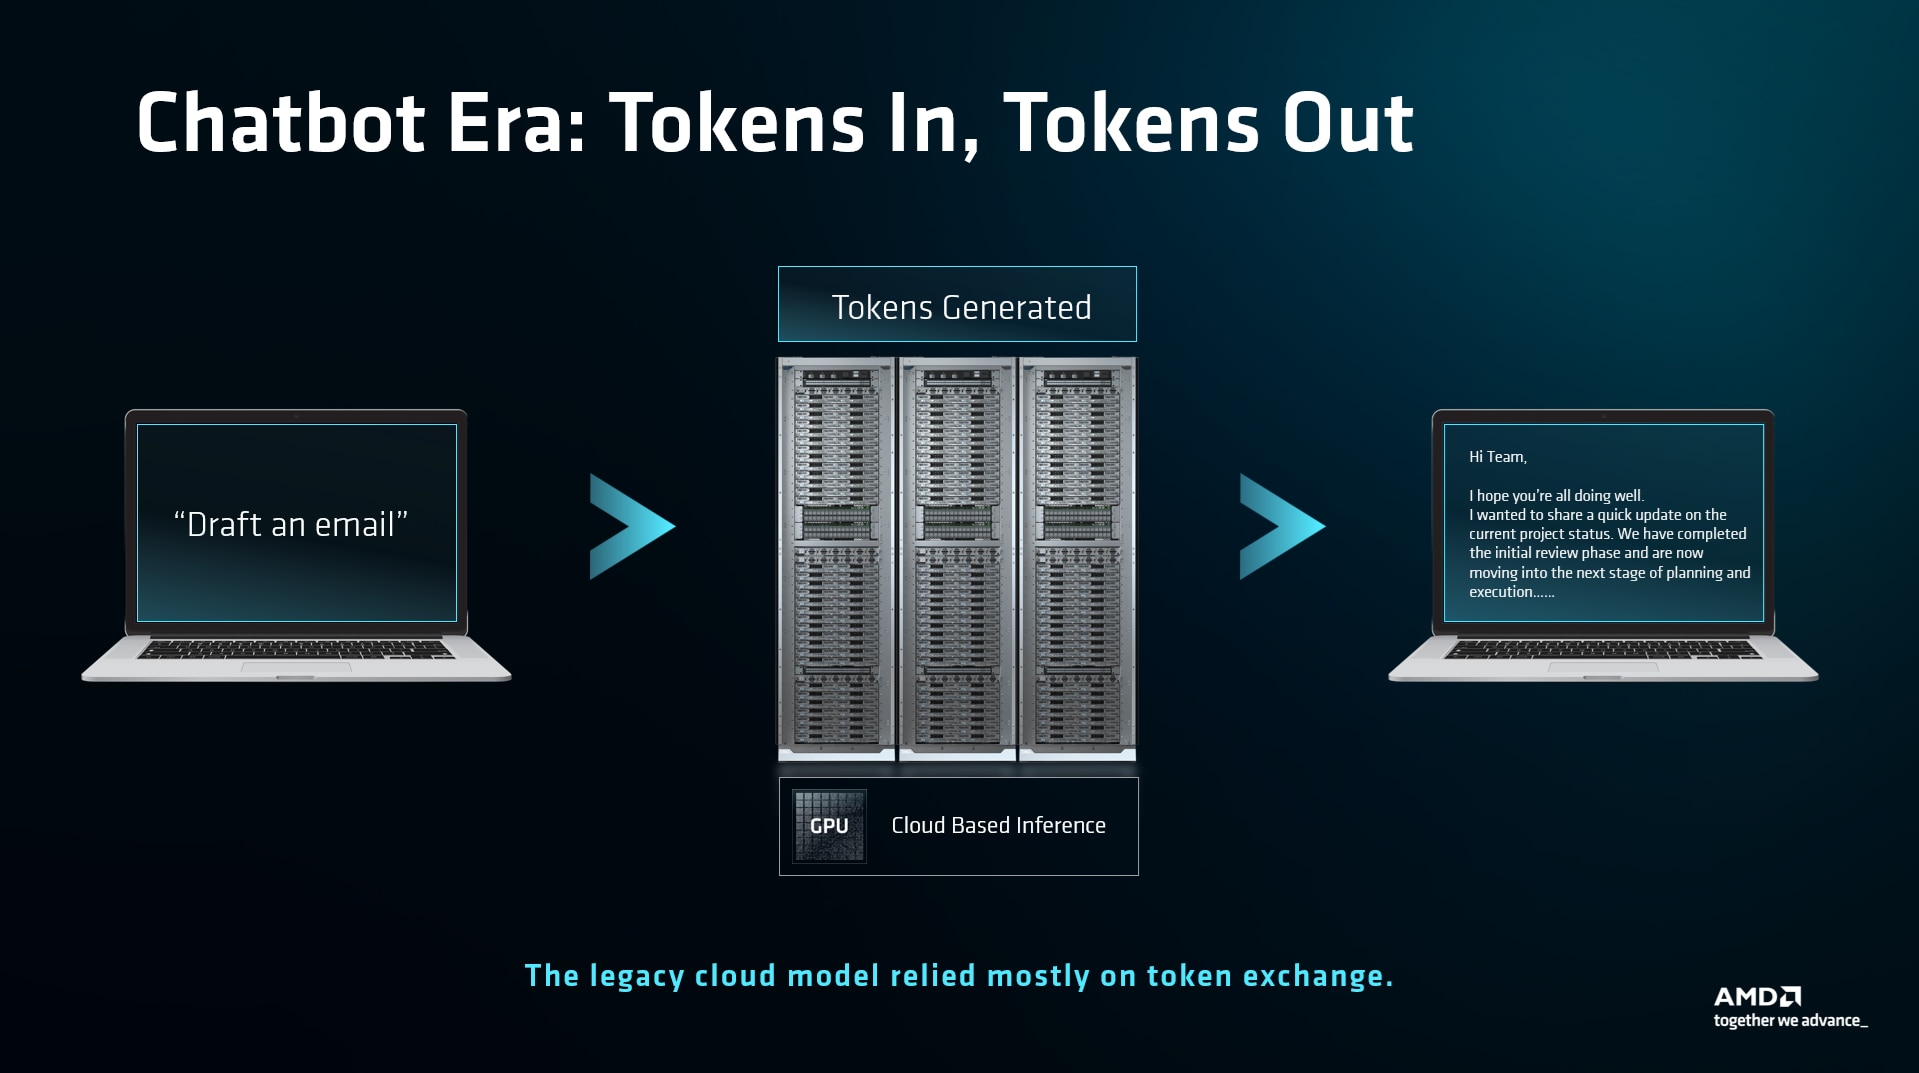
在第一波生成式 AI 浪潮中,交互模式很简单:输入 Token,输出 Token。用户输入提示,模型进行处理,响应随即显示在屏幕上。大部分可见工作发生在推理阶段,而且通常由云端 GPU 完成。
这种模式正在发生变化。
AI 智能体可以读取文件、执行代码、使用客户端应用、调用工具并完成多步骤任务。在这个新时代,推理仍然重要,但生成 Token 只是第一步。新的模式是:输入 Token,输出行动。
从回答问题到完成任务
试想一下,询问 AI 助手如何报税与让智能体协助报税有何不同。前者主要是语言问题,后者则可能需要智能体打开文档、提取数据、执行计算、与软件交互并验证结果。
这会形成一个持续循环:模型决定下一步做什么,智能体调用工具,客户端 CPU 执行操作,然后将结果发送回模型。
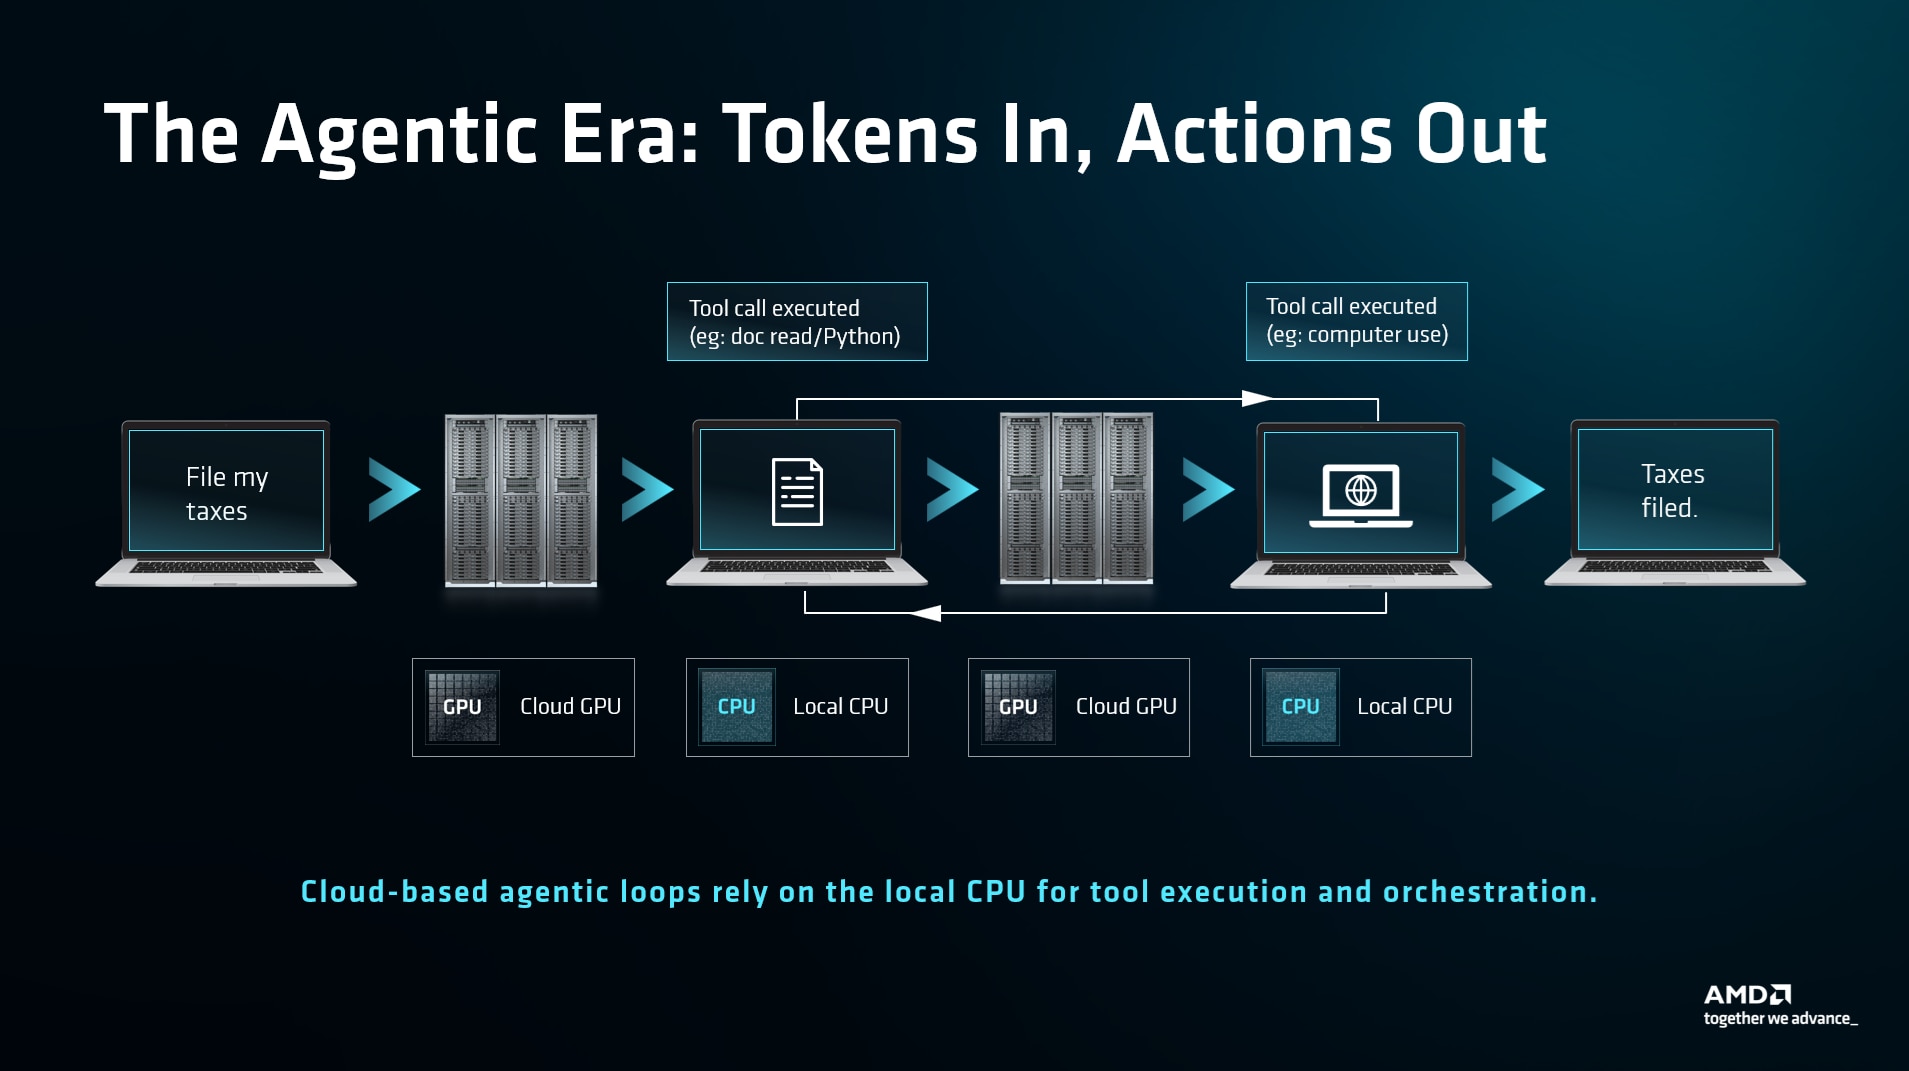
其中许多操作都在用户的计算机上进行。读取本地文件、运行 Python、编译代码、搜索项目目录和控制应用程序,都高度依赖客户端系统。
因此,智能体性能不再仅由模型生成 Token 的速度决定,还取决于计算机将这些 Token 转化为有用工作的速度。
本地 CPU 将 Token 转化为行动
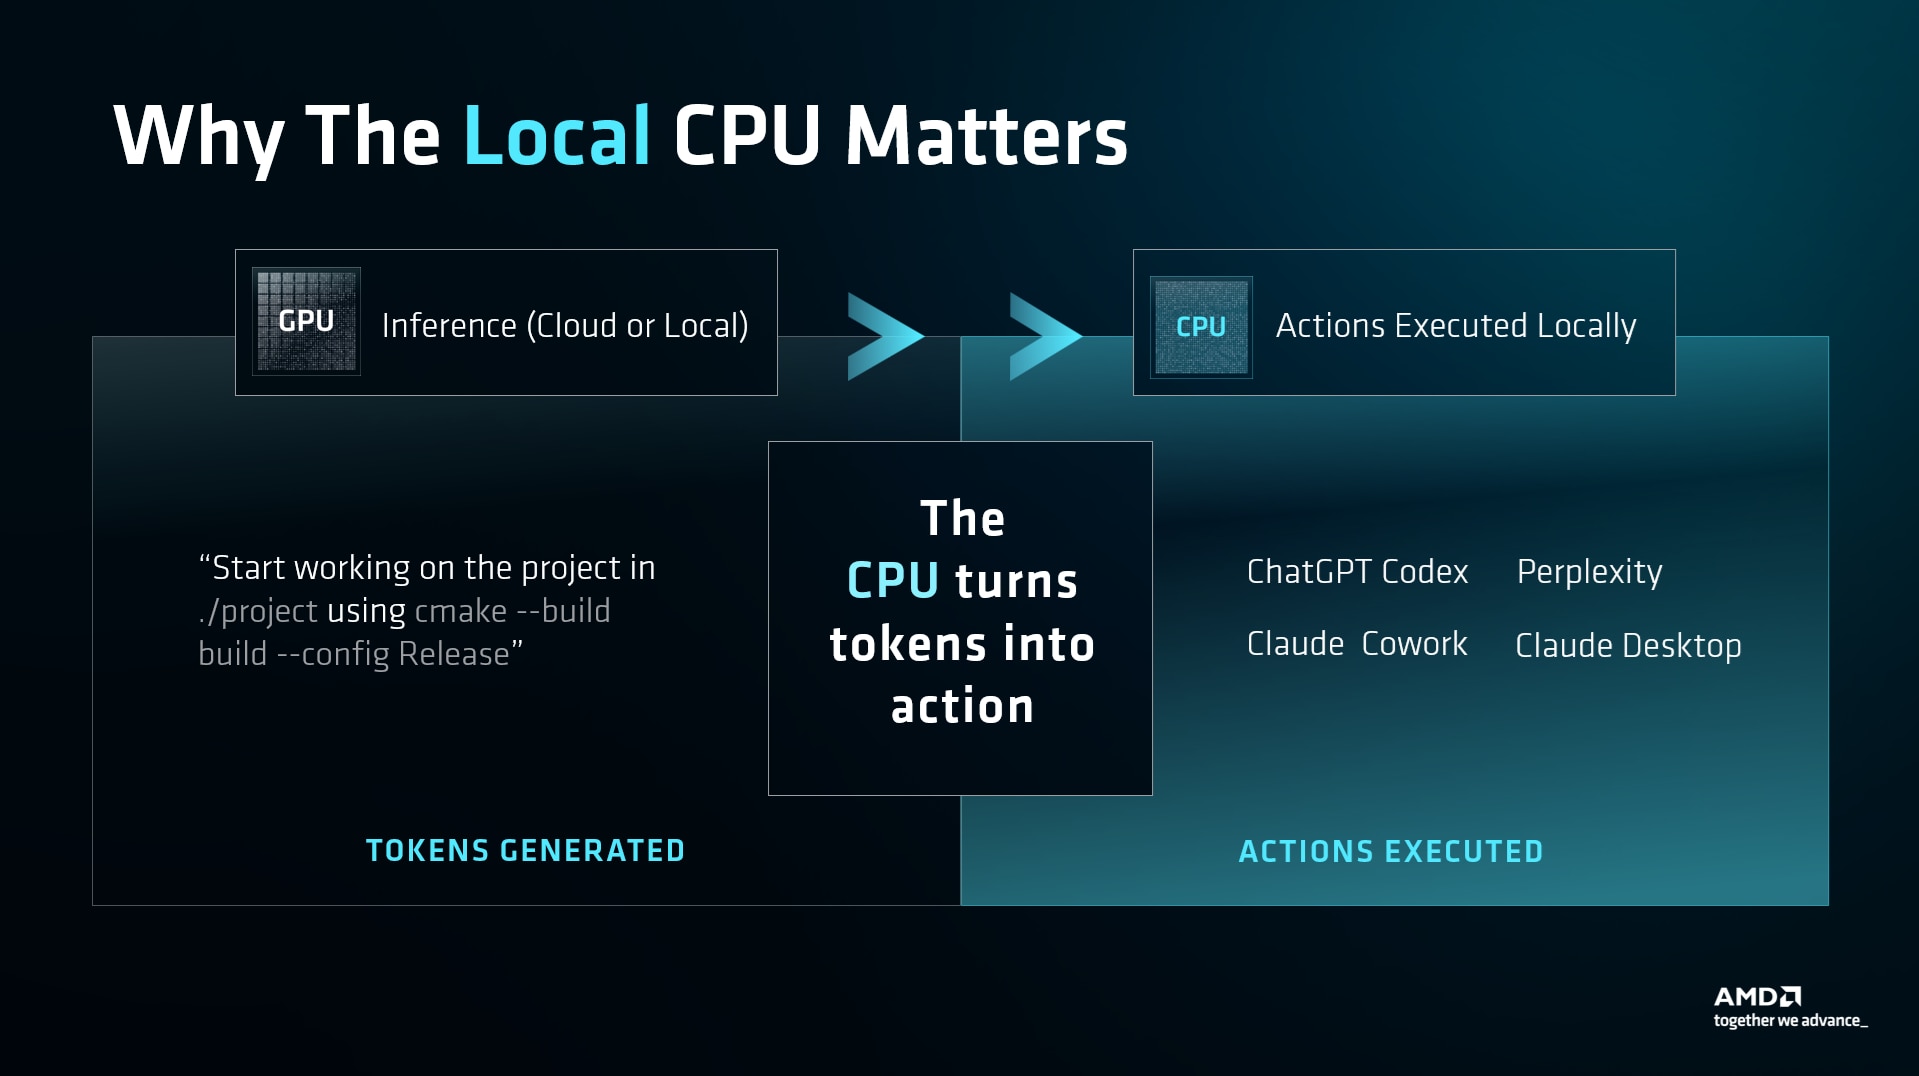
推理决定下一步的操作,CPU 则协助执行。当智能体启动进程、解析文件、运行命令或协调多个工作线程时,大量执行和调度工作由 CPU 负责。即使 AI 推理在 GPU 或 NPU 上运行,CPU 仍负责推动更广泛的工作流持续运转。
随着智能体承担更大规模的任务,这一点变得更加重要。聊天机器人可能只生成一次响应,而智能体在完成一个请求之前可能需要执行数十项操作。更先进的系统还可以并行启动多个子智能体,让它们同时读取文件、运行命令并处理结果。
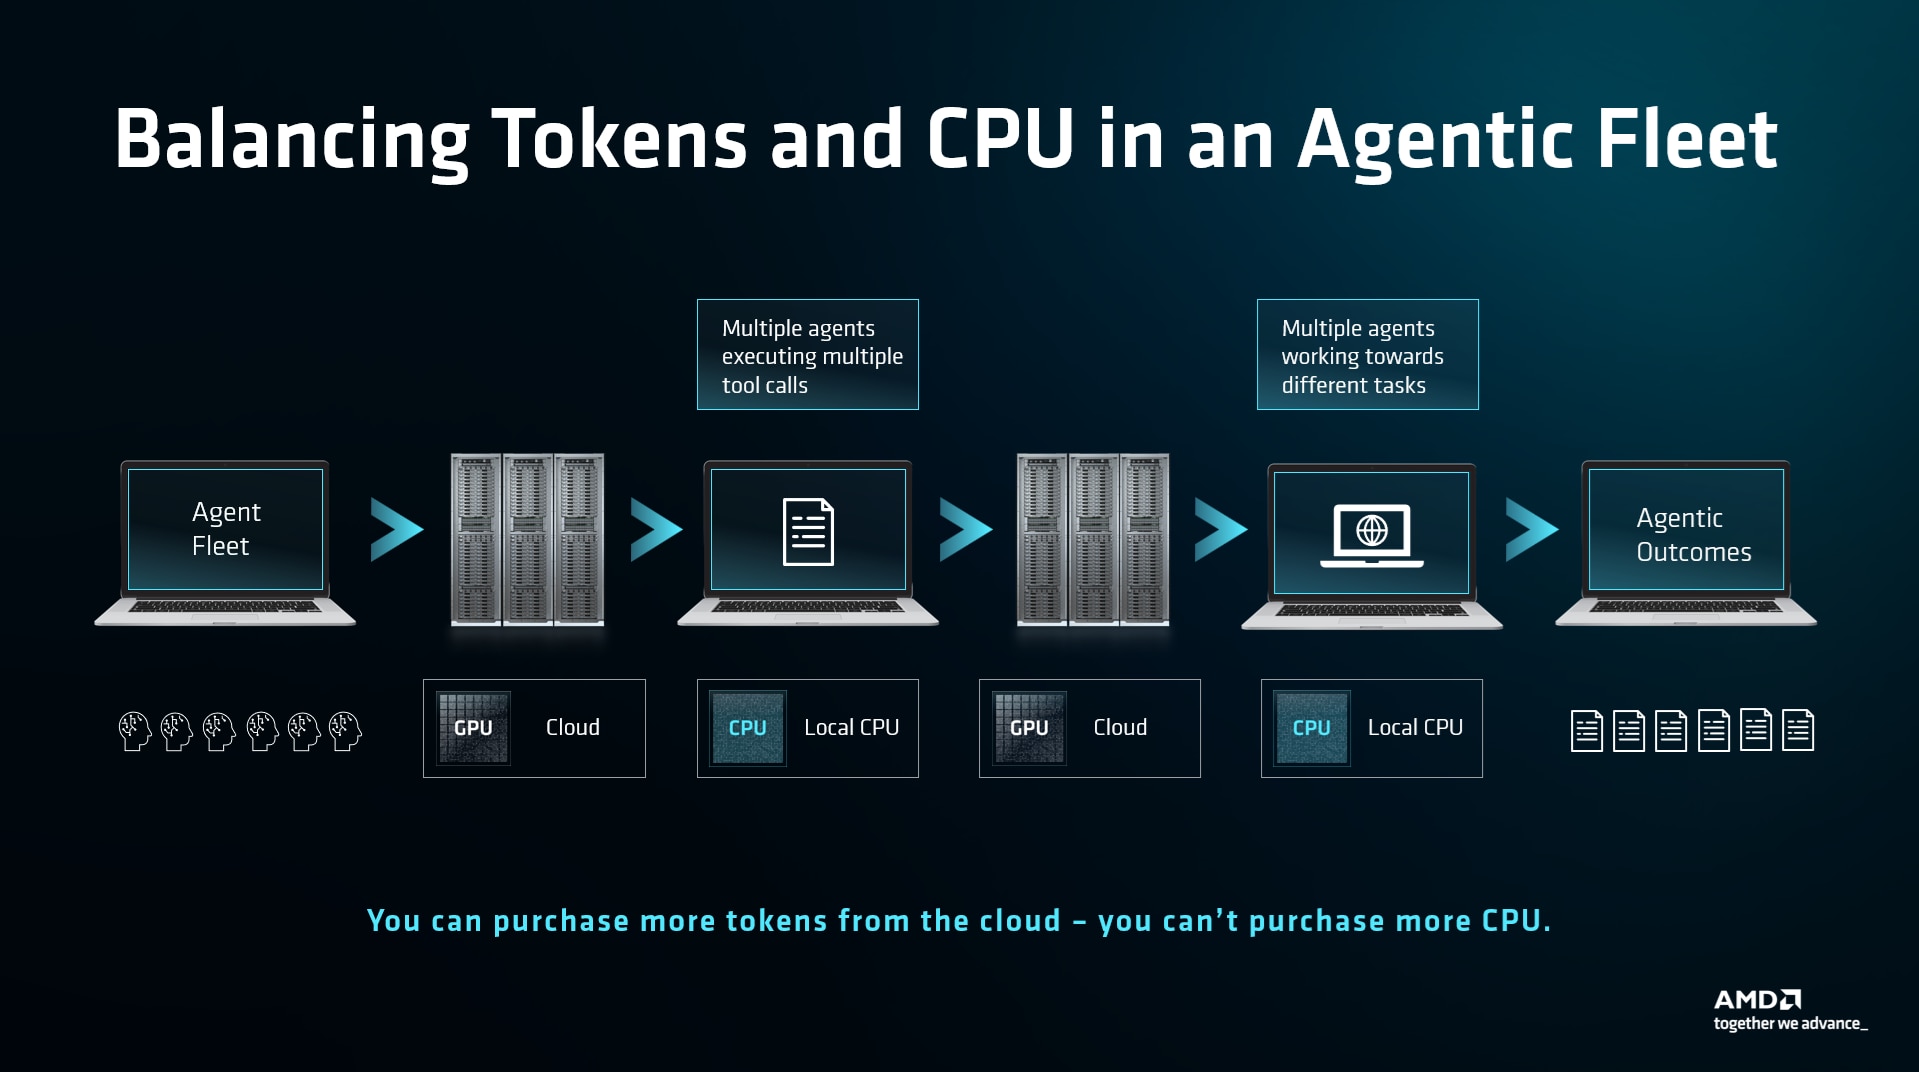
在这些工作负载中,CPU 性能会直接影响工具执行、编译、本地数据处理、应用响应能力和任务总完成时间。如果每项操作都在等待客户端,再快的模型也无法充分发挥价值。
专为智能体工作负载而打造
随着模型速度提升、 Token 效率提高,本地执行速度在整个 AI 工作负载中的占比可能越来越高。
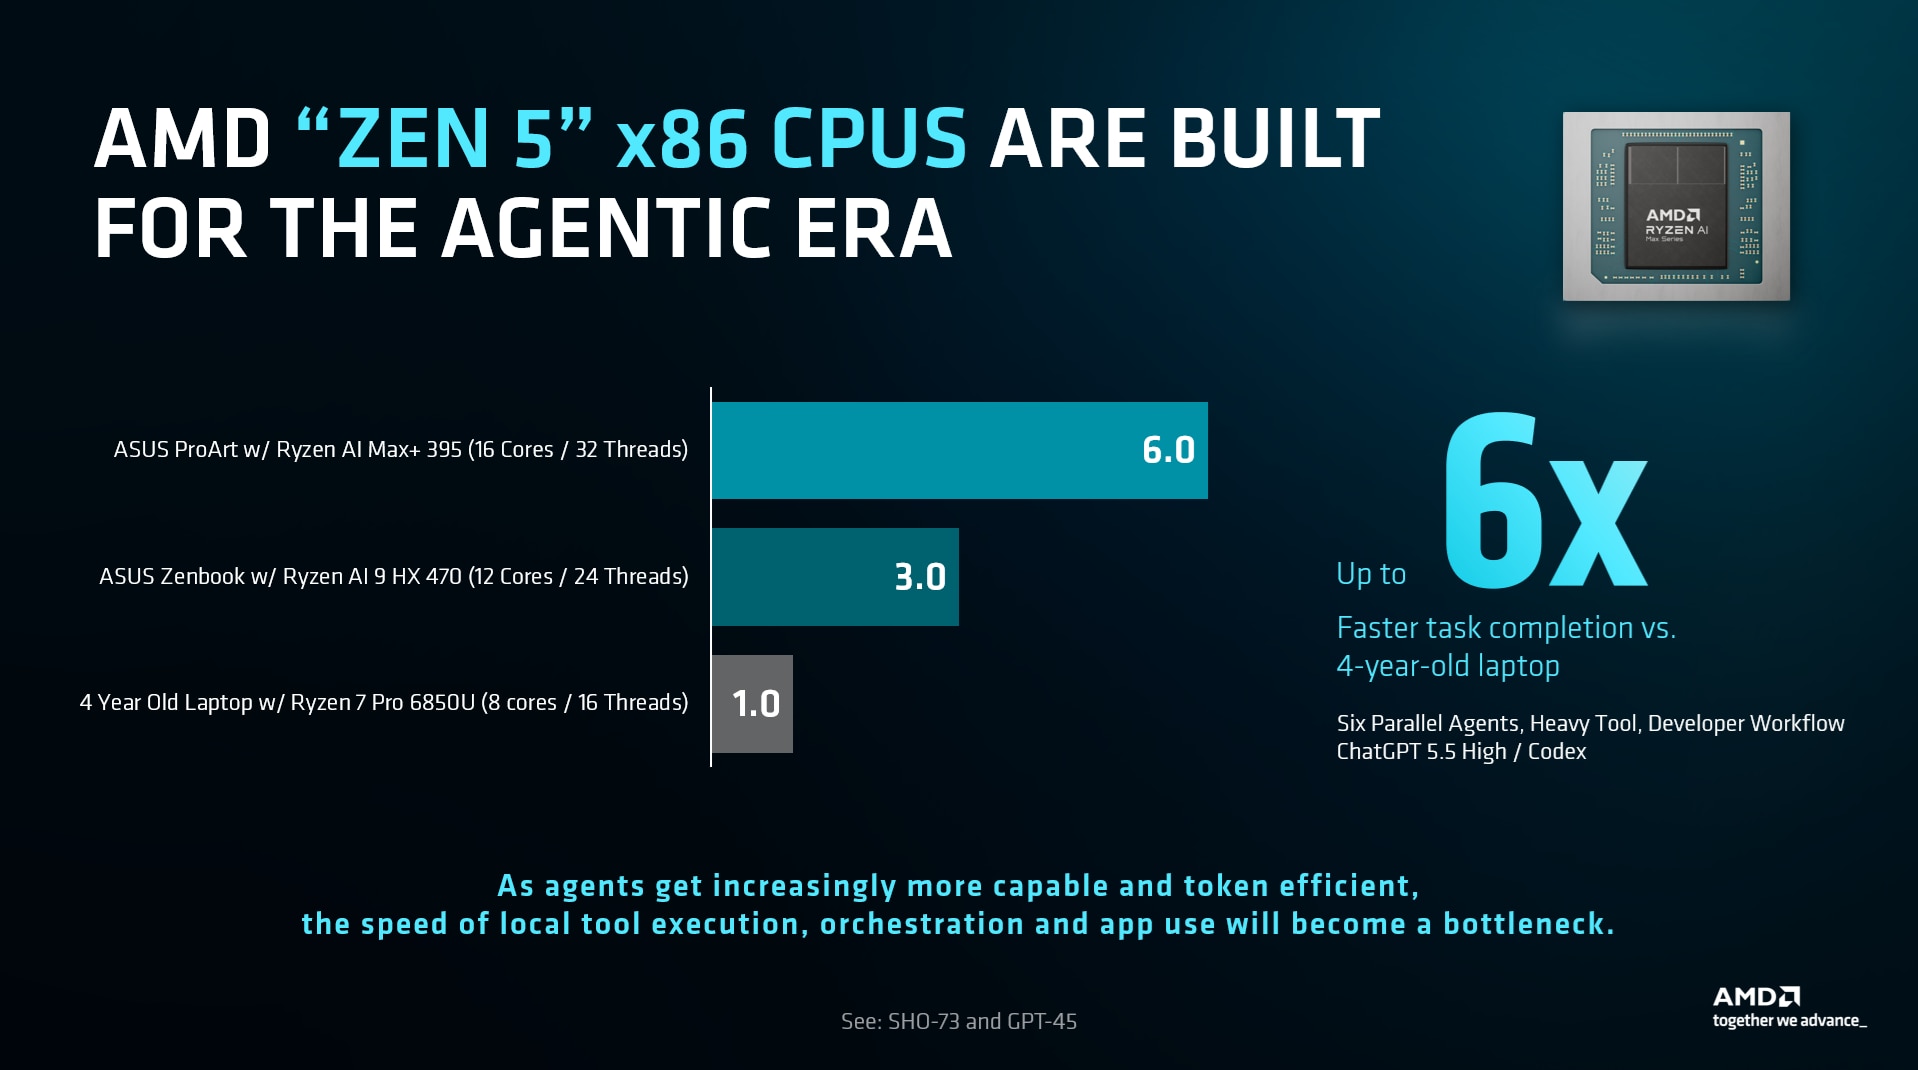
这一点已经可以通过一个重工具调用的 Codex 开发者工作流得到验证,该工作流同时运行六个 ChatGPT 5.5 High 智能体。在测试框架中,每个智能体通过基于 Python 实现的测试框架完成多项任务,包括 AST 与静态分析、编译和导入冒烟测试、单元式执行、JSON 与 CSV 序列化、SQLite 查询、压缩与哈希、软件包和清单操作,以及其他混合型本地工具工作负载。
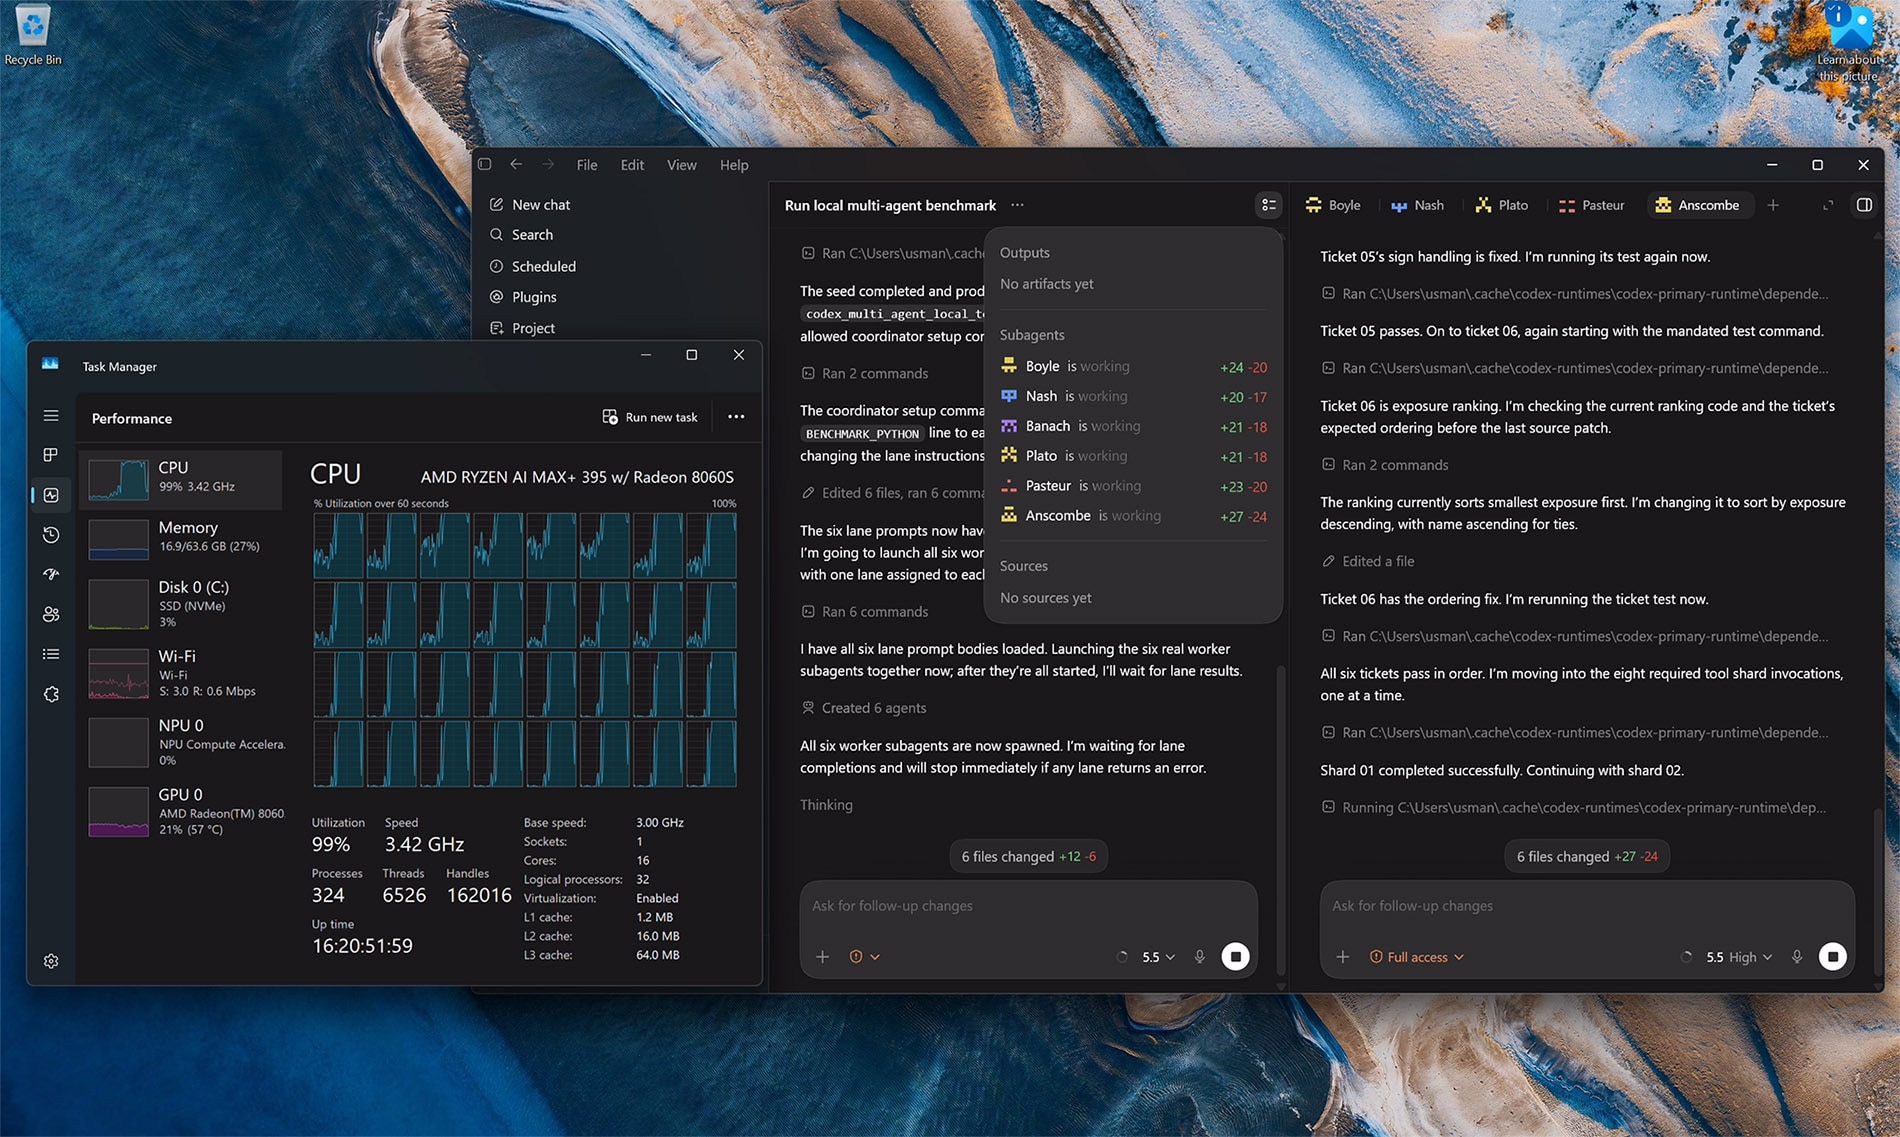
在这一多智能体、重度开发者 CODEX 工作流中,搭载 AMD 锐龙AI Max+ 处理器的 ASUS ProArt 系统所提供的 CPU 吞吐量最高可达四年前笔记本电脑的 6 倍。这一结果凸显了一项重要转变:随着智能体在本地文件、应用和开发者工具中执行更多工作,CPU 性能会直接影响整体任务的完成速度。
结论非常明确
云端 GPU 可以运行规模最大的模型,本地 GPU 和 NPU 可以加速兼顾隐私与响应速度的推理,但在这两种情况下,真正为智能体执行操作提供运行环境的是 CPU。
无论智能体在哪里运行,智能体 AI 都会提升 CPU 的重要性。无论是在客户端 PC 还是数据中心运行,CPU 都提供将模型输出转化为现实世界行动的执行环境。AMD 锐龙 AI 和 AMD EPYC 在这一连续体系中各自发挥互补作用。
归根结底,衡量 AI 智能体最有意义的指标,不是它生成 Token 的速度,而是它最终完成任务的速度。网络条件和云端推理速度始终会影响体验;但一旦智能体开始读取文件、运行代码、使用应用并协调工具,本地执行就会成为总体完成时间的关键组成部分。在智能体时代,客户端 CPU 有助于决定智能转化为有用工作的速度。
附注
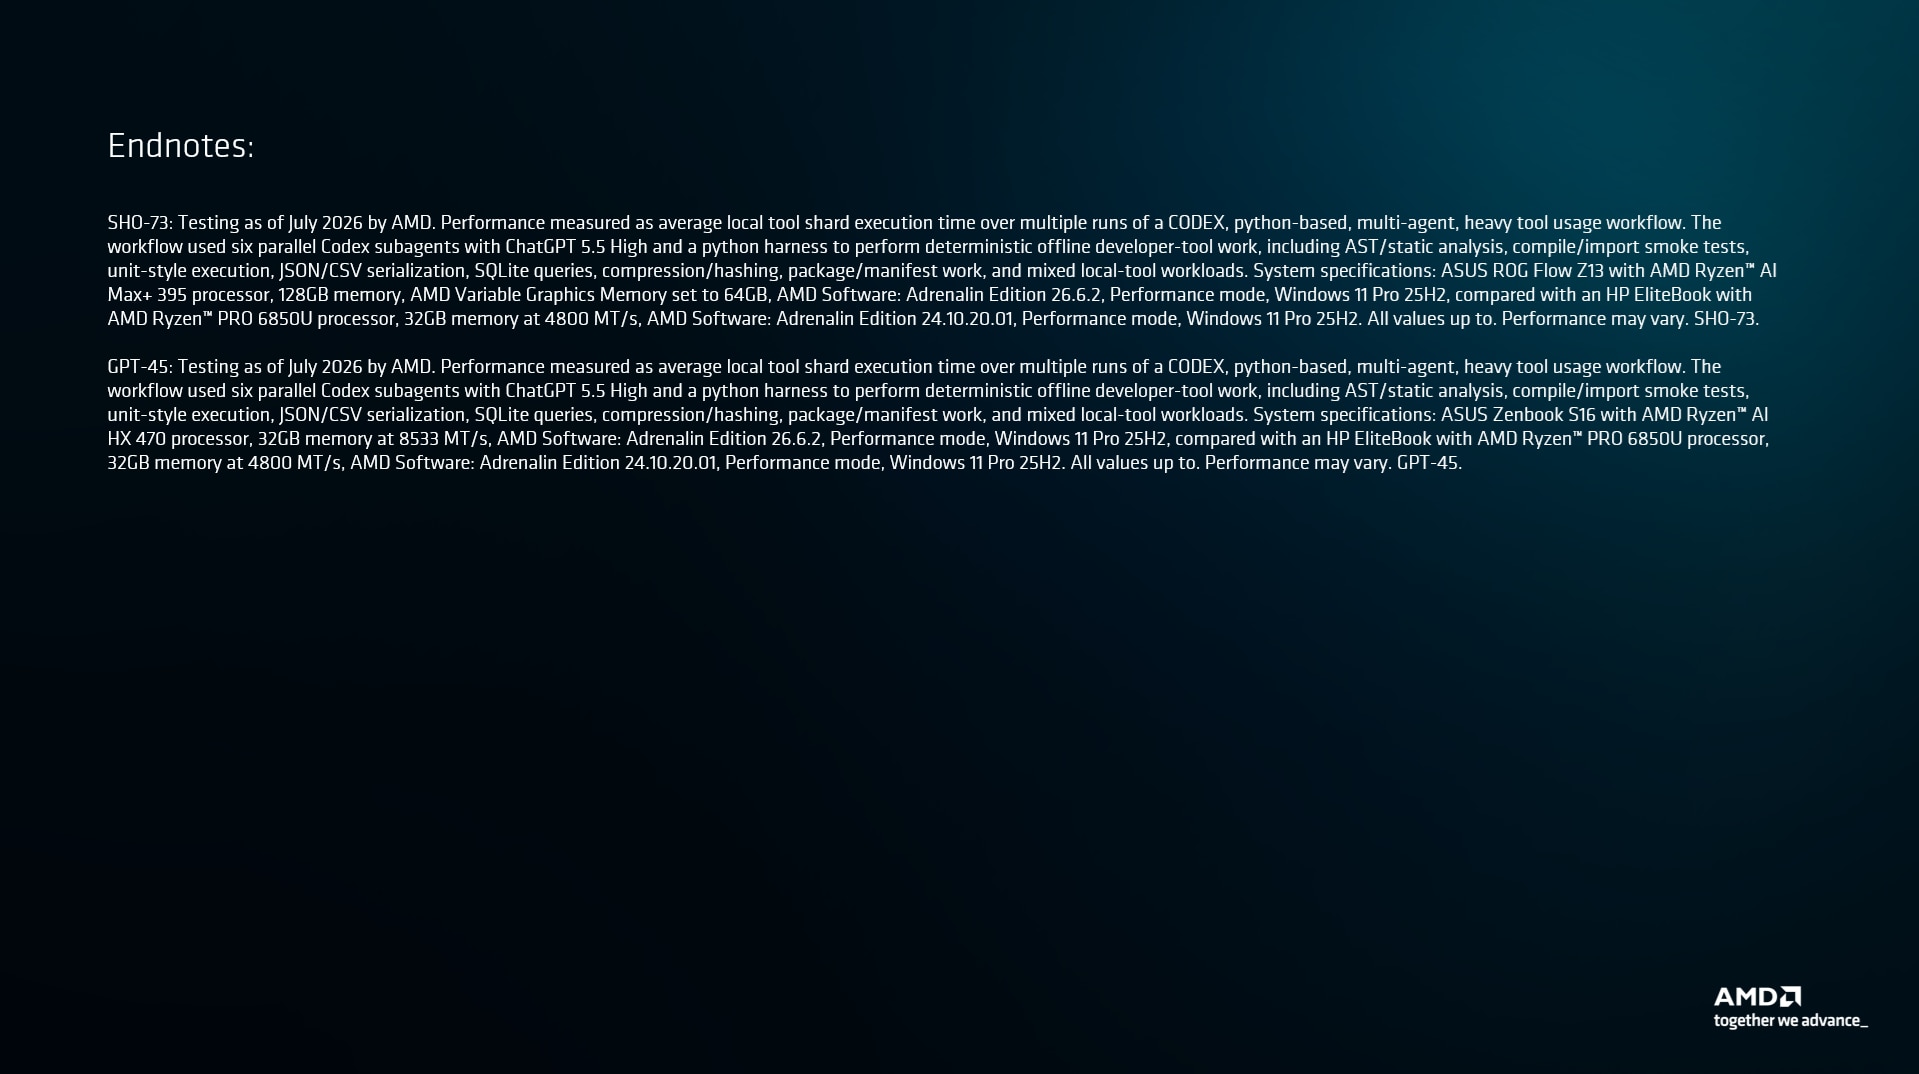
SH0-73:AMD 于 2026 年 7 月开展测试。性能以基于 CODEX 和 Python 的多智能体、重工具使用工作流在多次运行中的平均本地工具分片执行时间衡量。该工作流使用六个并行 Codex 子智能体、ChatGPT 5.5 High 和 Python 测试框架执行确定性的离线开发者工具任务,包括 AST/静态分析、编译/导入冒烟测试、单元式执行、JSON/CSV 序列化、SQLite 查询、压缩/哈希、软件包/清单操作及混合本地工具工作负载。系统配置:搭载 AMD 锐龙™ AI Max+ 395 处理器和 128GB 内存的 ASUS ROG Flow Z13,AMD Variable Graphics Memory 设为 64GB,AMD Software: Adrenalin Edition 26.6.2 性能模式,Windows 11 Pro 25H2;对比系统为搭载 AMD 锐龙 PRO 6850U 处理器、32GB 4800 MT/s 内存的 HP EliteBook,AMD Software: Adrenalin Edition 24.10.20.01 性能模式,Windows 11 Pro 25H2。所有数据均为“最高可达”。性能可能有所差异。SH0-73
GPT-45:AMD 于 2026 年 7 月开展测试。性能以基于 CODEX 和 Python 的多智能体、重工具使用工作流在多次运行中的平均本地工具分片执行时间衡量。该工作流使用六个并行 Codex 子智能体、ChatGPT 5.5 High 和 Python 测试框架执行确定性的离线开发者工具任务,包括 AST/静态分析、编译/导入冒烟测试、单元式执行、JSON/CSV 序列化、SQLite 查询、压缩/哈希、软件包/清单操作及混合本地工具工作负载。系统配置:搭载 AMD 锐龙AI HX 470 处理器和 32GB 8533 MT/s 内存的 ASUS ZenBook S16,AMD Software: Adrenalin Edition 26.6.2 性能模式,Windows 11 Pro 25H2;对比系统为搭载 AMD 锐龙 PRO 6850U 处理器、32GB 4800 MT/s 内存的 HP EliteBook,AMD Software: Adrenalin Edition 24.10.20.01 性能模式,Windows 11 Pro 25H2。所有数据均为“最高可达”。性能可能有所差异。GPT-45

Related Blogs
-
AMD 为嵌入式设计与开发全周期注入 Agentic AI 强大能力
AMD Ross 智能体 AI( agentic AI ) 助手覆盖软件、芯片和板级设计,相较于典型开发生命周期,可显著加速嵌入式系统的设计、优化、调试和部署。
October 23, 2026
-
认识新一代 AMD 锐龙 AI Halo
近日,AMD 推出新一代搭载 AMD 锐龙 AI Max+ PRO 495 处理器的AMD 锐龙 AI Halo 开发者平台。凭借至高 192GB 统一内存、对 3000 亿参数及更大规模模型的支持,以及精心优化的软件体验,这一全新平台让开发者和创作者能够自由构建、实验,并在本地运行更多 AI。
October 12, 2026
-
-
AI 智能体如何提升 AMD Quark 用户体验
Quark AI Agent Skills(Quark AI 智能体技能包)提供了一种引导式、对话式的模型量化方案,让用户可依托基于 Quark 官方文档与源代码构建的安全分步工作流程,轻松地对 PyTorch 和 ONNX 模型进行准备处理以适配 AMD 硬件。
August 24, 2026
-
在AMD 锐龙 AI Max 智能体PC和Radeon 显卡上运行Qwen3.8 27B模型
Qwen3.8 27B 现已发布,并针对 AMD Ryzen™ AI 处理器和 Radeon™ 显卡提供“Day 0”级支持。您可以在受支持的 AMD 硬件上,利用 LM Studio 本地运行这款最新的 Qwen 模型;同时,借助 Lemonade 和 AMD 提供的一流推理支持,您可以轻松构建并交付本地 AI 应用程序。
August 14, 2026
-
-
在 AMD 锐龙 AI Max+ Agentic PC 和 Radeon GPU 上运行 Meta Muse Glimmer 30B
Meta 的 Muse Glimmer 30B 为 AMD 系统带来了强大的本地 AI 能力。 您可以在搭载 AMD Ryzen™ AI Max+ 芯片的智能体 PC(Agentic PC)或 Radeon™ AI PRO R9700 显卡上本地运行该模型。利用 LM Studio 进行探索,使用 Lemonade 进行构建,并将本地 AI 功能集成到您的应用程序中。
August 10, 2026
-
借助 Poro 2 Long 扩展上下文窗口并探索多语言推理
AMD Silo AI 发布两款全新开源 Poro 2 模型:Poro 2 8B Long(上下文窗口实现 16 倍扩展),以及 Poro 2 8B Math Reasoning。
August 06, 2026