ROCm.AI:面向 AMD 平台的 AI 原生开发体验
Jul 24, 2026
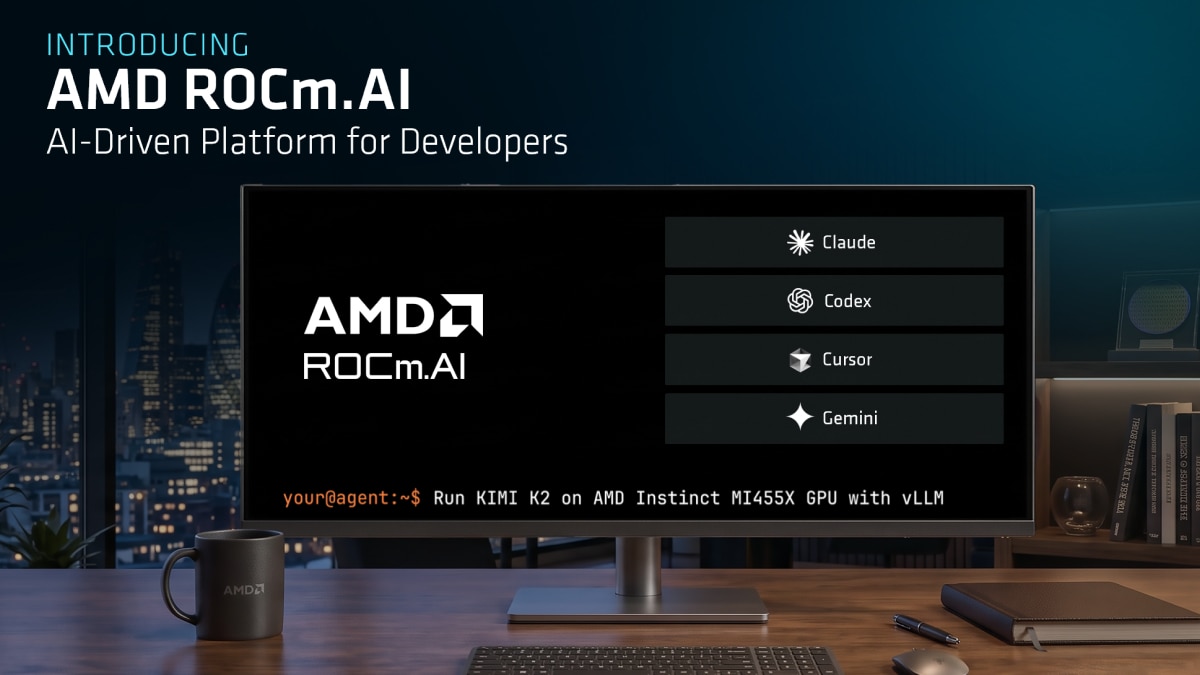
从意图捕获到工作负载调优:ROCm.AI 赋能 AMD 平台 AI 开发,加快开发速度并让采用更轻松
基于 AMD 平台的 AI 开发现已覆盖云端基础设施、企业集群、工作站、台式机和 AI PC。真正的问题在于:开发者能够以多快的速度基于 AMD 硬件构建经过优化的 AI 服务。
在整个 AMD AI 生态系统中,AMD ROCm 软件持续加快软件版本迭代速度,扩大开源社区参与度,拓展框架适配范围,强化模型适配能力,降低开发者使用门槛,并完善 AI 技术栈的验证覆盖。这一发展势头贯穿了 AMD 的完整 AI 产品版图,涵盖云端与数据中心基础设施中的 AMD Instinct GPU、AMD Radeon 工作站、Radeon 台式 GPU 以及锐龙系统。无论 AI 工作负载运行于何种环境,开发者均可获得更为统一的软件开发路径。AMD 软件迭代节奏持续加快,适配不断增长的客户需求,同时进一步降低落地门槛。
ROCm.AI 正是下一阶段的演进方向:让开发者能够更加轻松地使用快速迭代的软件技术。
ROCm.AI 将 AI 原生开发体验引入 AMD 平台。ROCm.AI 在 Advancing AI 2026 大会上正式发布,将 AI 辅助开发、智能部署和 AI 驱动的软件优化能力相整合,带来统一的开发体验。
加快 ROCm 开发速度
通过将 AI 和智能体工作流程应用于 ROCm 开发,ROCm.AI 致力于为开发者提供更出色的软件体验:降低环境搭建难度、简化问题诊断,帮助开发团队更快运行 AI 工作负载。
简化 AMD 平台上的 AI 使用体验
ROCm.AI 让基于 AMD 硬件运行 AI 工作负载变得更加轻松。开发者可以轻松安装软件栈、检查环境、部署模型、诊断问题,并遵循经过 AMD 验证的工作流程,而无需手动拼凑各种命令。
提升性能
ROCm.AI 借助 ROCm Hyperloom 实现性能优化。Hyperloom 是一个自主智能体系统,可通过识别瓶颈、应用针对性优化和执行正确性验证,来优化端到端推理工作负载。
面向 AMD AI 软件栈的内置 AI 辅助功能
ROCm.AI 整合了多项互补功能:
图像缩放
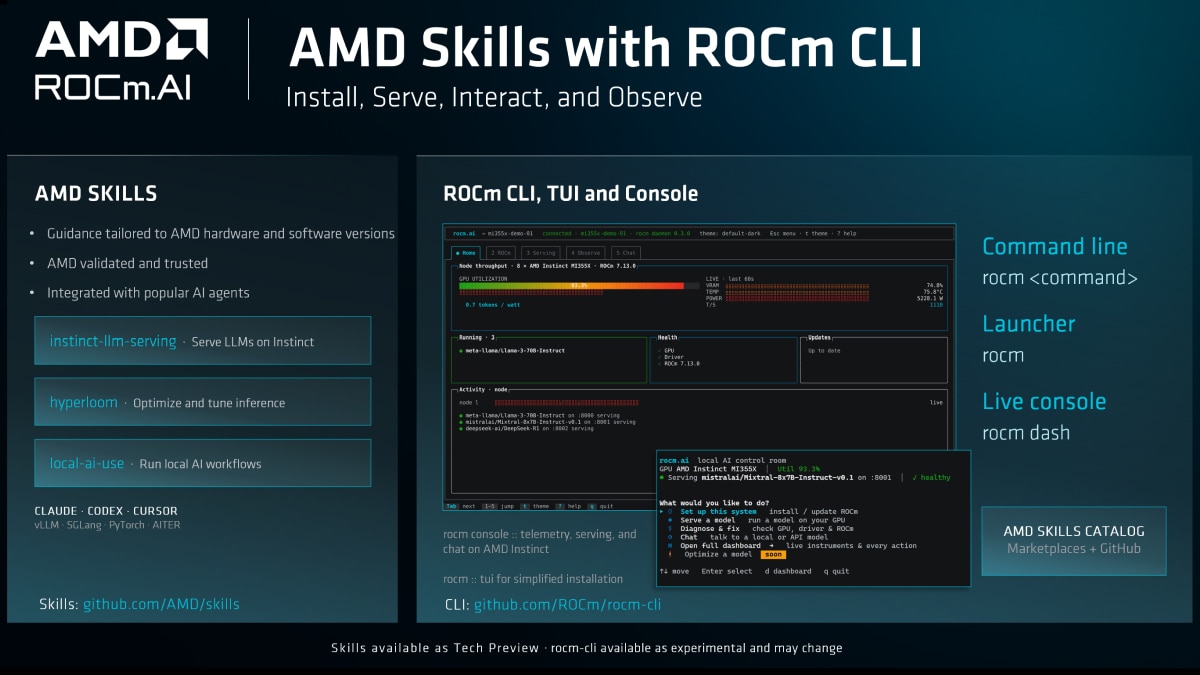
AMD Skills:智能体进入 ROCm.AI 的入口
AMD Skills 是 ROCm.AI 对接开发者现有智能体工具的主要方式。它将经过 AMD 验证的 ROCm 专业知识直接注入 Claude、Cursor、Codex 及其他主流 AI 助手中,从而使这些助手能够根据 AMD 硬件、ROCm 版本和支持的软件路径提供针对性指导。
开发者无需翻阅文档、拼凑命令,或是套用通用示例,只需描述开发目标,即可由智能体调用 AMD Skills 来引导整个工作流程。
AMD Skills 目前已正式集成到多款编码助手中并可供调用。开发者可从 Codex 插件目录或 Cursor 市场中的 AMD 页面安装 AMD Skills,或在 Claude 插件中搜索“amd-skills”进行安装。
AMD Skills 示例
- serving-llms-on-instinct:基于 ROCm 和 vLLM 在 AMD Instinct GPU 上部署生产级大语言模型服务端点。
- tracelens:将 PyTorch Profiler 追踪数据转化为具有实用价值的性能报告,以便加速推理和训练。
- local-ai-use:将图像、语音和文字转语音任务路由到 AMD 客户端硬件上运行的本地服务器,保障隐私且无需承担云服务开销。
- local-ai-app-integration:跨 NPU、iGPU 和 dGPU,将设备端 AI 嵌入自己的应用中。
ROCm CLI:执行层
它为用户提供了一条可信赖的命令行路径,用于安装 ROCm 软件、检查环境、部署模型、更新组件以及生成诊断报告。它专为需要实现可重复执行的开发者、平台工程师、企业管理员、CI/CD 团队和安全环境而设计。CLI 具备确定性,且可通过脚本执行。开发者可以直接运行 CLI。此外,可通过脚本在 CI 中调用它。编码智能体在获得授权后也可调用它。ROCm Console 可以呈现其状态。
rocm install
rocm doctor
rocm serve qwen3
rocm update
ROCm Console:遥测和诊断
ROCm Console 可显示系统和工作负载状态。它会展示遥测数据、日志、运行时状态和诊断上下文,帮助用户了解机器的运行状况。在团队处理敏感工作负载、集群或需要保留在环境内部的性能数据时,了解这些信息尤为重要
ROCm Hyperloom:工作负载优化
ROCm Hyperloom 是一种自主智能体系统,专为优化 AMD GPU 上的端到端推理工作负载而设计,优化目标包括主机代码与 GPU 内核。该系统依托 AI 智能体与性能剖析工具,分析工作负载、识别瓶颈、应用针对性优化并对性能与正确性进行验证,从而助力开发者提升性能。它整合了底层 GPU 性能剖析、追踪数据采集、追踪分析以及内核与代码迭代优化能力,消除了传统 GPU 调优过程中的大量人工操作。
Hyperloom 可对工作负载进行性能剖析、识别瓶颈并制定应对方案、探索可行优化方案、对改动进行基准测试,最终生成报告并列明优化建议与预期性能提升幅度,从而帮助开发者从“可运行的工作负载”演进至“深度优化的部署版本”。
ROCm.AI 实际应用
ROCm.AI 的设计理念是适配开发者现有的工作流程。
在 AMD Strix Halo 系统上
“设置这台机器以运行本地 AI。”
ROCm.AI 可以引导用户完成硬件检测、环境搭建、模型部署及本地 AI 工作流程。
在 AMD Instinct 基础设施上
“在 AMD Instinct GPU 上部署 Qwen 3.6 27B。”
ROCm.AI 可帮助检查硬件和软件环境、选择合适的部署路径、启动模型服务端点并确认其正常运行。
性能优化
“对当前正在运行的模型进行推理性能优化。”
ROCm Hyperloom 可分析工作负载、识别主机代码和 GPU 内核中的瓶颈、应用针对性优化,并验证性能和正确性。
ROCm.AI 通过更具引导性的 AMD 软件体验,帮助开发者完成从模型选型、运行端点再到性能优化的全流程。1
对开发者和平台团队的重要价值
AI 开发越来越多地由智能体驱动,硬件平台也变得更加多样化。如今,开发者要基于 AI PC、Radeon 台式机、工作站和 AMD Instinct 集群开展开发工作。
ROCm.AI 提供了更为统一的软件体验,可引导开发者完成环境搭建、环境验证和模型部署,同时提供本地遥测数据并帮助优化工作负载。对于本地开发者,ROCm.AI 可加快从安装全新 AMD 系统到运行本地 AI 工作负载的流程。对于平台和 MLOps 团队,它使工作流程在不同用户和环境之间更具可重复性。对于企业运维人员,它支持本地可见性和可控性。对于正在评估 AMD 基础设施的 AI 公司、云服务商和新型云服务商 (NeoCloud),它可以帮助客户更快地从实例访问过渡到部署经过验证的工作负载。
AI 基础设施的未来不会仅由硬件来定义,而是将由让高性能硬件更易使用、更易于优化、更值得信赖的平台来塑造。借助 ROCm.AI,AMD 简化了基于 AMD 平台的 AI 开发、部署与调优流程,助力开发者提升开发效率,同时让决策者能够更放心地采用 AMD AI 基础设施。
即将推出:
AMD Skills 目录将持续扩充,新增覆盖本地系统、开发者工作站以及数据中心基础设施的各类工作流程,其中包括:
- HIP Runtime Replay Analysis:记录和回放 HIP 调用、内核启动和内存操作以复现 GPU 故障,为 AMD Instinct 和 Radeon 硬件故障的根因分析提供指引。
- ROCm Doctor:通过检查环境是否存在已知配置和兼容性问题,诊断常见的 ROCm、PyTorch 和 llama.cpp 故障。
- Hyperloom Kernel Optimizer:使用智能体优化工作流程来识别 GPU 瓶颈、评估代码变更,并优化推理和内核性能。
- APU Memory Tuner:针对支持的 AMD APU 进行共享内存和专用内存分配分析与优化,以改善模型适配能力并优化本地 AI 性能。
AMD Skills 目录目前为技术预览版,仍在以开放模式持续开发,因此技能名称、范围和可用性可能会随着新工作流程通过验证而发生变化。
ROCm.AI - 简化智能体 AI 工作流程。
从 AMD Skills 和 ROCm CLI 着手,在 AMD 平台上安装、检查、部署、迁移和优化 AI 工作负载。
Contributors

Related Blogs
-
AI 智能体如何提升 AMD Quark 用户体验
Quark AI Agent Skills(Quark AI 智能体技能包)提供了一种引导式、对话式的模型量化方案,让用户可依托基于 Quark 官方文档与源代码构建的安全分步工作流程,轻松地对 PyTorch 和 ONNX 模型进行准备处理以适配 AMD 硬件。
August 24, 2026
-
在AMD 锐龙 AI Max 智能体PC和Radeon 显卡上运行Qwen3.8 27B模型
Qwen3.8 27B 现已发布,并针对 AMD Ryzen™ AI 处理器和 Radeon™ 显卡提供“Day 0”级支持。您可以在受支持的 AMD 硬件上,利用 LM Studio 本地运行这款最新的 Qwen 模型;同时,借助 Lemonade 和 AMD 提供的一流推理支持,您可以轻松构建并交付本地 AI 应用程序。
August 14, 2026
-
-
在 AMD 锐龙 AI Max+ Agentic PC 和 Radeon GPU 上运行 Meta Muse Glimmer 30B
Meta 的 Muse Glimmer 30B 为 AMD 系统带来了强大的本地 AI 能力。 您可以在搭载 AMD Ryzen™ AI Max+ 芯片的智能体 PC(Agentic PC)或 Radeon™ AI PRO R9700 显卡上本地运行该模型。利用 LM Studio 进行探索,使用 Lemonade 进行构建,并将本地 AI 功能集成到您的应用程序中。
August 10, 2026
-
借助 Poro 2 Long 扩展上下文窗口并探索多语言推理
AMD Silo AI 发布两款全新开源 Poro 2 模型:Poro 2 8B Long(上下文窗口实现 16 倍扩展),以及 Poro 2 8B Math Reasoning。
August 06, 2026
-
AMD 携手上海挚科 (ZHIKE),助力青心意创打造新一代具身角色智能机器人
随着具身智能机器人迈向产业化,机器人正从执行固定任务的自动化设备,演进为能够理解环境、感知情绪并与人自然交互的智能伙伴。面向这一快速发展的新赛道,AMD携手生态伙伴挚科(ZHIKE),为上海青心意创打造搭载AMD 锐龙 Threadripper PRO 9975WX处理器的高性能AI液冷工作站,助力其加速具身智能机器人研发,为机器人创新提供强劲算力支撑。
August 03, 2026
-
-
附注
- AMD Hyperloom 性能提升效果因工作负载和起始性能基准而异。结果还可能因模型架构、硬件配置、软件环境以及识别到的优化机会而有所不同。
附注
- AMD Hyperloom 性能提升效果因工作负载和起始性能基准而异。结果还可能因模型架构、硬件配置、软件环境以及识别到的优化机会而有所不同。