MiniCPM-V 4.7 首日支持 AMD Radeon GPU、Ryzen AI 集成显卡和 Ryzen AI NPU,赋能端侧与边缘 AI
Oct 14, 2026
在面壁智能最新多模态模型 MiniCPM-V 4.7 开源发布之际,AMD Radeon GPU、Ryzen AI Max 处理器中的集成显卡,以及基于 XDNA 2 架构的 Ryzen AI NPU 已实现 Day 0 支持。
MiniCPM-V 4.7 提供 1B 和 35B-A3B 两个版本,面向 AI PC、汽车系统、机器人、边缘设备和服务器上的端侧 AI 推理。开发者可根据设备资源、任务要求和部署条件,选择最合适的模型规模和推理路径。
从 AMD Radeon GPU、Ryzen AI Max 集成显卡到面向开发者的 Ryzen AI NPU Day 0 支持,AMD 正与面壁智能携手打通模型、硬件与开发资源。本文介绍 Radeon GPU 上的功能验证与部署,并说明 Ryzen AI NPU 支持进展及开发者服务获取方式。
GPU 验证覆盖 Radeon AI PRO R9700、Radeon PRO W7900D,以及搭载 Radeon 8060S 显卡的 Ryzen AI Max 395 平台,涵盖独立 GPU 和 APU。测试使用一张包含标题和配额规则的图片,检查模型能否读取图片,并生成与图片内容一致的回答。
Device |
GPU architecture or target |
1B |
35B-A3B |
Radeon AI PRO R9700 |
RDNA 4/ |
Pass |
Pass |
Radeon PRO W7900D |
RDNA 3/ |
Pass |
Pass |
Radeon 8060S / Ryzen AI Max 395 |
gfx1151 APU |
Pass |
Pass |
上述所有组合均成功完成推理。运行时日志确认,语言模型和视觉投影器均使用 AMD ROCm™ 软件后端,模型输出与测试图片一致。这些结果表明,在受测配置下,这两个模型版本均可在所列设备上执行图像与文本推理。本次验证侧重功能正确性;本文尚未报告吞吐量、首 token 延迟和 GPU 显存使用量。
使用 ROCm 和 llama.cpp HIP 后端部署 GPU
图像与文本推理需要加载语言模型 GGUF 文件及其配套的视觉投影器 GGUF 文件。视觉组件会对图像进行编码和投影,将其转换为语言模型可处理的表示。模型文件路径通过环境变量指定,便于切换模型版本并复用构建结果。
以下命令适用于已安装 ROCm 的 Ubuntu/Debian Linux 环境。请在同一 Bash 会话中按顺序运行。后续所有构建、推理和服务器命令均在 llama.cpp 源代码目录中执行。
1. 检查 ROCm 环境
		rocminfo | grep -E 'Name:[[:space:]]+gfx' | sort -u
rocm-smi --showproductname --showmeminfo vram
选择与设备对应的 GPU 目标,并根据实际 rocminfo 输出进行核对。Radeon AI PRO R9700 使用 gfx1201,Radeon PRO W7900D 使用 gfx1100,Radeon 8060S / Ryzen AI Max 395 使用 gfx1151。
2. 获取源代码并构建 llama.cpp HIP 后端
安装构建工具,并将固定版本的源代码提取到新的工作目录。以下步骤使用 gfx1201 作为构建目标。对于其他设备,请将 GPU_TARGET 替换为相应值。
		sudo apt-get update
sudo apt-get install -y build-essential cmake git

git init llama.cpp
cd llama.cpp
git remote add origin https://github.com/tc-mb/llama.cpp.git
git fetch --depth 1 origin 6b31908189524f2f98824a38e09a553ea43cbd21
git checkout --detach FETCH_HEAD
GPU_TARGET=gfx1201
BUILD_DIR="build-$GPU_TARGET"
HIPCXX="$(hipconfig -l)/clang" \
HIP_PATH="$(hipconfig -R)" \
cmake -S . -B "$BUILD_DIR" \
    -DGGML_HIP=ON \
    -DGPU_TARGETS="$GPU_TARGET" \
    -DGGML_NATIVE=OFF \
    -DLLAMA_CURL=OFF \
    -DLLAMA_BUILD_SERVER=ON \
    -DLLAMA_BUILD_TESTS=OFF \
    -DCMAKE_BUILD_TYPE=Release

cmake --build "$BUILD_DIR" \
    --target llama-mtmd-cli llama-server \
    --config Release \
    --parallel 16
GGML_HIP=ON 用于启用 HIP 后端,GPU_TARGETS 用于指定目标架构。构建流程会生成用于图像与文本推理的 llama-mtmd-cli,以及用于提供模型服务的 llama-server。
3. 准备模型和输入图片
下载所选版本的语言模型 GGUF 文件及其配套视觉投影器,然后通过环境变量指定路径。切换模型版本时,需要同时更新语言模型和对应投影器。
		export MODEL_GGUF="/absolute/path/to/model.gguf"
export MMPROJ_GGUF="/absolute/path/to/matching-mmproj.gguf"
export IMAGE_FILE="/absolute/path/to/input.png"
检查输入并设置运行目录
使用已准备好的模型、视觉投影器和输入图片,运行一次图像与文本推理请求。
		: "${MODEL_GGUF:?set MODEL_GGUF to the released language-model GGUF}"
: "${MMPROJ_GGUF:?set MMPROJ_GGUF to the matching visual projector}"
: "${IMAGE_FILE:?set IMAGE_FILE to an input image}"

BIN="$PWD/$BUILD_DIR/bin"
export LD_LIBRARY_PATH="$BIN${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"
"$BIN/llama-mtmd-cli" \
        -m "$MODEL_GGUF" \
        --mmproj "$MMPROJ_GGUF" \
        --image "$IMAGE_FILE" \
        --prompt 'Please describe the main content of the image.' \
        --jinja \
        -c 4096 \
        -n 192 \
        --temp 0 \
        -ngl 999
此示例将上下文长度设置为 4,096 个 token,最多生成 192 个 token,并使用 -ngl 999 请求尽可能多地将语言模型层卸载到 GPU。请检查日志以确认实际卸载行为。对于本文使用的测试图片,也可以使用更具体的提示词,例如:“请读取图片中的标题,并解释每条配额规则。”
验证时,请确认语言模型和视觉投影器均使用 ROCm 后端,并确认回答中的标题、数字和规则与图片一致。
4. 启动图像与文本推理服务
在通过命令行验证推理后,在同一会话中使用相同的模型文件启动服务器。
		"$BIN/llama-server" \
    -m "$MODEL_GGUF" \
    --mmproj "$MMPROJ_GGUF" \
    --host 0.0.0.0 \
    --port 8080 \
    --jinja \
    -c 4096 \
    -np 1 \
    -ngl 999
服务器启动后,应用可通过 OpenAI 兼容 API 提交包含文本和 image_url 的消息。图片可作为 Base64 数据 URL 传入。验证服务时,请使用同一张测试图片检查完整请求路径,并再次核对后端日志和实际回答。这样,开发者便可从单次命令行推理请求过渡到应用服务集成。
AMD Ryzen AI 处理器的 NPU 支持
除 GPU 路径外,MiniCPM-V 4.7 还在发布首日支持 AMD Ryzen AI 处理器中的 NPU,为端侧多模态应用提供另一种部署选择。
支持的平台与模型
AMD NPU 推理运行时 FastFlowLM 为此次 Day 0 发布提供模型支持。从 v1.0.8 开始,FastFlowLM 支持在 Ryzen AI NPU 上运行 MiniCPM-V-4.7-1B 推理。支持的平台为搭载 XDNA 2 NPU 的 Ryzen AI PC,包括 AMD Ryzen AI Max、AMD Ryzen AI 400 和 AMD Ryzen AI 300 系列。
推理工作流与部署
FastFlowLM 提供交互式命令行界面和 OpenAI 兼容的本地 HTTP 服务。模型标签为 minicpm-v-4.7:1b。其权重采用 NPU2 格式的 Q4_K 量化,包括语言模型文件 model.q4nx 和视觉权重文件 vision_weight.q4nx,总大小约为 2.2 GB。运行 flm pull 后即可加载模型。
输入由文本和图片组成,单次请求可包含多张图片。默认上下文长度为 32K token,最大可达 256K token。
以下命令适用于 Windows,应在 PowerShell 中运行。
1. 安装 FastFlowLM 并检查 NPU
从 FastFlowLM v1.0.8 的发布页面(Release Page)下载并安装 Windows 安装包。安装完成后,运行:
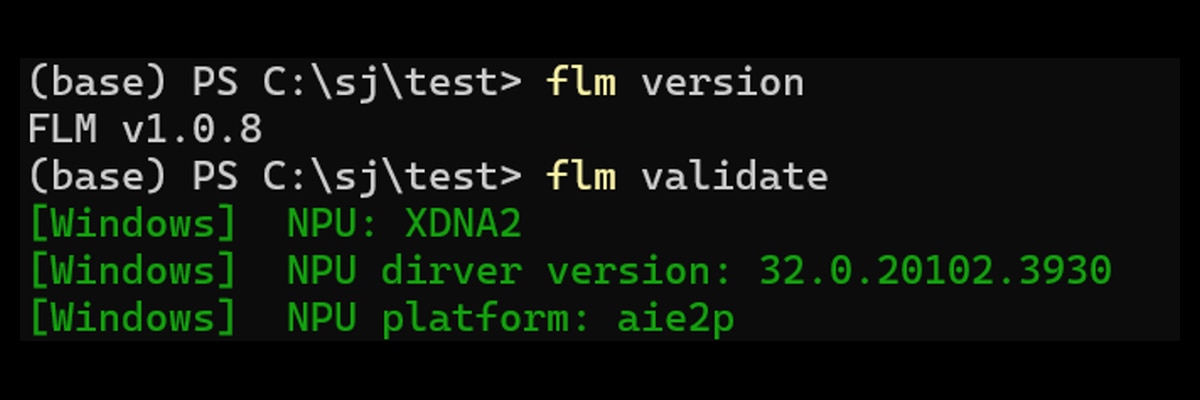
		flm version
flm validate
flm version 应显示 1.0.8 或更高版本;flm validate 应将 NPU 识别为 XDNA2。
2. 下载并检查模型
		flm pull minicpm-v-4.7:1b
flm check minicpm-v-4.7:1b
下载 ModelScope:
flm pull minicpm-v-4.7:1b --modelscope
在 Windows 上,权重默认存储在 %USERPROFILE%\.flm\models\MiniCPM-V-4.7-1B-NPU2。模型页面可在 Hugging Face 和 ModelScope 获取。flm check 用于验证所有模型文件是否齐全,并与当前 FastFlowLM 版本兼容。
3. 从命令行运行图像与文本推理
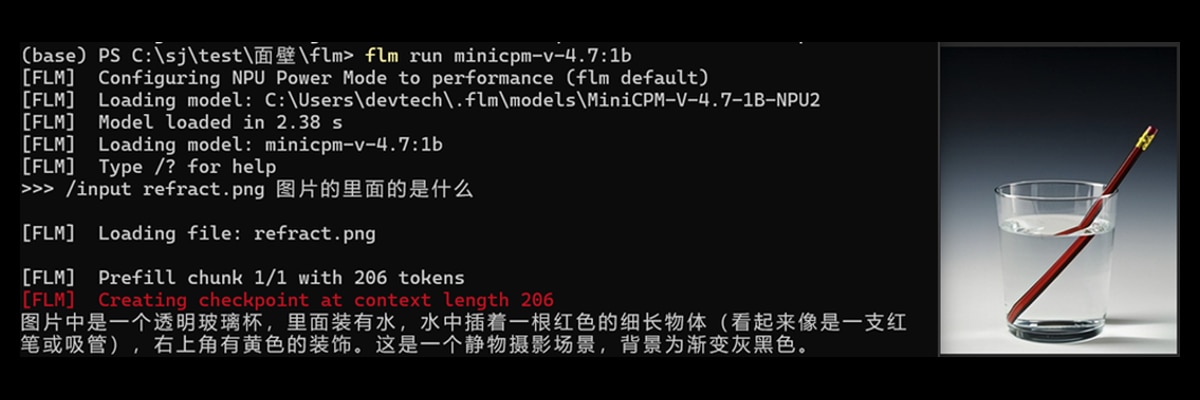
		flm run minicpm-v-4.7:1b
/input C:\path\to\image.png Please describe the image.
进入会话后,使用 /input 提供图片路径和提示词;/input 后必须跟文件路径。使用 /think 切换思考模式,该模式默认启用;使用 /bye 退出会话。
4. 启动图像与文本推理服务
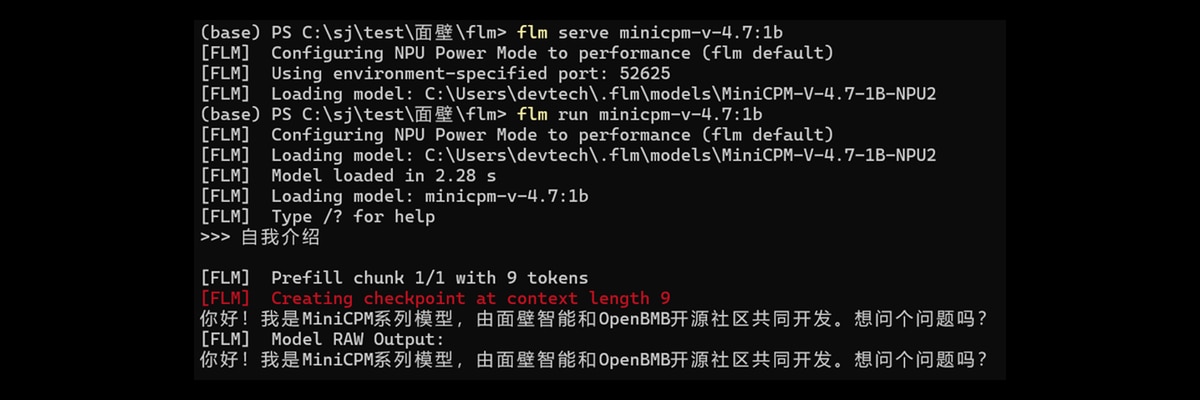
flm serve minicpm-v-4.7:1b
默认端口为 52625。应用向 /v1/chat/completions 提交文本和 Base64 数据 URL。在以下示例中,"think": false 用于关闭思考模式,并将 temperature 设置为 0:
		import base64
import json
import urllib.request

image_path = r"C:\path\to\image.png"
with open(image_path, "rb") as f:
    image = base64.b64encode(f.read()).decode("ascii")

body = {
    "model": "minicpm-v-4.7:1b",
    "temperature": 0,
    "max_tokens": 256,
    "think": False,
    "messages": [{
        "role": "user",
        "content": [
            {"type": "text", "text": "Please describe the image."},
            {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{image}"}},
        ],
    }],
}
req = urllib.request.Request(
    "http://127.0.0.1:52625/v1/chat/completions",
    data=json.dumps(body).encode("utf-8"),
    headers={"Content-Type": "application/json"},
)
with urllib.request.urlopen(req, timeout=180) as resp:
    print(json.load(resp)["choices"][0]["message"]["content"])
验证结果与应用示例
本次验证使用搭载 AMD Ryzen AI Max+ 395、运行 Windows 11 的系统,采用 FastFlowLM v1.0.8 和 NPU 驱动程序 32.0.20102.3930。测试覆盖文本对话、图文理解,以及不同上下文长度下的推理性能。
文本对话测试
图文理解测试
不同上下文长度下的推理性能
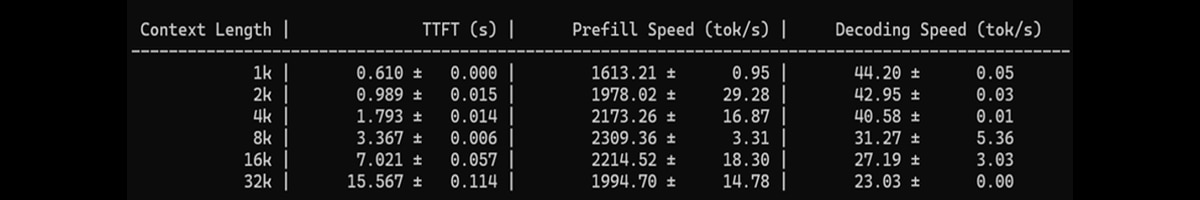
模型在文本对话测试中成功完成自我介绍。对于示例图片,模型正确描述了图片内容,单张图片的首 token 延迟约为 1.2 秒。在 1K 至 32K 的上下文长度范围内,解码速度约为 44 至 23 token/秒。
加入 AMD 开发者计划,开始构建多模态 AI 应用
AMD GPU 和 Ryzen AI Max NPU 对 MiniCPM-V 4.7 的 Day 0 支持,为开发者提供了一条从模型试用、应用验证到设备部署的实用途径。GPU 验证覆盖不同 Radeon 设备类型上的多种模型与硬件组合,部署工作流涵盖构建、单次请求推理和服务器启动。
立即注册 AMD 开发者计划,获取相关开发者权益。
参考链接
- openbmb/MiniCPM-V-4.7-1B · Hugging Face
- openbmb/MiniCPM-V-4.7-35B-A3B · Hugging Face
- FastFlowLM · FastFlowLM
- FastFlowLM/MiniCPM-V-4.7-1B-NPU2 · Hugging Face
- modelscope.cn/models/amd/MiniCPM-V-4.7-1B-NPU2 - ModelScope
- AMD Developer Program
致谢
为本项目作出贡献的 AMD 团队成员:Michelle Yu、Shouyu Du、Zhiheng Ni、Alfred Xu、Tao Wei、Adrian Macias、Jin Ran、Jian Song、Alex Yang、Joey Qiao、Fan Zhang、Krishna Sivakumar、Letian Kang、Vincent Fang、Bingqing Guo。

Related Blogs
-
基于 AMD EPYC(霄龙)的 llama.cpp
了解 ZenDNN 如何通过优化的 CPU 内核和基准测试,在 AMD EPYC(霄龙)处理器上加速 llama.cpp 运行。
August 18, 2026
-
-
-
开放标准,切实解决方案:AMD 亮相 SIGGRAPH 2026
AMD 亮相 DigiPro 和 SIGGRAPH 2026,探讨开放标准、制作技术以及高斯泼溅 (Gaussian Splatting) 这一精妙技术。
July 17, 2026
-
AMD Advancing AI 2026 前瞻:精彩内容抢先看
抢先了解“AMD Advancing AI 2026”大会,探索塑造 AI 未来的核心议题、会议环节及创新技术。了解行业领军者如何携手合作,共同探讨实际应用场景以及在企业范围内规模化部署 AI 的策略。
July 14, 2026
-
-
AMD Ryzen AI 开发者平台:开源、就绪,专为 AI 而生
了解 AMD Ryzen AI 开发者平台:开源、AI 优先,致力于帮助开发者构建、测试和部署 AI 工作负载。
July 06, 2026
-
HandBrake 1.11.0 提升 AMD 锐龙 Threadripper 及 Threadripper PRO 的可扩展性
AMD 帮助 HandBrake 1.11.0 优化了高核心数 Threadripper 系统的线程管理和转码性能。
June 17, 2026