Iterate.ai 基于 AMD 锐龙 AI PRO 处理器构建专用 AI 模型
Iterate.ai 基于 AMD 锐龙 AI PRO 处理器构建 320 亿参数的专用 LLM,支持 32K 模型上下文窗口大小,且处理速度达到约 60–80 token/秒,大幅降低云成本和风险
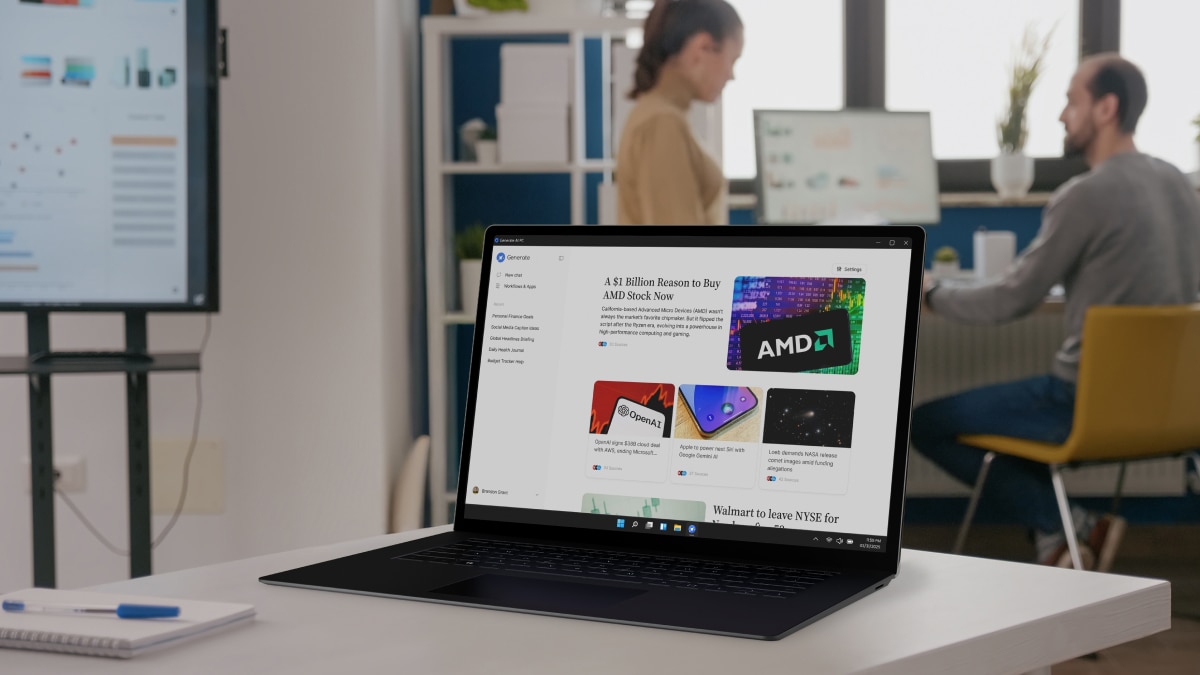
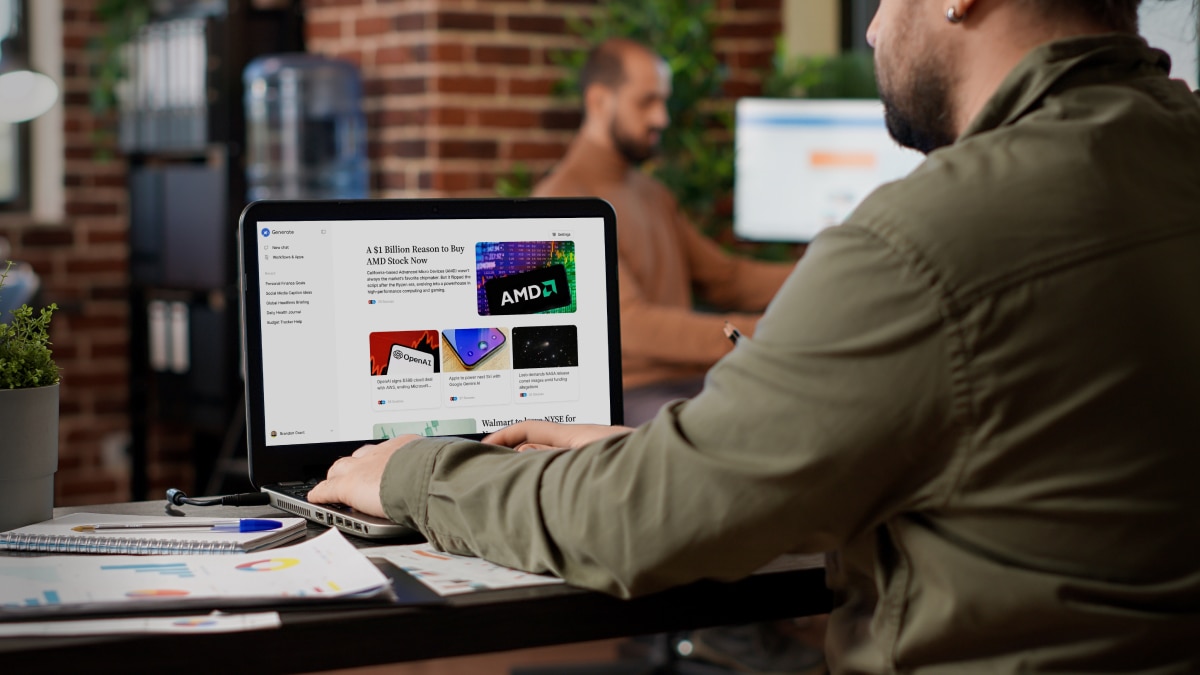
Iterate.ai 自称“私有 AI 公司”。随着企业纷纷采用生成式 AI 来提升生产力,Iterate.ai 专注于支持在企业内部安全运行的复杂工作流程。借助该公司推出的 Generate 应用,大型企业能够构建个性化 AI 助手和智能体工作流程,高效分析分散在 Jira、Slack 和 Salesforce 等关键业务系统中的复杂数据。
为实现强大的本地 AI 功能,同时防止数据泄露,Iterate.ai 与 AMD 紧密合作,专门针对 AMD 锐龙 AI PRO 处理器对 Generate 进行了优化。得益于本次合作,Generate 能够协同调用 AMD 锐龙 AI PRO 处理器的 CPU、集成 GPU 与专用 NPU。通过在用户设备本地部署并运行 Generate 解决方案,Iterate.ai 支持企业完全保留并控制数据,同时帮助企业将可变的云 Token 费用转变为可预测的固定成本。
保障数据安全并控制 Token 成本
IT 决策者同时看重性能与安全。在转向 AI 技术的过程中,企业难以管控敏感专有信息被泄露至公共大语言模型 (LLM) 的风险,这导致对安全风险的担忧随之加剧。
Iterate.ai 专项项目工程师 Karanbir Singh 表示:“Generate 所要解决的一大痛点便是数据安全。在使用公共 LLM 时,企业无法控制数据留存情况。Iterate.ai 支持 AI 模型与应用一同运行于本地设备之上,以此确保数据不会上传至互联网。”
成本问题令这项挑战雪上加霜。Iterate.ai 联合创始人兼首席技术官 Brian Sathianathan 表示:“近期行业研究表明,仅过去一年,Token 使用量就增长了多达 100 倍。”云端 LLM 推理按 Token 计费,给企业预算带来了巨大波动与成本不确定性。Iterate.ai 希望助力企业的 AI 工作流程摆脱这种按量计费模式,同时赋能企业建立完整的数据主权。该解决方案还需要支持离线运行,以便用户在出行途中或遇到连接问题时仍能继续使用 AI。
AMD 推动私有 AI 技术向前发展
Iterate.ai 选择 AMD,是因为 AMD 全面的技术栈可满足其企业级产品对于规模化部署和灵活性的需求。Sathianathan 表示:“AMD 极具吸引力的一点是,AMD 拥有集 CPU、GPU 和 NPU 于一体的高性能笔记本电脑处理器产品。与此同时,AMD 还提供像 AMD Instinct 系列 GPU 这样的强大服务器端解决方案。因此,选择 AMD,可获得从客户端到服务器的端到端解决方案。AMD 凭借自身优势推动私有 AI 变革,是 Iterate.ai 的理想合作伙伴。”
借助 AMD Lemonade Server 加速开发
Iterate.ai 集成了可简化本地 LLM 开发的开源工具,即 AMD Lemonade Server。Sathianathan 表示:“Lemonade Server 的所有能力均以兼容 OpenAI 接口的形式对外提供,符合行业通用的默认标准。AMD 在 Lemonade Server 上所投入的工作,大幅降低了我们的应用与 LLM 之间的集成难度”。
这种精简方案缩短了 Iterate.ai 的部署周期并降低了资源需求。Sathianathan 表示:“如果所有工作都由我们自己完成,所需工程师的数量至少要翻一倍。AMD 软硬件一体化组合非常稳定可靠,事实上堪称卓越,使我们能用远低于常规水平的资源来完成 LLM 开发。”
优化硬件利用率
依托 AMD 锐龙 AI PRO 处理器的高性能架构,Iterate.ai 得以设计出实力远超以往的强大本地 AI 应用。Generate 利用 AMD 锐龙 AI PRO 处理器的三大组件(CPU、GPU 和 NPU),实现出色性能。这种并行架构至关重要,因为 Generate 需要覆盖从简单的文档总结到高度复杂的图表分析等各类应用场景。
协同硬件加速对于能效表现和电池续航能力至关重要。Sathianathan 强调了专用 NPU 带来的价值,他表示:“AMD 锐龙 AI NPU 经过深度优化,可长时间运行 LLM,非常适合高度复杂的任务。在 PC 端,用户处于内存与资源受限的环境中。我们可以充分利用 NPU、GPU、CPU 的不同功耗特性。理想的方案便是,能够并行调用 AMD 锐龙 AI PRO 处理器的全部硬件资源。这种方案还有助于避免在执行 LLM 高强度运算时,耗尽用户笔记本电脑的电池电量。”
实现规模扩展、成本确定性与数据主权
Sathianathan 指出,基于 AMD 平台进行部署是 Iterate.ai 能够满足现代企业需求的关键所在。他表示:“依托 AMD 平台,可充分利用本地 AI,获得安全、隐私和成本优势,为各类企业和组织带来确定性保障。”
与此同时,这种确定性建立在可衡量的卓越性能之上。Iterate.ai 的测试结果证实,AMD 平台性能卓越,可支持模型扩展。Singh 表示:“按照行业标准,对于 AI PC 而言,140 亿参数、16K 上下文窗口的模型是适用的基准模型。借助 AMD 锐龙 AI 处理器,我们可以运行 320 亿参数的模型,规模几乎翻倍,上下文窗口达 32K。”
得益于这一模型规模优势,Iterate.ai 能够在 PC 本地处理要求更为严苛的企业级工作负载。测试指标证实,在系统上运行专有 Iterate.ai 模型时可实现高吞吐量:在执行文档搜索查询期间,Iterate.ai Interplay RAG 模型的平均吞吐量约为 60-80 Token/秒,峰值吞吐量可达 92.89 Token/秒。
Sathianathan 表示:“在本地运行 Generate,意味着成本完全是固定的。大量可变成本将不复存在,因为这属于一次性采购所产生的资本支出,该支出基本可以在 PC 的使用寿命内进行摊销。”
通过将 LLM 的全部内存保留在 PC 上,Generate 可保障数据主权,帮助企业满足 HIPAA、GDPR 和 SOC 2 等合规标准。AMD PRO 安全技术提供多层防护(包括 AMD Memory Guard),进一步强化这种隐私优先的设计理念。AMD Memory Guard 可实时加密系统内存,有助于在 PC 丢失或被盗时保护敏感业务数据。
引领私有 AI 发展
Iterate.ai 已着手规划,针对新一代 AMD 处理器优化其应用。Singh 着重阐述了 AMD 路线图及双方合作关系。他表示:“在未来 12 至 18 个月内,我们的目标是利用规模更大、上下文窗口更长的大语言模型,来满足越来越多的客户应用场景需求。我认为 AMD 在未来愿景方面做得非常出色;我们很荣幸成为 AMD 的合作伙伴,我们将努力抓住新机遇,落地各类应用场景。”
关于客户
Iterate.ai 是一家专注于创新的软件公司,致力于面向大型组织打造企业级 AI 平台和应用。Iterate.ai 总部位于加利福尼亚州圣何塞,不仅推出了拥有专利的低代码 AI 平台 Interplay,还提供 Generate 等私有 AI 解决方案,致力于帮助零售、金融服务和科技等多个行业的企业快速构建、部署和扩展安全的生成式 AI 体验。如需了解更多信息,请访问 iterate.ai。
成功案例资料
- 行业:
软件 - 挑战:
企业在使用生成式 AI 时,需要避免将敏感数据外泄给公共 LLM,同时控制快速上涨的 Token 成本,并支持用户在出行途中或离线时使用。 - 解决方案:
Iterate.ai 针对搭载 AMD 锐龙 AI PRO 处理器的 PC 对其 Generate AI 平台进行了优化,同时使用 AMD Lemonade Server 加速本地 LLM 开发,并降低工程资源需求。 - 结果:
Generate 可在搭载 AMD 锐龙 AI PRO 处理器的 PC 上以约 60-80 Token/秒的速度运行 320 亿参数、32K 上下文窗口的私有模型,将波动的云 Token 支出转变为固定资本支出,同时将数据保留在设备本地。 - AMD 技术一览:
AMD 锐龙 AI PRO 处理器
AMD Lemonade Server
资源

随时掌握最新动态
了解 AMD 最新动态
需要进一步了解适合贵公司的 AMD 解决方案?欢迎联系我们的团队,了解 AMD 如何为贵公司赋能助力。