Ist Ihre PC‑Flotte bereit für die Zukunft?
Erfahren Sie, wie AMD PRO IT‑Teams dabei unterstützt, sichere, verwaltbare und geschäftsfähige PC‑Flotten aufzubauen.

Fallstudie Iterate.ai
Iterate.ai nutzt AMD Ryzen™ AI PRO Prozessoren für private 32B-LLMS mit 32k-Kontextfenstermodellen bei ~60-80 Token/s und senkt dadurch Cloud-Kosten und -Risiken.
Iterate.ai nutzt AMD Ryzen™ AI PRO Prozessoren für private 32B-LLMS mit 32k-Kontextfenstermodellen bei ~60–80 Token/s und senkt dadurch Cloud-Kosten und -Risiken.
Iterate.ai nennt sich selbst „das Unternehmen für private KI“. Während Unternehmen generative KI (GenAI) einsetzen, um die Produktivität zu steigern, konzentriert sich Iterate.ai auf ausgeklügelte Workflows, die sicher innerhalb der Unternehmensgrenzen ausgeführt werden. Mit der Generate-Anwendung können große Unternehmen personalisierte KI‑Assistenten und agentische Workflows erstellen, die effizient komplexe Daten analysieren, die über kritische Geschäftssysteme wie Jira, Slack und Salesforce verteilt sind.
Mit dem Ziel, leistungsstarke lokale KI‑Funktionen bereitzustellen und gleichzeitig Datenoffenlegung zu verhindern, arbeitete Iterate.ai eng mit AMD zusammen, um Generate exklusiv für AMD Ryzen™ AI PRO Prozessoren zu optimieren. Dank dieser Zusammenarbeit kann Generate die CPU, die integrierte GPU und die dedizierte NPU der AMD Ryzen AI PRO Prozessoren parallel nutzen. Indem die Lösung auf Benutzergeräten ausgeführt wird, bietet Iterate.ai 100‑prozentige Datenaufbewahrung und -kontrolle und kann Unternehmen gleichzeitig dabei unterstützen, variable Cloud-Tokenkosten in vorhersehbare Fixkosten zu verwandeln.
IT‑Entscheidungsträger achten sowohl auf Performance als auch auf Sicherheit. Die Umstellung auf KI bringt neue Sicherheitsbedenken mit sich, da viele Unternehmen Schwierigkeiten haben, das Risiko zu managen, dass vertrauliche, firmeneigene Informationen an öffentliche Large Language Models (LLMs) übertragen werden.
„Die größte Herausforderung, die Generate bewältigt, ist die Sicherheit“, erklärt Iterate.ai Special Project Engineer Karanbir Singh. „Wenn Unternehmen ein öffentliches LLM verwenden, haben sie keine Kontrolle über die Daten, die darin aufbewahrt werden. Iterate.ai führt die KI‑Modelle direkt neben der Anwendung auf Ihrem lokalen Gerät aus, sodass keine Daten ins Internet übertragen werden.“
Eine weitere Herausforderung sind die Kosten. Hierzu Brian Sathianathan, Mitgründer und CTO von Iterate.ai: „Jüngste Branchenstudien zeigen, dass die Tokennutzung im letzten Jahr um das 100‑Fache gestiegen ist.“ Cloudbasierte LLM‑Inferenz wird pro Token abgerechnet, was zu einer hohen Variabilität und Kostenunsicherheit für Unternehmensbudgets führt. Iterate.ai wollte Unternehmen in die Lage versetzen, ihre KI‑Workflows weg von diesem nutzungsbasierten Modell zu verlagern und gleichzeitig vollständige Datenhoheit zu gewährleisten. Zudem muss die Lösung offline funktionieren, damit Benutzer KI auch auf Reisen oder bei Verbindungsproblemen weiterhin nutzen können.
Iterate.ai wählte AMD aufgrund seines umfassenden Technologie-Stacks aus, der die Skalierbarkeit und Flexibilität bietet, die für das Unternehmensprodukt erforderlich sind. „Was uns von AMD überzeugt hat, ist das Notebook-Angebot mit leistungsstarken Prozessoren, die CPU-, GPU- und NPU‑Funktionen umfassen. Gleichzeitig bietet AMD auch leistungsstarke serverseitige Lösungen wie die AMD Instinct™ MI300‑Serie GPUs“, erklärt Sathianathan. „Mit AMD erhalten wir eine End‑to‑End-Lösung vom Client bis zum Server. AMD bietet die richtigen Voraussetzungen, um die Revolution rund um private KI zu unterstützen, und ist damit der ideale Partner für Iterate.ai.“
Iterate.ai integrierte AMD Lemonade Server, ein Open‑Source-Tool, das die Entwicklung rund um lokale LLMs vereinfacht. „Lemonade Server stellt alles mit OpenAI-Kompatibilität bereit, dem derzeitigen Branchenstandard. Die Arbeit, die AMD in Lemonade Server steckt, erleichtert die Integration zwischen unserer Anwendung und dem LLM erheblich“, so Sathianathan.
Der optimierte Ansatz beschleunigte die Bereitstellung von Iterate.ai und reduzierte gleichzeitig den Ressourcenbedarf. Hierzu Sathianathan: „Wir hätten mindestens doppelt so viele Techniker gebraucht, wenn wir die ganze Arbeit selbst hätten erledigen müssen. Die Kombination aus AMD Software und Hardware ist unglaublich stabil und ermöglicht es uns, die Entwicklung mit viel weniger Ressourcen durchzuführen, als in der Regel auf LLM‑Seite erforderlich sind.“
Dank der High‑Performance-Architektur der AMD Ryzen AI PRO Prozessoren konnte Iterate.ai eine lokale KI‑Anwendung mit größerer Kapazität entwickeln, als es zuvor möglich war. Generate verwendet alle drei Komponenten der AMD Ryzen AI PRO Prozessoren, um optimale Performance zu erzielen: CPU, GPU und NPU. Diese parallele Architektur ist wichtig, da Generate verschiedenste Anwendungsfälle unterstützt: von einfacher Dokumentzusammenfassung bis hin zu hochkomplexen Diagrammanalysen.
Die koordinierte Hardwarebeschleunigung ist entscheidend für Energieeffizienz und Akkulaufzeit. Sathianathan hebt die Vorteile der spezialisierten NPU hervor: „Die AMD Ryzen AI NPU ist darauf optimiert, das LLM über lange Zeiträume auszuführen, weshalb sie sich perfekt für sehr komplexe Aufgaben eignet. Bei PCs sind Arbeitsspeicher und andere Ressourcen eingeschränkt. Deshalb nutzen wir die verschiedenen Leistungsprofile von NPU, GPU und CPU. Die Möglichkeit, alle Chipressourcen der AMD Ryzen AI PRO Prozessoren parallel zu nutzen, ist für uns ideal. Und dieser Ansatz trägt außerdem dazu bei, dass der Notebookakku während einer intensiven LLM‑Verarbeitung nicht zu schnell leer geht.“
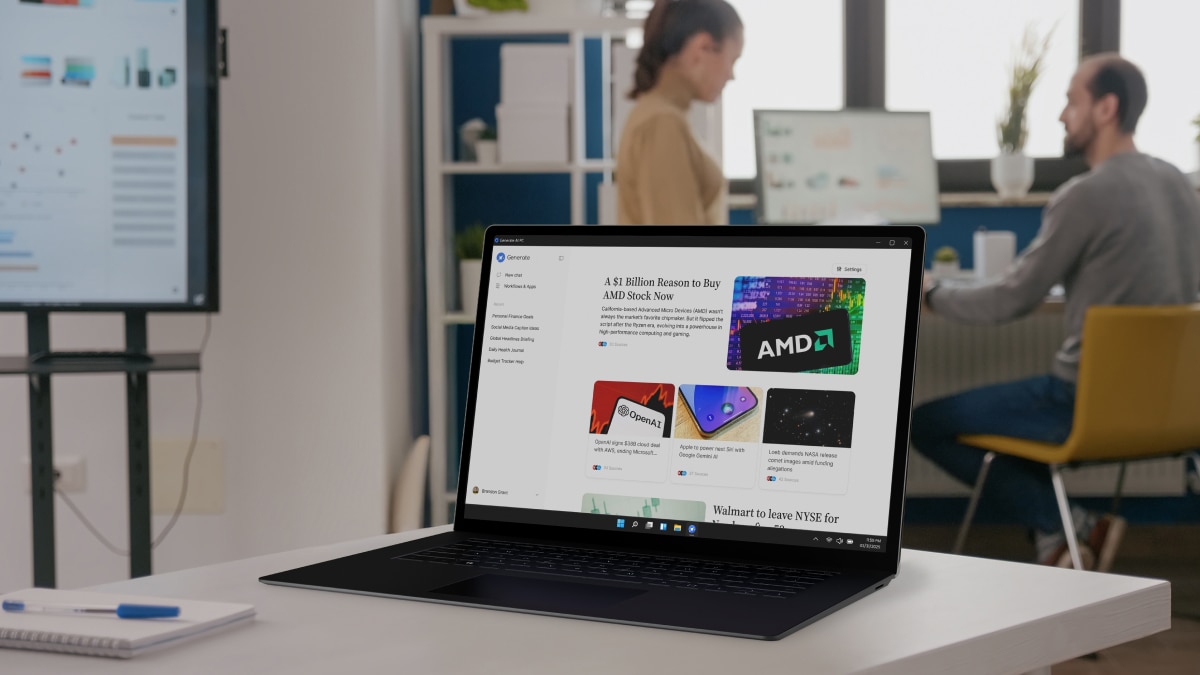
Laut Sathianathan ist die Bereitstellung von Iterate.ai auf der AMD Plattform entscheidend, um die Anforderungen moderner Unternehmen zu erfüllen. „AMD trägt dazu bei, lokale KI mit Sicherheits-, Datenschutz- und Kostenvorteilen zu nutzen, und schafft so Gewissheit für Unternehmen“, erklärt er.
Und diese Gewissheit wird durch messbare, überlegene Performance weiter unterstützt: Tests von Iterate.ai haben bestätigt, dass die AMD Plattform eine herausragende Modellskalierung ermöglicht. „Laut Branchenstandard sind Modelle mit 14 Milliarden Parametern und einem Kontextfenster von 16.000 Token ein guter Benchmark für einen KI‑PC“, so Singh. „Doch mit AMD Ryzen AI Prozessoren können wir Modelle mit 32 Milliarden Parametern – also mehr als doppelt so groß – und einem Kontextfenster von 32.000 Token nutzen.“
Dank dieses Skalierungsvorteils kann Iterate.ai anspruchsvollere Workloads lokal auf dem PC verarbeiten. Testmetriken bestätigen den hohen Durchsatz des Iterate.ai Modells, das in dem System ausgeführt wird: Sein Interplay-RAG‑Modell erreichte einen durchschnittlichen Durchsatz von etwa 60–80 Token/Sekunde – mit einer Spitzenleistung von 92,89 Token/Sekunde während einer Dokumentsuche.
„Indem Generate lokal ausgeführt wird, sind Kosten zu 100 % fix“, erklärt Sathianathan. „So entfällt ein hoher Anteil der variablen Kosten, weil es sich um einen einmaligen Investitionsaufwand handelt, der sich im Grunde über die Lebensdauer des PCs amortisiert.“
Da Generate das gesamte LLM‑Gedächtnis auf dem PC speichert, unterstützt die Anwendung außerdem die Datenhoheit und hilft Unternehmen so, Compliance-Standards wie HIPAA, DSGVO und SOC 2 einzuhalten. Dieser datenschutzorientierte Ansatz wird durch AMD PRO Security verstärkt, das mehrschichtige Schutzmaßnahmen wie AMD Memory Guard bietet. AMD Memory Guard verschlüsselt den Systemspeicher in Echtzeit, um vertrauliche Geschäftsdaten zu schützen, sollte ein PC verloren gehen oder gestohlen werden.
Iterate.ai plant bereits die Optimierung seiner Anwendung für die nächste Generation von AMD Prozessoren. Singh hebt die AMD Roadmap und die Partnerschaft mit dem Anbieter hervor: „In den nächsten 12 bis 18 Monaten besteht das Ziel darin, noch größere LLMs mit größeren Kontextfenstern zu nutzen, um immer mehr Kundenanwendungsfälle zu unterstützen“, erklärt er. „AMD verfolgt eine großartige Vision für die Zukunft und wir freuen uns, auch weiterhin mit dem Unternehmen zusammenzuarbeiten, damit wir neue Möglichkeiten nutzen und diese Anwendungsfälle entwickeln können.“
Iterate.ai ist ein Softwareunternehmen mit Innovationsfokus, das seinen Hauptsitz in San Jose, Kalifornien, hat und KI‑Plattformen und -Anwendungen für große Unternehmen entwickelt. Iterate.ai stellt unter anderem Interplay, eine patentierte Low‑Code-KI‑Plattform, sowie private KI‑Lösungen wie Generate bereit. Sie unterstützen Unternehmen in allen Branchen, einschließlich Einzelhandel, Finanzdienstleistungen und Technologie, dabei, schnell sichere GenAI‑Erlebnisse aufzubauen, bereitzustellen und zu skalieren. Weitere Informationen finden Sie unter iterate.ai.

Sie brauchen weitere Informationen über AMD Lösungen für Ihr Unternehmen? Unser Team zeigt Ihnen, wie AMD Ihr Unternehmen unterstützen kann.
Was braucht es, um KI in den Mittelpunkt der pharmazeutischen Forschung zu rücken? In diesem Interview erzählt Heikki Käsnänen, Head of Molecular Inte…
September 17, 2026
Meteomatics verdoppelte seine Leistung zum gleichen Preis für seine stündlichen EURO1k-Wettervorhersagen mit NEC-Servern mit AMD EPYC CPUs der 4. Gene…
July 09, 2024
Zyphra demonstriert das komplette AMD KI-Training, indem es sein Modell ZAYA1-8B von Grund auf über 1.536 AMD Instinct™ MI300X GPUs mit AMD Pensando P…
August 19, 2026
Rubrik, ein Unternehmen für Security und AI Operations, hat die Cybersicherheit dank AMD EPYC™ CPUs verbessert und dadurch Performance, Kosteneinsparu…
May 08, 2026
Hitachi rechnet mit erheblichen Kosteneinsparungen und erweitert seine globale Device-as-a-Service-Infrastruktur mithilfe von AMD Ryzen™ PRO Prozessor…
May 10, 2026
Das BUD Ecosystem sorgt für das schnellere Training von Indiens erstem kommerziell nutzbaren Open-Source Indic LLM mit 40 % weniger GPUs auf Azure dan…
December 09, 2025
Xactly nutzt AMD EPYC™-basierte OCI-Instanzen, um Kunden- und Funktionswachstum für seine Lösungen für das Vertriebsleistungsmanagement zu ermöglichen…
September 29, 2023
Wego bewältigt durch Lösungen mit AMD EPYC™ Prozessoren mehr Such-Traffic ohne zusätzliche Kosten.
September 29, 2023
© 2026 Advanced Micro Devices, Inc. Alle Rechte vorbehalten. AMD, das AMD Pfeillogo, Instinct, Ryzen und deren Kombinationen sind Marken von Advanced Micro Devices, Inc. Andere Produktnamen in diesem Dokument dienen nur zur Information und können Marken ihrer jeweiligen Inhaber sein. Bestimmte AMD Technologien erfordern möglicherweise die Ermöglichung oder Aktivierung durch Dritte. Die unterstützten Funktionen können je nach Betriebssystem variieren. Bitte informieren Sie sich beim Systemhersteller über spezifische Funktionen. Keine Technologie oder kein Produkt kann vollständig sicher sein.
Alle Aussagen über Performance und Kosteneinsparungen stammen von Iterate.ai und wurden von AMD nicht unabhängig nachgeprüft. Performance und Kostenvorteile werden von verschiedenen Faktoren beeinflusst. Die hierin enthaltenen Ergebnisse sind spezifisch für Iterate.ai und möglicherweise nicht repräsentativ. GD-181
Die hier enthaltenen Angaben dienen ausschließlich zur Information und können ohne vorherige Ankündigung geändert werden. Obwohl dieses Dokument mit aller Sorgfalt angefertigt wurde, kann es technische Ungenauigkeiten, Auslassungen und typografische Fehler enthalten. AMD ist nicht verpflichtet, diese Informationen zu aktualisieren oder anderweitig zu korrigieren. Advanced Micro Devices, Inc. gibt keinerlei Zusicherungen bezüglich der Genauigkeit oder Vollständigkeit dieser Inhalte und übernimmt keinerlei Haftung oder stillschweigende Gewährleistungen für die Nichtverletzung von Rechten, Marktfähigkeit oder Eignung für bestimmte Zwecke bei Betrieb oder Nutzung von AMD Hardware, Software oder anderen hier beschriebenen Produkten. Mit diesem Dokument werden keinerlei gewerbliche Schutzrechte gewährt – weder ausdrücklich noch implizit oder durch eine Rechtswirkung. Die für Kauf oder Nutzung von AMD Produkten geltenden Bedingungen und Einschränkungen werden schriftlich zwischen den Parteien vereinbart oder in den Standard-Verkaufsbedingungen von AMD festgelegt. GD-18u.