


概要
最適化された GPU ソフトウェア スタック
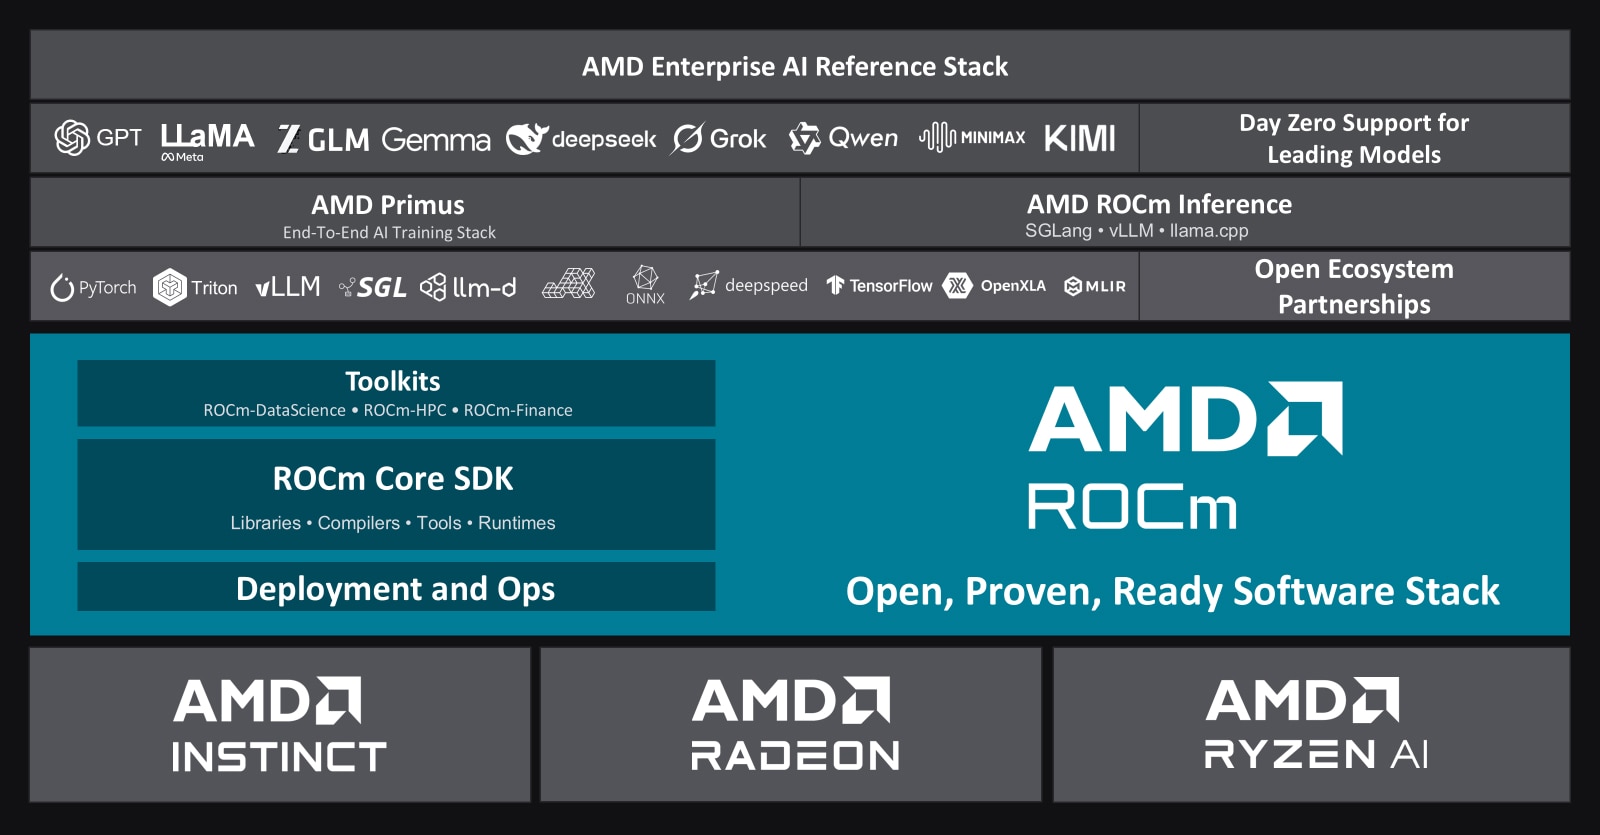
オープンなソフトウェア プラットフォームである AMD ROCm™ は、データセンター チームが GPU とノード全体で AI および HPC ワークロードを迅速にセットアップ、導入、拡張できるように支援します。開発者は使い慣れたフレームワークを使用して、パフォーマンスにとって重要なコードを調整できます。また、HIP を使用して既存の GPU アプリケーションやフレームワークを、サポートされている AMD ハードウェアに適合させることができます。
画像を拡大
← ビデオを視聴する
ROCm.AI: 開発スピードの向上とパフォーマンスの最適化
AI ネイティブの開発者エクスペリエンスにより、ROCm の開発を加速し、AI ワークロードの開発と最適化を簡素化し、AMD ハードウェア上でのパフォーマンスを最大化
開発
AMD ROCm ソフトウェアを使用した大規模な AI の構築、トレーニング、導入
AMD ROCm™ ソフトウェアは、オープン フレームワーク、最適化されたライブラリ、モデル ツール、スケールアウト インフラストラクチャを統合し、実験から本番環境まで AI 開発をサポートします。
構築
シンプルなモデル開発
AMD 向けに最適化されたコンテナーとワークフローを使用して PyTorch、TensorFlow、JAX で開発。Hugging Face から提供されている 300 万以上の人気のオープン モデルを利用できます。
トレーニング
AMD Primus - AI モデルを大規模にトレーニング
AMD Instinct™ GPU での事前学習、ファインチューニング、および分散学習には、AMD Primus と ROCm 通信ライブラリを使用します。
最適化
AI モデルの最適化と提供
モデルの最適化、重要な操作の迅速化、および高スループットの推論の導入には、AMD Quark、AITER、vLLM、SGLang を使用します。
デプロイ
AI インフラストラクチャ全体に展開
コンテナー、Kubernetes、Slurm、テレメトリ、ライフサイクル管理ツールを使用して、個々の GPU からマルチノード環境まで拡張できます。
AMD ROCm を使用した高パフォーマンス コンピューティングの構築、最適化、拡張、実行
AMD ROCm™ ソフトウェアは、HPC 開発者が科学アプリケーションを構築または移植したり、パフォーマンスをプロファイルして調整したり、単一の GPU からマルチノード実行に移行したりするのに役立ちます。
構築
科学アプリケーションの構築と移植
HIP または OpenMP® オフロードを使用して GPU アクセラレーション コードを開発し、Kokkos や Raja などの HPC フレームワークと連携し、また HIPIFY を使用して既存の CUDA® コードを変換します。
最適化
パフォーマンスのプロファイリングとチューニング
ROCm ツールを使用してカーネルとデータ移動をプロファイリングした後、線形代数、FFT、ソルバー、疎行列演算向けに最適化されたライブラリを使用します。調整しながら結果を検証します。
拡張
GPU とノード全体で拡張可能
分散アプリケーションには GPU 対応 MPI を使用し、GPU 主導の通信には rocSHMEM を使用して、GPU とノード数の増加に応じてパフォーマンスを測定します。
実行
HPC インフラストラクチャで実行
HPC コンテナーにアプリケーションをパッケージ化し、Slurm を使用してクラスター ジョブを送信します。ROCm は、El Capitan、Frontier、LUMI をはじめとする世界最高クラスのシステムで使用されています。
最新情報
ROCm 10.0: エージェント型 AI の時代に対応するために構築
アイコン
AMD の専門知識を活用して構築
AMD Skills は、厳選された AMD の知識と検証済みのワークフローを AI コーディング エージェントに提供します。これによって開発者は、既に使用しているツールでガイダンスを得ながら、AMD に最適化されたアプリケーションを構築できます。
アイコン
よりシンプルなワークフローで実行
ROCm CLI は、AMD ハードウェア上で AI ワークロードをセットアップ、管理、および操作するための統合インターフェイスを提供します。
アイコン
エンドツーエンドの推論を最適化
ROCm Hyperloom は、エージェント型 AI を使用して、ワークロードのプロファイリング、ボトルネックの特定、最適化の実装、ホスト コードと GPU カーネル全体のパフォーマンスの検証を実行します。
アイコン
モジュール式の ROCm Core SDK をベースに構築
ROCm Core SDK は、AMD プラットフォーム全体で AI ワークロードを構築、導入、最適化するためのモジュール式の基盤を提供します。
エコシステムとパートナー
先進的なフレームワーク、テクノロジ パートナー、開発者で構成された幅広いオープンな AI エコシステムにより、イノベーションを加速し、移植性を実現し、開発から本番環境に至るまで AI を拡張します。




対応ハードウェア

開発者リソース
よくある質問 (FAQ)
AMD ROCm™ は、サポートされている AMD GPU 上で AI およびハイパフォーマンス コンピューティング アプリケーションを開発するためのオープン ソフトウェア スタックです。AI モデルのトレーニングと提供、GPU アクセラレーション ソフトウェアの構築、GPU とノード全体での科学的ワークロードの実行に使用できます。
ROCm と CUDA は、別個の GPU コンピューティング プラットフォームです。ROCm は、サポートされている AMD GPU 向けのオープン ソフトウェア スタックを提供し、その HIP プログラミング モデルは CUDA ソース コードの移植パスを提供します。ツールと API は直接の互換性がないため、移行作業はアプリケーションとその依存関係によって異なります。
常にそうとは限りません。サポートされている AI フレームワークに基づいて構築されたアプリケーションは、ROCm 対応バージョンのフレームワークから開始できる場合があります。CUDA API を呼び出すコード、または CUDA 固有のライブラリに依存するコードには変更が必要な場合があります。HIPIFY は、サポートされている CUDA コードを HIP に変換するのに役立ちます。その後、開発者は正確性をテストし、必要に応じてパフォーマンスを調整する必要があります。
ROCm は、PyTorch、TensorFlow、JAX を使用した AI 開発と、vLLM、SGLang を使用したモデル サービングに対応しています。サポートされるバージョンは、ROCm リリースとシステム構成によって異なります。フレームワークのバージョンを選択する前に、最新の互換性マトリックスを確認してください。
まず、GPU とオペレーティング システムの互換性マトリクスを確認します。その後、AMD のインストール ガイドに従って設定します。AMD Infinity ハブは事前に設定されたコンテナーを提供し、ROCm CLI はサポートされているシステムのセットアップと診断を支援します。拡張する前に、サンプル ワークロードを実行して環境を確認してください。
最新の ROCm ニュースが届きます。
脚注
©2024 Advanced Micro Devices, Inc. All rights reserved.AMD、AMD Arrow ロゴ、AMD ROCm、AMD Instinct、EPYC、Radeon Instinct、およびこれらの組み合わせは、Advanced Micro Devices, Inc. の商標です。PyTorch は、PyTorch の商標または登録商標です。この資料に使用されているその他の製品名は識別目的のみに使用されており、所有するそれぞれの企業の商標である可能性があります。
- ROCm でサポートされている Radeon パーツの全リストは、https://rocm.docs.amd.com/en/latest/reference/gpu-arch-specs.html で閲覧できます。